双卡 7900 XTX 从零部署 125B 大模型:48GB 显存满血跑通 256K,首字延迟腰斩至 22.9 秒
测试平台:AMD Ryzen 7 3700X · 2 × RX 7900 XTX 24GB(PCIe 4.0 x8 + x8 实测)· 94GB DDR4 · Ubuntu 24.04.4 · ROCm 7.2.4
推理引擎:Strata RDNA3 fork(锁定 commite1dad2dc,张量并行 + 双路预填充)
被测模型:Qwen 125B MoE · Swift IQ3_S(46.8GB)/ Unsloth UD-IQ4_XS(56GB)
本文性质:从全新 Ubuntu 到双卡服务跑通的完整部署教程,所有命令与配置均来自真机实测,照抄可复现适合谁:想在消费级平台上私有化部署千亿模型、跑超长上下文 Agent 的开发者和装机玩家
预期耗时:全程约 2~4 小时(模型下载占大头;编译约 15 分钟)
前置技能:会用终端、能装 Ubuntu,仅此而已
先看结果:照着搭完,你能得到什么
社区长期流传”消费级显卡组双卡跑大模型是智商税”。这套方案用真机实测回答:只要引擎和并行架构选对,两张 7900 XTX 就是把同一个千亿模型的计算任务切碎了协同计算,1+1>1.8。
照本文部署完成后,你的机器可以达到(同平台对照,3 轮中位数,temp=0):
| 指标 | 单卡 | 双卡(本教程目标) | 加速比 |
|---|---|---|---|
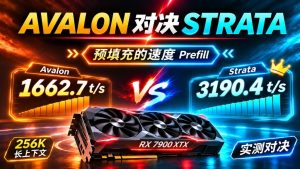
| 128K Prefill 吞吐 | 3,148.4 tok/s | 5,748.5 tok/s | 1.83x |
| 128K 首字延迟 TTFT | 41.752 s | 22.917 s | 1.82x |
| 32K Decode 生成 | 88.6 tok/s | 133.7 tok/s | 1.51x |
| 256K(261,632 tok)Prefill | — * | 5,766.9 tok/s | — |
*256K 档位未做单卡对照(不在本次测试范围),如需单卡 256K 数据请自行按第六步规程补测。
配套能力:256K 满血上下文大海捞针 100% 召回、全程 零 OOM 零崩溃、长输出扫描单次峰值 210.35 tok/s(推测解码高命中场景)。整套平台成本只是专业算力卡的零头。
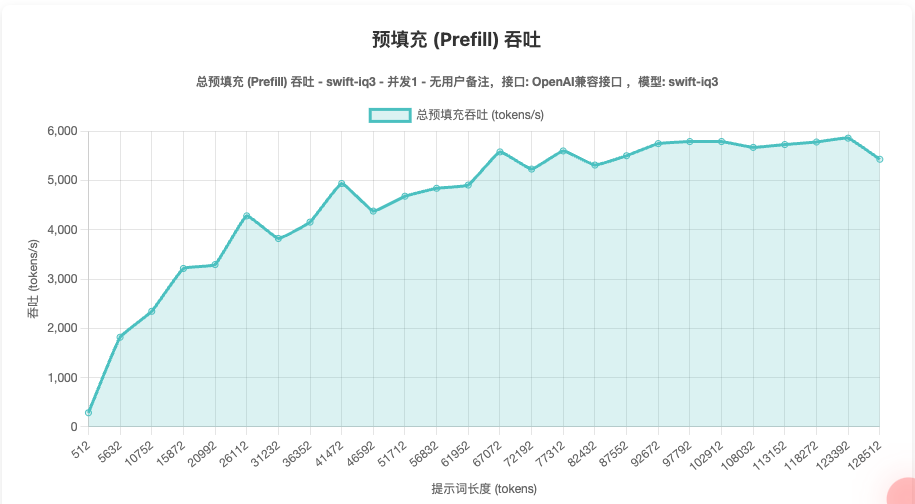
(图 1:128K 预填充吞吐实测,双卡较单卡提速 83%)
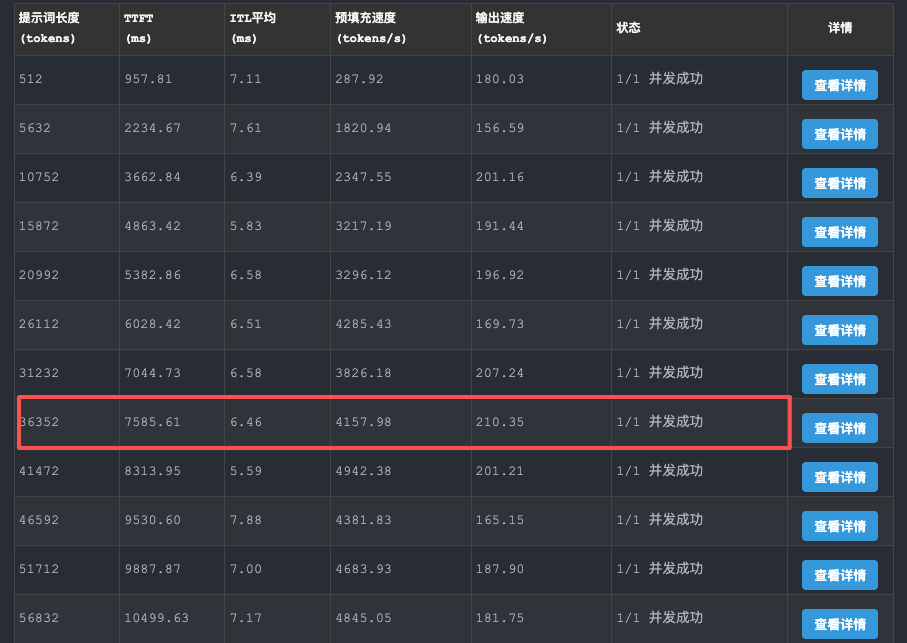
(图 2:长输出扫描峰值成绩,属推测解码高命中场景的特定峰值,非稳态速度)
下面开始动手,共六步 + 一份踩坑清单。
第一步:硬件选型与装机避坑(BOM 账本)
组双卡推理工作站,瓶颈不在 CPU,而在总线带宽、显存、内存与供电散热。
| 配件 | 推荐规格 | 关键避坑 |
|---|---|---|
| 显卡 | 2 × RX 7900 XTX 24GB(gfx1100) | 24G 显存 + 384-bit 位宽,双卡组成 48GB 池 |
| 主板 | 支持 x8+x8 或双 x16 拆分(X570 / B650 / X670E) | 最大踩坑点:第二张卡绝不能插在走芯片组(PCH)的 x4 槽上,跨卡通信带宽直接砍到 1/4。两张卡必须直连 CPU——x8+x8 够用(本机实测即 x8),x4 会毁掉双卡收益 |
| CPU | R7 3700X / 5700X / 7700X 级即可 | 不需要多路 U:98% 专家缓存命中率下,无 AVX-512 的老 3700X 照样跑出 5,700+ tok/s |
| 内存 | ≥ 96GB(64GB 起步) | IQ3 峰值 73.91GB,IQ4 峰值 83.16GB——差 9GB 就是”流畅”和”OOM 边缘”的差别 |
| 电源 | 1000~1200W 金牌 | 双卡满载 2×303W。每张卡的 8-pin 必须独立直连电源,严禁一分二转接线 |
| 散热 | 3 槽厚卡双插机箱或开放测试架 | 双卡紧贴上卡会被烤到降频,卡间留 1~2 槽空隙或加进风扇 |
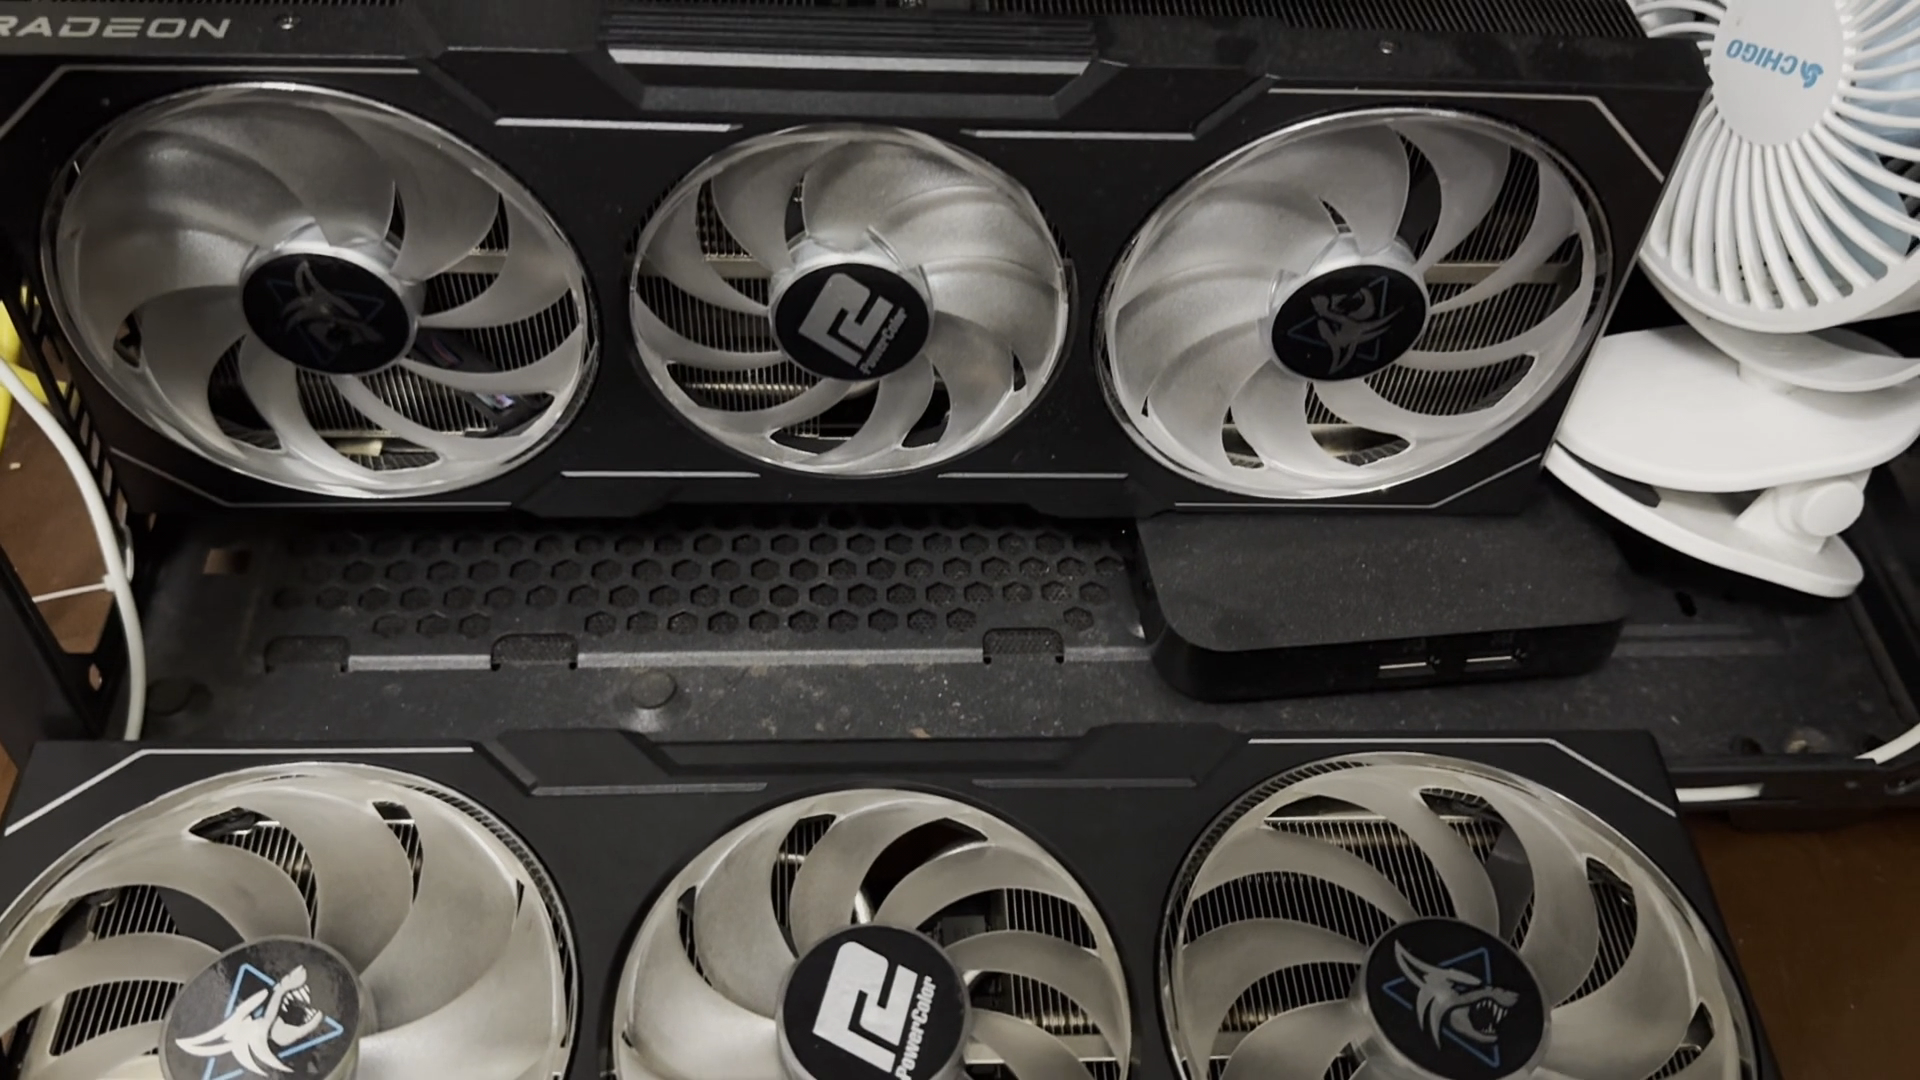
(图 3:双卡实装俯拍——两张 RX 7900 XTX 各占一条 PCIe 4.0 插槽,卡间保留散热间隙;实拍画面可见上卡 RADEON 标识)
第二步:系统安装与双卡环境验证
推荐 Ubuntu 24.04 LTS(22.04 亦可),内核自带 amdgpu 驱动。装好系统先验证双卡状态,这一步不对,后面全白搭:
# 确认两张 7900 XTX 都被识别
lspci | grep -i vga
# 期望看到两条 RX 7900 XTX 记录

# 逐张验证 PCIe 链路速率(地址换成你自己的)
sudo lspci -vv -s 03:00.0 | grep LnkSta
sudo lspci -vv -s 0c:00.0 | grep LnkSta
# 关键行:LnkSta: Speed 16GT/s, Width x16 或 x8
# x8+x8 拆分完全可接受(本机实测即为 GEN 4@8x,不影响张量并行)
# 若显示 Width x4 或 Speed 8GT/s —— 查 BIOS 是否开启 x8+x8 拆分,别往下走

# 安装监控工具,确认双卡在位
sudo apt install -y rocm-smi build-essential git
rocm-smi   # 应列出 GPU0、GPU1 两张卡
ROCm 说明:本教程的引擎编译脚本会自动在虚拟环境里安装所需 ROCm 组件,无需提前手动装。如果你的发行版需要手动安装,按 AMD 官方源装
rocm-hip-sdk rocm-smi hipblaslt后,记得sudo usermod -a -G render,video $USER并重启。
第三步:编译 Strata RDNA3 引擎
先划清两条路径:上游官方 Strata(Niko1221/Strata)的 ./setup.sh 也能用双卡,但默认是流水线切分——跑不出本教程的张量并行成绩。要复现本文数字,必须用 RDNA3 深度优化 fork:
mkdir -p ~/AI/strata-rdna3-test && cd ~/AI/strata-rdna3-test

# 克隆 fork 并检出本期实测锁定的 commit(复现成绩的关键)
git clone --branch rdna3 https://github.com/nicejunjie/Strata-rdna3.git fork
cd fork
git checkout e1dad2dc     # ep16 实测锁定提交(含 AVX2-only 兼容修复,3700X 实测可用)

# 一键编译:固定版本工具链(ROCm / rocWMMA / llama.cpp)+ gfx1100 引擎
D="$HOME/AI/strata-rdna3-test/data"
mkdir -p "$D"
./setup.sh --setup --build --backend hip --family qwen --model IQ3_S \
  --vision cpu --data-dir "$D" --no-start --yes

# 验证编译产物:backend 必须是 hip,archs 必须包含 gfx1100
cat engine/BUILD.json
编译约 10~20 分钟,仅需一次。
第四步:下载模型与生成 Experts Pack
跑千亿 MoE 的精髓:把专家权重打包成针对 RDNA3 高速吞吐的专用二进制包。
模型二选一:
| 模型 | 打包后体积 | 适合 | 内存峰值 |
|---|---|---|---|
ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF(IQ3_S)推荐 |
46.8GB | 日常对话、生成速度优先 | 73.91GB |
Qwen3.8-Flash-Next-UD-IQ4_XS(Unsloth,3 分片) |
56GB | 代码、数学等高精度场景 | 83.16GB |
cd ~/AI/strata-rdna3-test/fork
D="$HOME/AI/strata-rdna3-test/data"

# 从 HuggingFace 或国内镜像 hf-mirror.com 下载 IQ3_S 两个分片
# (分片体积以下载页面实际为准;断点续传,中断后重跑同一命令即可)
# 存放到 $D/models/swift-IQ3_S/ 目录,两个分片缺一不可

# 生成 Experts Pack(约 46.8GB experts.bin)
export STRATA_GGUF_PY="$PWD/third_party/llama.cpp/gguf-py"
.venv/bin/python tools/iq_pack.py \
  --gguf "$D/models/swift-IQ3_S/Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf" \
  --out "$D/packs/swift-iq3_s" --experts-bin

# 确认产物
ls -lh "$D/packs/swift-iq3_s/experts.bin"
第五步:双卡配置与一键启动(核心)
先用一句话讲清这套配置在干什么:--tensor-parallel 2 把模型参数矩阵切碎、两张卡各算一半,每层通过 PCIe 交换一次部分结果——这是”一道数学题两人分工”,不是”开两个窗口各跑各的”。长文本预填充再叠加 DP/TP 双路并行,128K Prefill 才能从 3,148 冲到 5,748 tok/s。
配置文件 rdna3/configs/swift-iq3-2gpu.json(关键字段已注释):
{
 "exe": "@STRATA@/engine/strata",
 "cwd": "@STRATA@",
 "tokenizer": "@DATA@/packs/swift-iq3_s/tokenizer",
 "model_name": "swift-iq3",
 "backend": "hip",
 "gpu": [0, 1],
 "layer_split": "auto",
 "host": "0.0.0.0",
 "port": 18088,
 "open_browser": false,
 "args": [
  "--pack",           "@DATA@/packs/swift-iq3_s",        // 第四步生成的专家包
  "--native",         "@DATA@/models/swift-IQ3_S/Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
  "--tensor-parallel", "2",                              // 双卡张量并行(核心)
  "--prefill",        "auto",
  "--max-context",    "262144",                          // 要跑 256K 必须给到 262144
  "--kv",             "int8",                            // KV 缓存 8-bit:48GB 塞下 256K 的必备开关
  "--kv-resident",    "32768",                           // 前 32K 常驻显存,超出部分 pinned 内存流式置换
  "--expert-cache",   "auto",                            // 专家缓存自动填满双卡显存(48GB 吃满的关键)
  "--vram-reserve-mib", "512",
  "--pool-workers",   "8",                               // 按 CPU 核数设:3700X 为 8
  "--mtp-q4",         "all",
  "--spec",           "4",                               // 推测解码窗口
  "--spec-min-p",     "0.5"
 ],
 "env": {
  "STRATA_HIPBLASLT_TUNING": "@STRATA@/tools/hip/gfx1100-hipblaslt-100202.txt",
  "STRATA_DP_PREFILL": "1",      // 数据并行预填充:长文档分段同时灌入两卡
  "STRATA_TP_PREFILL": "1",      // 张量并行预填充:预填充阶段也切分
  "STRATA_HIP_WMMA":   "1",      // RDNA3 WMMA 矩阵核加速
  "STRATA_SELECT_WMMA": "1",
  "STRATA_PEER_TRANSPORT": "host",  // 跨卡走 P2P host 通道(无 NVLink 平台的正确姿势)
  "GPU_MAX_HW_QUEUES": "8"       // 保持双卡满载(以 fork 文档 RDNA3_SETTINGS.md 为准)
 }
}
三个开关(
--tensor-parallel 2+STRATA_DP_PREFILL+STRATA_TP_PREFILL)缺一不可:只开 TP 不开双路预填充,128K Prefill 只能回到 3,148 tok/s 的水平。
启动:
cd ~/AI/strata-rdna3-test/fork
D="$HOME/AI/strata-rdna3-test/data"
.venv/bin/python rdna3/run.py swift-iq3-2gpu --data "$D" --gpus 0,1
约 48 秒加载完成后,服务在 http://127.0.0.1:18088/v1 提供 OpenAI 兼容 API。
验证双卡真的在协同(新手最容易翻车的检查点):
# 另开终端:双卡显存都应涨到 23GB+,功耗同步拉到 250~300W
watch -n 1 rocm-smi

# 快速问答测试
curl http://127.0.0.1:18088/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "swift-iq3", "messages": [{"role": "user", "content": "用Python写一段并行质数查找代码"}], "temperature": 0.6, "max_tokens": 1024}'
只有一张卡在动 = 双卡没生效,回头检查 --gpus 0,1 和 TP 开关。
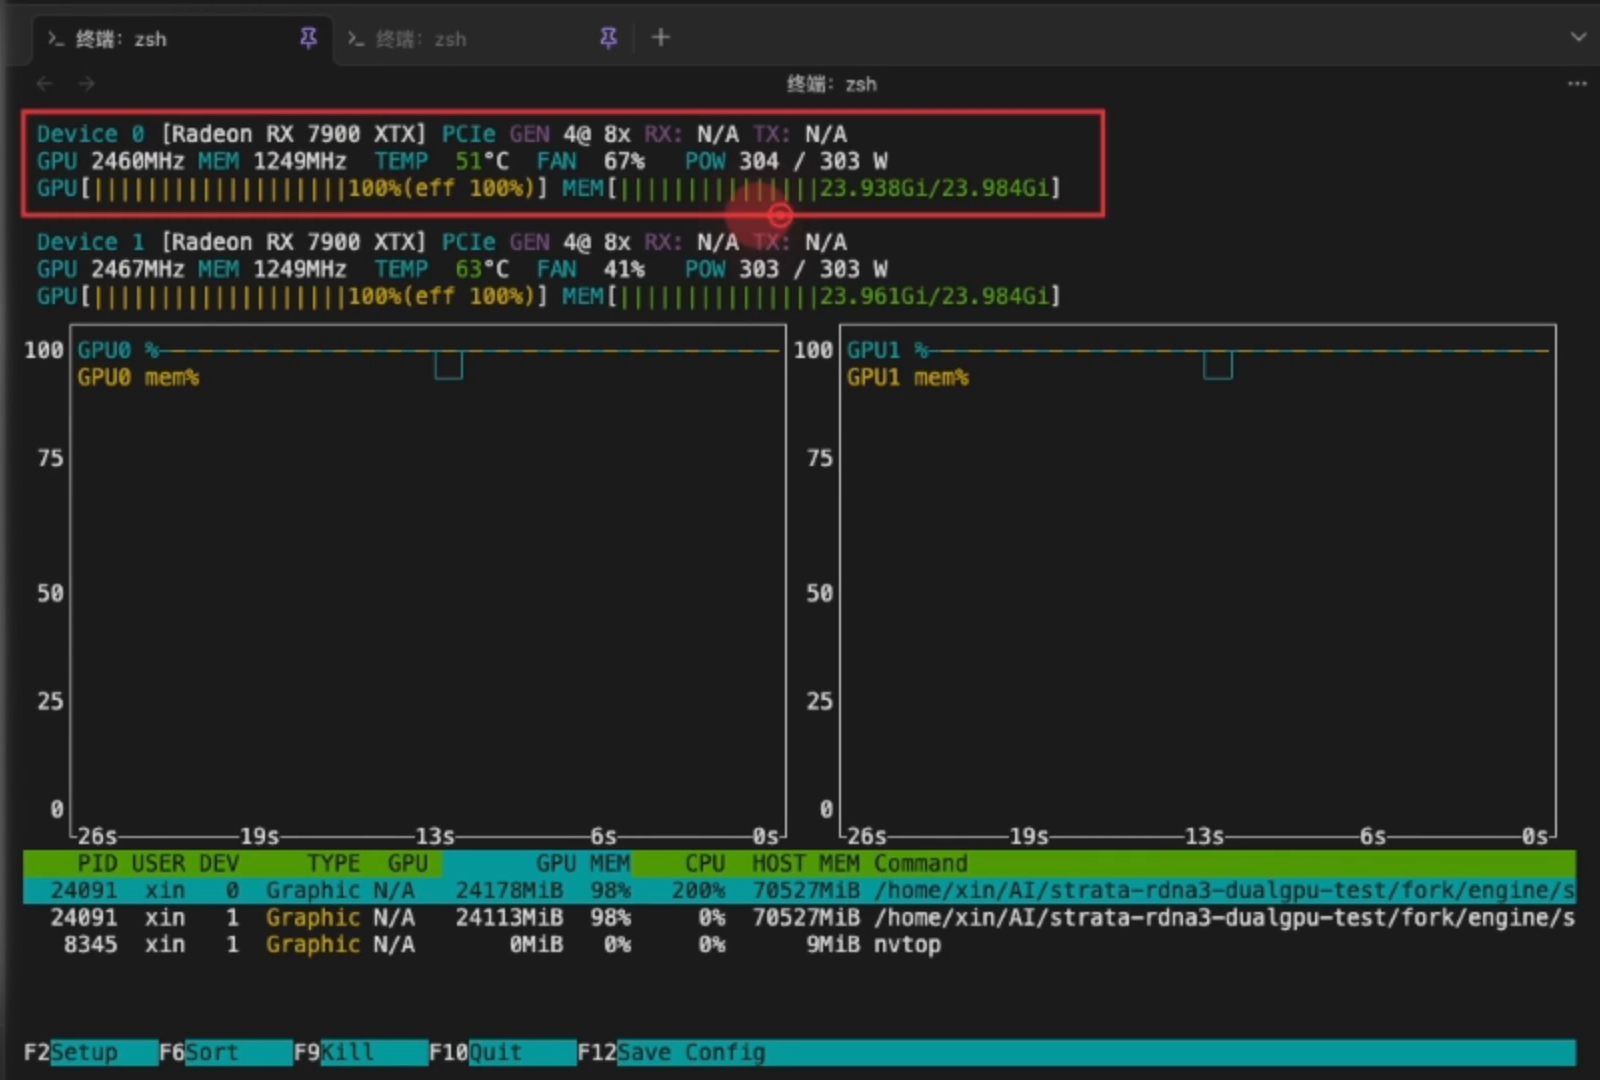
(图 4:部署成功后的 nvtop 实时监控——双卡功耗同步 303~304W、显存各吃掉 23.94/23.96 GiB、GPU 利用率双 100%,证明模型确实被切成两半分摊到两张卡上)
第六步:跑基准,验证部署达标
部署完成 ≠ 部署正确。按本规程复测,与目标成绩对照:
复现规程(与本期视频完全一致,规程不同数字没有可比性):
- 每档上下文:1 轮预热 + 3 轮正式,取中位数
- 固定
temp=0、seed=42、单次输出 256 tokens、关闭 prompt cache - 档位递进:32K → 128K → 256K(261,632 tokens)
- 也可以直接跑官方
./bench.sh出自己机器的报告
目标对照表(3700X + 94GB DDR4 平台实测):
| 档位 | 指标 | 双卡目标值 |
|---|---|---|
| 32K | Prefill / Decode / TTFT | 5,275.6 tok/s / 133.7 tok/s / 6.25s |
| 128K | Prefill / Decode / TTFT | 5,748.5 tok/s / 133.7 tok/s / 22.9s |
| 256K | Prefill / Decode / TTFT | 5,766.9 tok/s / 119.3 tok/s / 45.3s |
| 256K | 大海捞针(首/中/尾三秘钥) | 100% 召回 |
| 256K | 稳定性 | 3 轮 0 OOM 0 报错 |
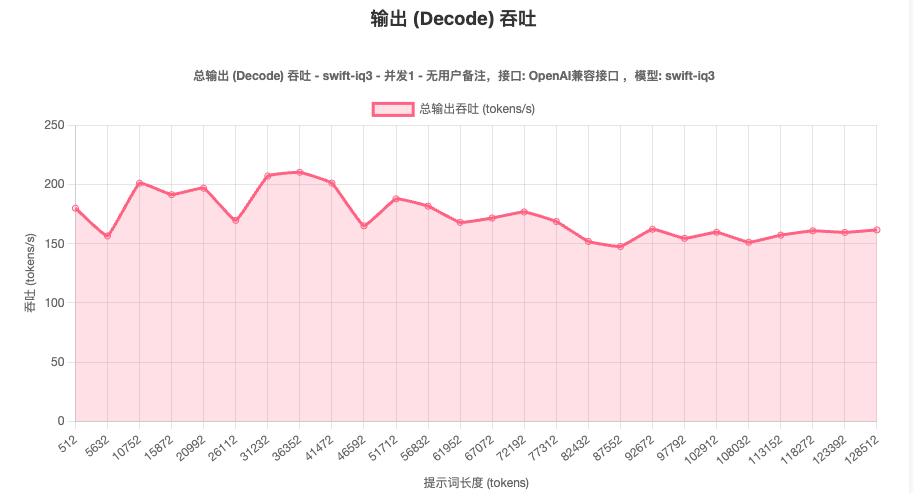
(图 5:Decode 速度走势——各档位持续吐字稳定性)
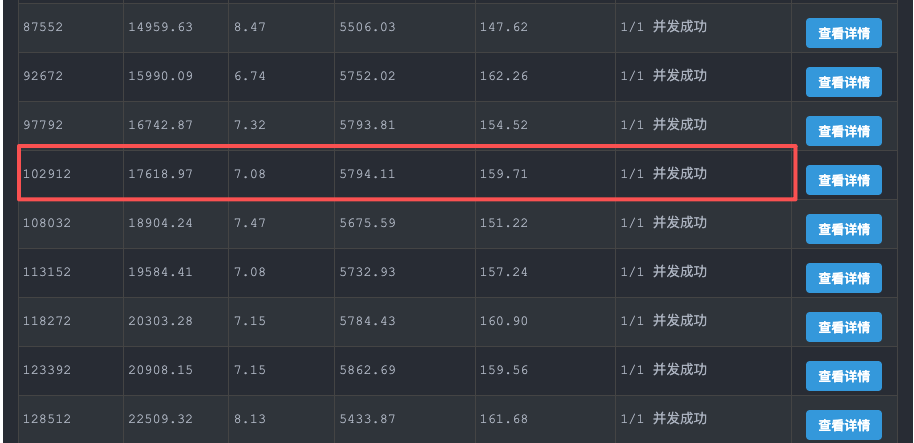
(图 6:极端长文本输出测试,102K/128K 档位成绩表)
成绩边界声明(防杠):Prefill 对 CPU/内存平台敏感——fork 作者在 9950X3D2 + DDR5 平台可跑出 6,700+ tok/s,本表为 3700X + DDR4 平台成绩。你的复现数字在 ±20% 内都属正常;加速比(1.83x)比绝对值更有参考意义。另外别拿冷启动成绩对比:48 秒加载 + 1 轮预热之后才是真实性能。
换高精度版:把第四步换成 IQ4 模型重打专家包、配置照抄改路径即可。128K 下 IQ4 Prefill 反而更快(5,881.3 tok/s、TTFT 22.4s),代价是 Decode 降到 114 tok/s、内存峰值 83GB。选型一句话:求速度选 IQ3,求代码/数学精度选 IQ4。
踩坑清单(每条都对应真实物理约束,部署失败先查这里)
- PCIe 拓扑第一杀手:第二张卡插了芯片组 x4 槽 → 跨卡带宽砍到 1/4,双卡速度和单卡差不多。用第一步的
lspci命令检查,BIOS 开 x8+x8 - 128K 以上必须
--kv int8:不加的话 KV Cache 显存暴涨直接 OOM 崩溃 - 内存不足会被系统 OOM Killer 强杀:
free -h确认可用物理内存;不足 64GB 时预挂 NVMe Swap 兜底:sudo fallocate -l 64G /swapfile && sudo chmod 600 /swapfile && sudo mkswap /swapfile && sudo swapon /swapfile - 显存余量为零是常态:
--expert-cache auto会把两卡填到 99.8%~99.9%,推理机别开桌面浏览器抢显存 - 冷启动成绩不算数:48 秒加载 + 预热之后才测
- IQ4 比 IQ3 多吃 9GB 内存:83.16GB vs 73.91GB
max-context要够:跑 256K 前确认 ≥ 262144,否则 26 万 token 塞不进去- 散热别省钱:双卡 303W 持续满载,风道不足降频后吞吐肉眼可见地飘
总结
- 协同是真的:TP=2 + 双路预填充下,128K 预填充提速 83%、TTFT 腰斩省近 20 秒——诚实地说不到 2.0x 无损翻倍(跨卡 AllReduce 通信开销是物理天花板),但远超”各跑各的”
- 老平台扛得住:3700X 无 AVX-512 也没关系,98% 专家缓存命中率把内存带宽瓶颈旁路掉了
- 复现要锁定 commit:
e1dad2dc,跨版本对比无意义 - 测试满意后建议 systemd 守护(崩溃自动重启、给足冷启动超时),完整 unit 模板与构建补丁包可通过文末方式获取
本文配有完整真机实测视频(4 分 42 秒),实拍双卡满载运行与全部测试过程。
引擎构建补丁、systemd 模板与原始日志已打包,欢迎联系获取。
(图 7:文末名片二维码——与视频 S18 结尾一致)
数据来源:Strata RDNA3 双卡实测报告(Issue #108)、IQ4 补测报告(Issue #110)、final_report.json / iq4_report.json 全量基准、suite.log 运行日志。所有数字均为真机实测,欢迎按本文规程复现验证。
About The Author