RX 7900 XTX 单卡运行 Qwen3.8 Flash (125B):Avalon 与 Strata RDNA3 双引擎安装部署实战
玩客笔记 EP17 配套教程|Ubuntu 24.04 + ROCm 7.2.4|一张 RX 7900 XTX 24GB|Qwen3.8-Flash-Next 125B|IQ3 + MTP
更新:2026-11-05。 本文提供两个可操作的独立部署流程。若要精确复现视频跑分,请同时使用视频测试时的模型、源码提交和实际启动配置;仅仅安装成功不代表自动获得相同吞吐。
为什么这次要比较两套引擎?
同样一张 24GB 显存的 RX 7900 XTX,也能运行参数规模高达 125B 的 MoE 大模型。原因并非模型的全部权重都装进了显存,而是推理引擎把 GPU、CPU 和系统内存协同起来,只在每一步激活一部分专家。
这期视频使用两套已实测可运行的路线:Avalon + 专用 IQ3_KS Hybrid + 两步 MTP,以及 Strata RDNA3 + Swift 1.5 IQ3_S + 四步 MTP。它们的模型权重、量化与缓存优化不同,所以比较的是完整部署方案,而不是只改变一行推理引擎代码的严格同模型实验。
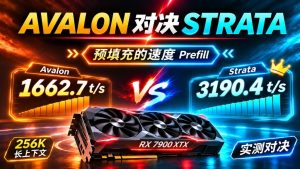
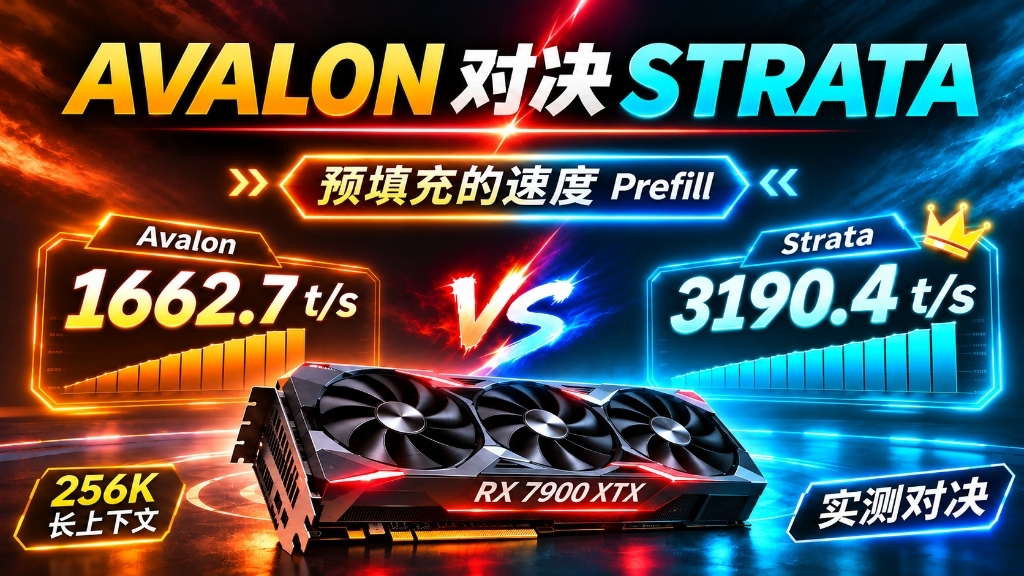
本期视频的本地实测报告显示:短提示持续生成中位数 Avalon 为 80.3 tokens/s,Strata 为 92.5 tokens/s;接近 256K 的输入下,Prefill 分别为 1,662.7 和 3,190.4 tokens/s,首字延迟从 156.4 秒大幅腰斩至 81.4 秒。而在真实端到端 Python 编程任务中,Avalon 则凭借更优的单次推理路径反超交卷。这些是本次具体主机与配置的实测回报,不是每个用户安装之后的保证速度。
1. 准备硬件、磁盘和系统
本次实测环境:
| 项目 | 视频实测配置 |
|---|---|
| GPU | AMD Radeon RX 7900 XTX 24GB(仅使用一张) |
| CPU | Ryzen 7 3700X(支持 AVX2) |
| 内存 | 约 94GB ~ 96GB DDR4(实测平台配置) |
| 系统 | Ubuntu 24.04.4 LTS,x86-64 |
| ROCm | 7.2.4 |
| 存储 | 推荐 NVMe SSD |
| 上下文 | 视频对照使用 262,144 tokens 的最大窗口 |
实际建议: 如果只安装一套,引擎、模型和缓存预留约 120–180GB 可用 SSD 空间比较稳妥;同时装两套并保留 Strata 专家 pack,建议至少 300GB 可用空间。实际占用取决于下载版本、临时文件和是否保留重复副本。64GB RAM 的机器可能也能运行,但本文的吞吐数字以约 94GB~96GB RAM 为条件;内存较小时可能频繁读盘,速度明显下降。
先检查机器,而不是直接下载将近百 GB 的模型:
cat /etc/os-release | head -n 6
uname -m
lscpu | grep -i avx2 | head -n 1
free -h
df -h "$HOME"
lspci | grep -Ei 'VGA|Display|AMD|Radeon'
command -v rocm-smi && rocm-smi
/opt/rocm/bin/rocminfo 2>/dev/null | grep -m 3 gfx1100
预期看到 x86_64、AVX2、RX 7900 XTX 对应的 gfx1100。如果 rocminfo 不存在或不能识别 GPU,先按照 AMD ROCm 7.2.4 Ubuntu 安装文档 配置 ROCm,不要直接在已有生产系统上盲目升级驱动。若提示 /dev/kfd 或 /dev/dri/renderD* 无访问权限,核对当前用户是否属于 render、video 组;调整组权限后需重新登录。
安装常见构建工具(在一台新 Ubuntu 机器上执行):
sudo apt update
sudo apt install -y git cmake ninja-build build-essential \
  python3 python3-venv python3-pip curl pciutils
mkdir -p "$HOME/AI"
为了避免同时运行时争抢 GPU,以下两套引擎一次只启动一个。为便于排查,示例端口 Avalon 为 8080,Strata 为 8081,均只监听本机 127.0.0.1。
2. 路线 A:部署 Avalon(专用 IQ3_KS + MTP)
2.1 获取并固定源码
官方项目:freriadoc/Avalon。与视频对照对应的源码提交为 9ff242b。不要直接拿未来的 main 版本跑出成绩,再与本期旧版本数据混比。
cd "$HOME/AI"
git clone https://github.com/freriadoc/Avalon.git
cd Avalon
git checkout 9ff242b
git rev-parse --short HEAD
2.2 用 ROCm 构建 llama-server
下面来自 Avalon 官方 HIP 构建路线,明确指定 RX 7900 XTX 的 gfx1100:
cd "$HOME/AI/Avalon"
cmake -S . -B build \
  -DGGML_HIP=ON \
  -DAMDGPU_TARGETS=gfx1100 \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_C_COMPILER=/opt/rocm/bin/amdclang \
  -DCMAKE_CXX_COMPILER=/opt/rocm/bin/amdclang++
cmake --build build -j"$(nproc)" --target llama-server
ls -lh build/bin/llama-server
如果提示找不到 amdclang,请先检查 /opt/rocm/bin 是否存在、ROCm 开发组件是否安装正确。不要在编译失败后自动改成 CUDA 构建:本教程是 AMD HIP 路线。若部分环境提示未定义 GGML_HIP,可尝试替换为兼容参数 -DGGML_HIPBLAS=ON。
2.3 下载 Avalon 专用模型和 MTP 文件
模型来源:freriadoc/Qwen3.8-Flash-Next-Avalon-GGUF。主模型由 33 个 GGUF 分片组成,另有 MTP sidecar 与 moe-cache-ranking.bin。必须下载完整,不能只拿第一个分片。 官方标注主模型约 89GiB,MTP 文件约 1.48GB。
先为 Hugging Face CLI 创建隔离环境:
python3 -m venv "$HOME/AI/hf-tools"
source "$HOME/AI/hf-tools/bin/activate"
python -m pip install -U 'huggingface_hub[cli]'
下载到固定目录(可使用 huggingface-cli download 或 hf download,网络中断可直接重试同一命令):
mkdir -p "$HOME/AI/models/Avalon-IQ3KS"
huggingface-cli download freriadoc/Qwen3.8-Flash-Next-Avalon-GGUF \
  --local-dir "$HOME/AI/models/Avalon-IQ3KS"

find "$HOME/AI/models/Avalon-IQ3KS" -name '*.gguf' | sort | head
find "$HOME/AI/models/Avalon-IQ3KS" -maxdepth 1 -name '*.gguf' | wc -l
最后一条应显示 33(模型根目录的主分片数量);MTP 分片位于 MTP/ 下,不计入这 33 个。请同时确认 moe-cache-ranking.bin 和 MTP 文件存在。若下载工具返回下载失败或模型仓库需要额外授权,先按网站实际提示处理,不跳过校验。
2.4 启动 Avalon(256K + 两步 MTP)
以下使用官方 README 已提供的配置(-b 9536 -ub 9536 为 7900 XTX 显存与 Prefill 优化配置):
cd "$HOME/AI/Avalon"
MODEL_DIR="$HOME/AI/models/Avalon-IQ3KS"
HIP_VISIBLE_DEVICES=0 ./build/bin/llama-server \
  -m "$MODEL_DIR/Qwen3.8-Flash-Next-Avalon-IQ3KS-00001-of-00033.gguf" \
  -c 262144 -b 9536 -ub 9536 -fa on \
  -ctk q8_0 -ctv q4_0 --jinja --parallel 1 \
  -md "$MODEL_DIR/MTP/mtp-Qwen3.8-Flash-Next-shared-IQ3K-IQ4NL-FR65k.gguf" \
  --spec-type draft-mtp --spec-draft-n-max 2 -ubd 256 \
  -ctkd q8_0 -ctvd q8_0 \
  --host 127.0.0.1 --port 8080
首次启动会读取模型与预热缓存,不能仅凭短时间没有输出就断定卡死。启动后在主机浏览器打开 http://127.0.0.1:8080;也可以在另一个终端执行:
curl -s http://127.0.0.1:8080/health
curl -s http://127.0.0.1:8080/v1/models
请在日志中核对 draft model 正常加载;MTP 并不是只要命令里出现 -md 就一定运行成功。
3. 路线 B:部署 Strata RDNA3(Swift 1.5 IQ3_S + MTP)
项目:nicejunjie/Strata-rdna3,这是针对 RDNA3 调优的社区 fork,区别于标准上游 Strata。本期测试固定的源码提交是 309f0c8f。
3.1 获取并固定 fork
cd "$HOME/AI"
git clone https://github.com/nicejunjie/Strata-rdna3.git
cd Strata-rdna3
git checkout 309f0c8f
git rev-parse --short HEAD
3.2 安装 Swift IQ3_S 并编译 HIP 引擎
先核实重要差别:fork 自带的 rdna3/run.py iq3-1gpu 示例配置默认是 ISTA 原版 IQ3_S,并非视频本次使用的 Swift 1.5 IQ3_S。因此下面明确指定 --family swift --model IQ3_S,避免下载错误权重。Swift 模型来自 UkisAI Swift 1.5 GGUF,该量化的两个分片合计约 83.74GB。
cd "$HOME/AI/Strata-rdna3"
export XDG_CONFIG_HOME="$PWD/.config"
D="$HOME/AI/Strata-data"

./setup.sh --setup --build \
  --backend hip \
  --family swift --model IQ3_S \
  --context 262144 --kv int8 \
  --gpu 0 --vision no \
  --port 8081 \
  --data-dir "$D" \
  --no-start --yes
这一条会在项目自己的 .venv 中准备工具链、构建 HIP 引擎、下载 Swift 模型两分片及 MTP draft、生成 Strata 专家 pack 和启动配置。不要在已有 Strata 安装上省略 XDG_CONFIG_HOME:旧版本的 setup 可能迁移原先模型文件。 首次下载与打包会占用大量磁盘、内存和时间。
版本注意:Strata 的构建流程可能安装自己的隔离 ROCm SDK 组件,即使宿主机已有 ROCm 7.2.4,最终实际使用的构建工具链也可能不同。请以
engine/BUILD.json、构建日志为准,不能仅凭系统rocm-smi版本宣称工具链完全一致。
3.3 查看生成配置,确认四步 MTP
在本次固定源码中,setup.py 生成模型命令时默认加入 --spec 4 --spec-min-p 0.5 --mtp <draft目录>,以及选定的最大上下文和 KV 精度。安装完成后检查:
cd "$HOME/AI/Strata-rdna3"
ls -lh run-*.sh
ls -lh engine/strata engine/BUILD.json
# 查找 Strata 自动生成的 JSON 配置:
find "$HOME/AI/Strata-data" "$HOME/AI/Strata-rdna3" \
  -type f -name '*.json' 2>/dev/null | grep -Ei 'strata|iq3|swift' | head -n 30
找出启动脚本中 --config 引用的 JSON,再确认其 args 中包含 --spec 4、--mtp 和 --max-context 262144。没有这些项时请先检查 setup 是否真正完成,不应为了启动就删除 MTP 配置。
3.4 启动 Strata 并进入网页后台
cd "$HOME/AI/Strata-rdna3"
export XDG_CONFIG_HOME="$PWD/.config"
./setup.sh --gpu 0 --port 8081
如果该项目目录中已生成对应 Swift 模型的 run-*.sh,也可以从生成的脚本启动;优先以实际脚本和它引用的 JSON 为准。浏览器访问:
http://127.0.0.1:8081
Strata 的网页通常可查看 Chat 和 Monitor。命令行也可以验证:
curl -s http://127.0.0.1:8081/v1/models
网页打开但模型没有回答,不算部署成功;必须再做一次真正的中文聊天验证。
3.5 想进一步接近 RDNA3 极限性能?
fork 还提供 RDNA3 完整复现说明 和 RDNA3 优化参数。这些文件包含 WMMA、专家计算、KV Host DMA 等专项选项。但它们的 iq3-1gpu 预设面向原版 IQ3_S,不要原封不动地套到 Swift 配置上并宣称必然重现本次成绩。
本篇步骤的目标是让 Swift IQ3_S + MTP 确实成功启动并回答;如要严格重现视频的 92.5 tokens/s,还须与本次实测所用的 config/strata.json、模型文件哈希及对应的调优环境变量逐项核对。目前公开资料中没有这组完整配置,所以不把未知值写成所谓“实测同款一键参数”。
4. 统一验证:确认两套引擎都真正生成了答案
两套引擎都提供 OpenAI 兼容接口。下面使用 Python 标准库,不需要再安装第三方客户端。每次先确认只启动了其中一套引擎。
在 ~/AI/ 创建一次验证脚本:
cat > "$HOME/AI/check_model.py" <<'PY'
import json, sys, urllib.request
port = int(sys.argv[1])
base = f"http://127.0.0.1:{port}"
with urllib.request.urlopen(base + "/v1/models", timeout=30) as r:
    models = json.load(r)["data"]
if not models:
    raise SystemExit("没有返回可用模型")
model_id = models[0]["id"]
body = json.dumps({
    "model": model_id,
    "messages": [{"role": "user", "content": "请用中文解释 MoE 模型为什么可以在 24GB 显卡上运行,分三点回答。"}],
    "max_tokens": 256,
    "temperature": 0,
    "stream": False
}, ensure_ascii=False).encode("utf-8")
req = urllib.request.Request(base + "/v1/chat/completions", data=body,
    headers={"Content-Type": "application/json"}, method="POST")
with urllib.request.urlopen(req, timeout=300) as r:
    answer = json.load(r)
print("model:", model_id)
print(answer["choices"][0]["message"].get("content", ""))
print("usage:", answer.get("usage", {}))
PY
启动 Avalon 时执行 python3 "$HOME/AI/check_model.py" 8080;启动 Strata 时执行 python3 "$HOME/AI/check_model.py" 8081。能返回非空中文答案、没有服务端错误和崩溃,才算完成最小部署验收。首次请求可能因加载或长上下文初始化而等待较久。
5. 常见问题与处理方式
Q1:提示 No HIP devices、gfx1100 not found 或没有 GPU 权限。 先检查 rocm-smi、rocminfo、/dev/kfd 权限及实际 GPU 驱动;不要通过改用 CPU-only 运行来冒充单卡实测。AMD 安装与系统兼容问题优先查官方 ROCm 文档。
Q2:Strata 下载或安装中断。 在原项目目录、相同 XDG_CONFIG_HOME 和数据目录下重复安装命令,利用其续传与已有文件检查机制;不要反复换数据目录造成大文件重复下载。磁盘不足时应先核查大小,不要直接删除其他项目的模型。
Q3:模型启动后内存使用明显上升。 这是大 MoE 模型的正常特征之一:大量专家权重留在系统内存,长上下文 KV 也会额外占用资源。视频中提到的“约 54.8GB”是本地执行端按整机 MemTotal - MemAvailable 采集的全机已用内存峰值,不是证明 Strata 进程独占了 54.8GB。
Q4:250K 输入崩溃或 OOM。 初次跑通可以先用更小窗口,例如 Avalon -c 65536,Strata 在重新配置时使用 --context 65536。这只为排障;降低上下文后不能再称为视频的 256K 复现成绩。检查是否仍有第二引擎占用显存、交换分区过载或 RAM 不够。
Q5:为什么我的生成速度达不到视频里的数字? CPU 型号、DDR4 带宽、PCIe、GPU 占用、专家命中率、模型量化、输入长度、MTP 接受率、KV 精度、是否启用 RDNA3 调优,以及测量的是瞬时值还是三次中位数,都会影响结果。尤其不要把 Strata 官方 iq3-1gpu 原版模型预设误当成 Swift 1.5 的完整复现实例。
Q6:能同时给多个人使用吗? 本期只做了 单并发 性能测试,并未验证高并发吞吐或多个请求同时加速;本文也不建议直接把服务绑定到公网。局域网访问需要另行配置监听地址和认证。
Q7:开源程序与模型可以重新打包出售吗? 引擎源码、Avalon 模型、Swift 模型采用不同的许可证。本文只提供原始项目和权重来源链接,转发文章不等于获得模型再分发或商业销售权。发布整合安装包前需逐项审查许可证、NOTICE 和模型使用条款。
6. 本次视频成绩表(用于参考,不保证每台机器复现)
6.1 合成 Benchmark 基准测试(三次运行中位数)
| 场景与测试指标 | Avalon IQ3_KS + MTP | Strata Swift IQ3_S + MTP | 性能差值 / 胜出方 |
|---|---|---|---|
| 1K 输入、2048 输出:Decode 持续生成 | 80.3 tokens/s | 92.5 tokens/s | +15.2% (Strata) |
| 64K 输入:Prefill 预填充吞吐 | 1938.4 tokens/s | 3167.1 tokens/s | +63.4% (Strata) |
| 64K 输入:Decode 生成(256 输出) | 72.3 tokens/s | 97.5 tokens/s | +34.9% (Strata) |
| 约 250K 输入:Prefill 预填充吞吐 | 1662.7 tokens/s | 3190.4 tokens/s | +91.9% (Strata 1.92x) |
| 约 250K 输入:Decode 生成(256 输出) | 59.5 tokens/s | 83.1 tokens/s | +39.7% (Strata) |
| 约 250K 输入:首字等待延迟(TTFT) | 156.4 秒 | 81.4 秒 | -48% 腰斩 (Strata) |
6.2 真实应用场景考核(反转亮点)
| 业务任务场景 | 任务特征 | Avalon 实测耗时 | Strata 实测耗时 | 最终结果与分析 |
|---|---|---|---|---|
| 长文档关键信息提取 | 约 3.2 万字文档抽取目标实体 | 38.11 秒 | 7.37 秒 | Strata 胜出(长预填充极致加速) |
| 超长代码库大海捞针 | 64K Context 查找隐藏 Bug 标记 | 25.86 秒 | 10.94 秒 | Strata 胜出(长文本检索精准响应) |
| Python 线程安全缓存池实现 | 真实端到端编程(含 3 项单元测试) | 20.79 秒 | 25.04 秒 | 🔥 Avalon 反超!(单次推理路径更优) |
关键技术洞察:
跑分测试赢了,并不代表在所有真实工程任务中绝对压制。在 Python 编程任务中,虽然 Strata 的首字响应和持续速度更快,但 Avalon 凭借更高效的单次推理路径和更少的分支重试,以 20.79 秒率先进行完整交卷,且双方生成的代码均 100% 通过了 3 项多线程并发单元测试。这也是为什么我们强烈建议不要“迷信跑分”,应结合具体任务场景选型。
以上采用本期本地执行端的汇总中位数。主要速度对比为本机、双方各自选用的完整优化方案结果;不是同一 GGUF、同一量化格式的纯推理内核比较。视频展示实时竞速时,请使用原始时间序列,不要将表中中位数人为插值成伪造的实时采样。
7. 原始项目、权重与复现资源
- Avalon 项目:https://github.com/freriadoc/Avalon
- Avalon IQ3_KS + MTP 模型:https://huggingface.co/freriadoc/Qwen3.8-Flash-Next-Avalon-GGUF
- Strata RDNA3 fork:https://github.com/nicejunjie/Strata-rdna3
- Strata fork 的 RDNA3 复现说明:https://github.com/nicejunjie/Strata-rdna3/blob/main/rdna3/README.md
- Strata 的 RDNA3 参数与机制:https://github.com/nicejunjie/Strata-rdna3/blob/main/docs/RDNA3_SETTINGS.md
- Swift 1.5 IQ3_S 模型:https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- ROCm 7.2.4 Ubuntu 安装说明:https://rocm.docs.amd.com/projects/install-on-linux/en/docs-7.2.4/install/install-methods/package-manager/package-manager-ubuntu.html
结语
如果你只有一张 RX 7900 XTX,想在本地运行 125B MoE,并且主要关心长文档处理与生成效率,这期实测更支持优先尝试 Strata RDNA3 + Swift IQ3_S;如果想体验另一条专用量化、CPU/GPU 协同加速路线,则可以按照前面的步骤部署 Avalon。两套方案都值得实际跑一遍,再选择适合自己机器的那套。
玩客笔记会继续分享 AMD 显卡、本地大模型部署与 AI Agent 工程化的实际测试。本文教程及视频测试数据以所述版本和环境为准;安装过程如遇 upstream 改动,请以冻结 commit 和其发布说明作为复现基线。
💡 资源获取与技术交流:如需本期全套测试脚本、自动化压测日志与 Remotion 原始数据包,或在环境搭建中遇到 HIP 报错,欢迎通过视频画面右下方的联系方式直接交流探讨,添加时备注「7900XTX」随时探讨!
About The Author