RTX 3060 12GB 本地运行 125B 大模型全记录:Speedy 部署实测与避坑指南
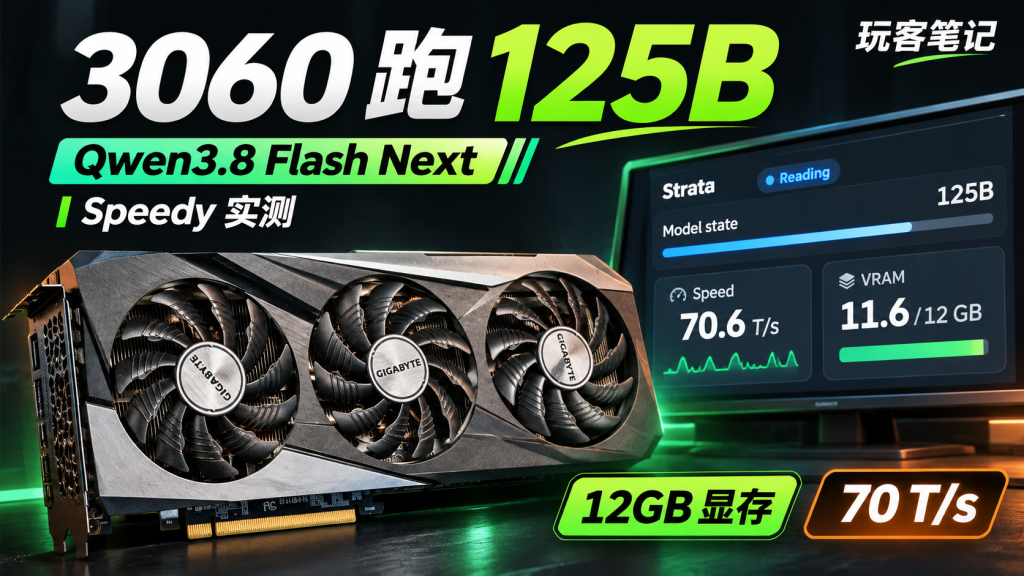
导读与真实性边界说明:千亿参数 MoE 大模型(83.6GB 双分片权重 + 120K 超长上下文),在一张二手千余元的甜品卡上究竟能跑出什么水平?本文完整记录了我们在 NVIDIA RTX 3060 12GB + Ryzen 7 3700X + 96GB 系统内存(Linux 显示约 94GiB)+ Ubuntu 24.04 实测环境中,基于 DevDock-AI/Speedy (
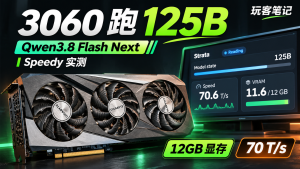
e307537) 运行 ISTA-DASLabQwen3.8-Flash-Next-GSQ-RCO-GGUF(IQ3_S) 的测试数据与公开部署路线:六轮冷启动基准(reused=0)下 32K/120K Prefill 中位数达 1,005.3 / 920.1 tok/s、Decode 中位数达 59.1 / 68.2 tok/s,日常单轮监控演示约 70.6 tok/s。⚠️ 适用范围声明:原视频实测成绩来自历史测试记录(复用已适配 CUDA 12.0.140 的
bin/strata与既有模型资产,原测试机现已退役)。下文的新机部署步骤依据当前 Speedy 官方公开文档整理,并非在全新系统上重复验收的“一键保证书”;不同内存容量、驱动与源码提交下的性能存在差异,请先核对硬件与磁盘余量再操作。🎬 本期配套视频已同步上线:
– YouTube 中文频道(@chen_yang):RTX 3060 12GB 挑战 125B 大模型实测与复现
– B站官方频道(玩客笔记):RTX 3060 12GB 竟然跑起了 125B!Speedy 完整部署教程,实测每秒 70 Token(BV1Ng4E6YEnY)
一、先算清“三级异构存储”总账:12GB 只是显存,不是整机内存
在本地大模型圈子里,最容易误导新手的说法就是“只要一张 12GB 显卡就能跑千亿模型”。
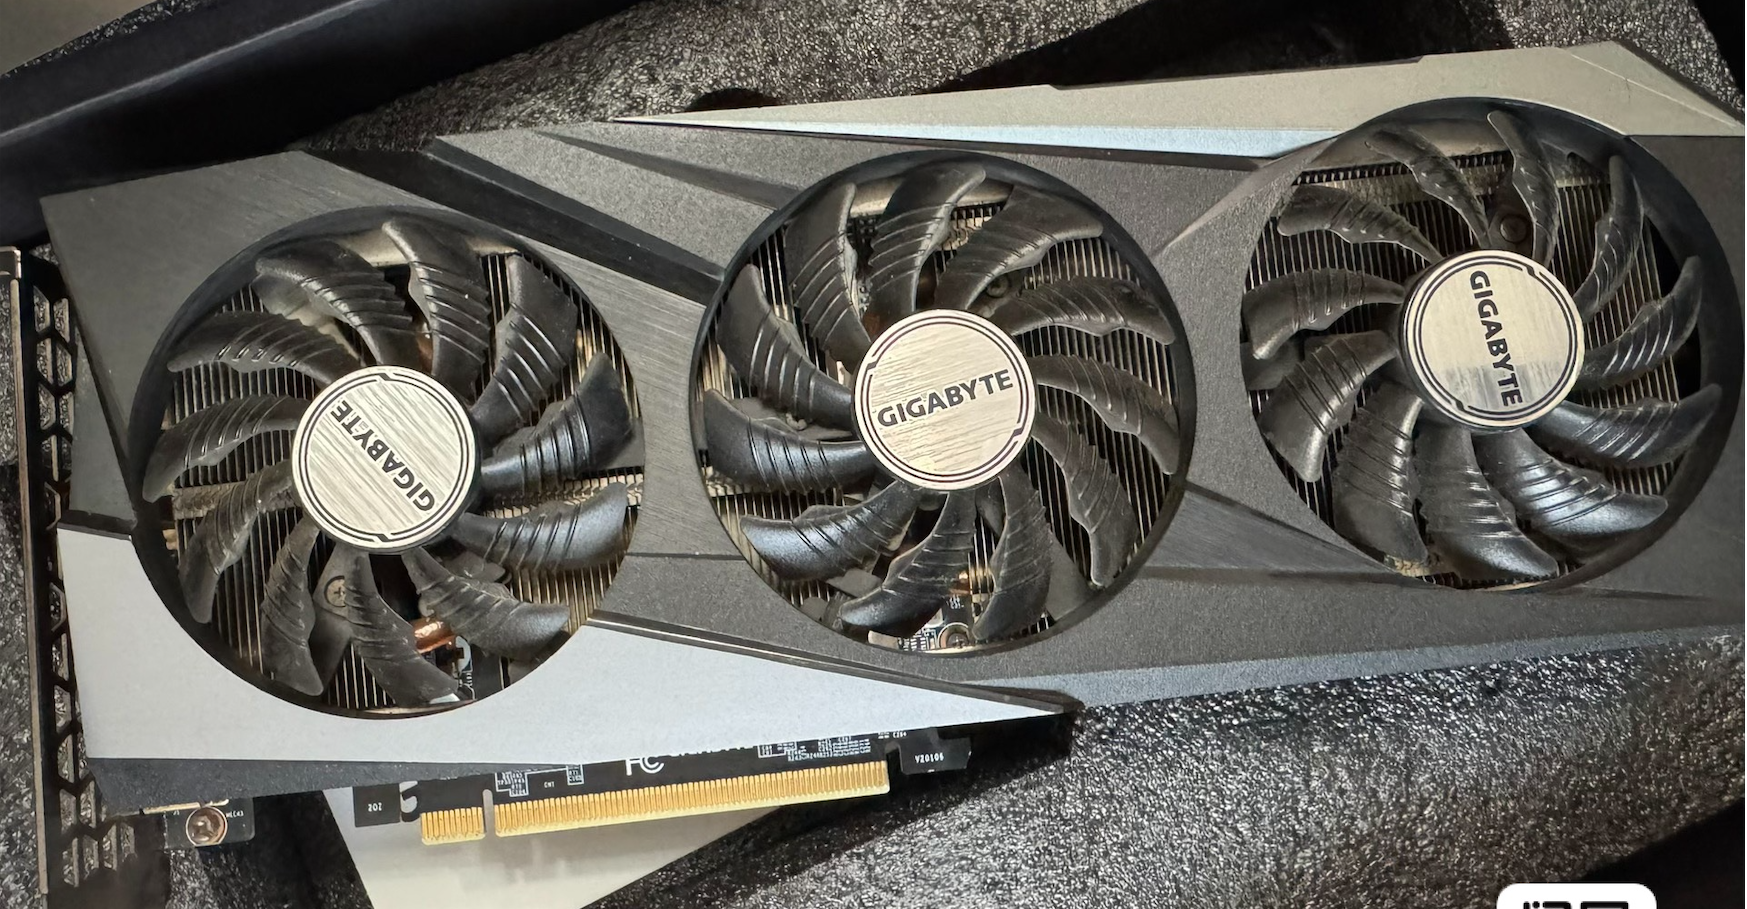
客观的工程事实是:83.6GB 的模型权重不可能凭空塞进 12GB 显存。 这套方案之所以能跑通,靠的是 “12GB GDDR6 显存专家缓存 + 96GB 系统物理内存 + PCIe 4.0×16 负载总线” 的协同配合——因此 16GB / 32GB 系统内存的电脑不能照搬本期 96GB 机器的成绩,也不能把“进程能启动”等同于“能稳定跑到每秒 60~70 Token”。
1.1 本期历史实测环境基线(Issue #127)
| 项目 | 本期成功实测环境 | 新机部署提示 |
|---|---|---|
| 显卡 (GPU) | NVIDIA GeForce RTX 3060 12GB(负载态 PCIe 4.0×16) | Ampere 架构对应 CUDA sm_86;空闲时 PCIe 自动降档属正常节能行为 |
| 处理器与内存 | Ryzen 7 3700X(8 核 16 线程)/ 约 96GB 物理内存(free -h 约 94GiB) |
权重主要由系统 RAM 配合显存缓存服务;更小内存需按官方安装器评估,速度不作保证 |
| 本地存储 | NVMe SSD | IQ3_S 双分片合计 83.6GB(十进制)/ 约 77.9GiB(二进制),另需 packs、MTP、源码与缓存;建议预留 120GB 以上可用空间 |
| 操作系统 | Ubuntu 24.04 LTS | 本教程仅面向 Linux;Windows 的编译链、驱动与 WDDM 显存调度机制不同 |
| 驱动与 CUDA | NVIDIA Driver 595.99.02 / CUDA Toolkit 12.0.140 |
当前 Speedy 官方源码构建文档主要面向 CUDA 13.x;切勿为模仿视频随意改动生产机驱动 |
| 推理引擎 | Speedy commit e307537(启用 MTP 多 Token 预测) |
新机从零安装请优先核对当前官方仓库版本与 --help 输出 |
容量单位提醒:Hugging Face 官方页面标注
IQ3_S两个分片分别为 54.8GB + 28.8GB = 83.6GB(十进制),在 Linuxdu中显示约为 77.9GiB(二进制)。视频口播中提到的“约 79GB”是口语近似,实际核对请以官方文件字节与 SHA256 为准。
1.2 为什么 12GB 显存跑得动?MoE 稀疏激活与显存专家缓存
Qwen3.8-Flash-Next 采用 MoE(混合专家)架构。与每次吐字都要搬运全部权重的稠密(Dense)模型不同,MoE 每一步只激活其中一小部分路由专家与共享专家:
- 自动显存专家缓存:在本轮实测配置中,Speedy 在 RTX 3060 显存内自动分配了 2,554 个专家槽位(约 4.90GiB 显存缓存),稳态总显存占用控制在 约 11,509 MiB;
- RAM + VRAM 分层服务:高频命中的热专家直接留在显卡显存内高速计算,未命中的专家由系统大内存经 PCIe 链路按需交换;
- MTP 投机解码配合:六轮正式测试中 MTP 接受比例为 63.64%–81.82%(注:MTP 接受率代表草稿 Token 验证通过比例,不代表回答内容的事实正确率)。
二、真机实测数据核对:严格区分单轮演示与六轮冷读入中位数
为了杜绝“拿 Prefill 冒充生成速度”或“拿单次面板峰值冒充稳定均值”,我们将两类历史观测记录分开列出:
2.1 Issue #127 正式六轮冷读入基准(reused=0)
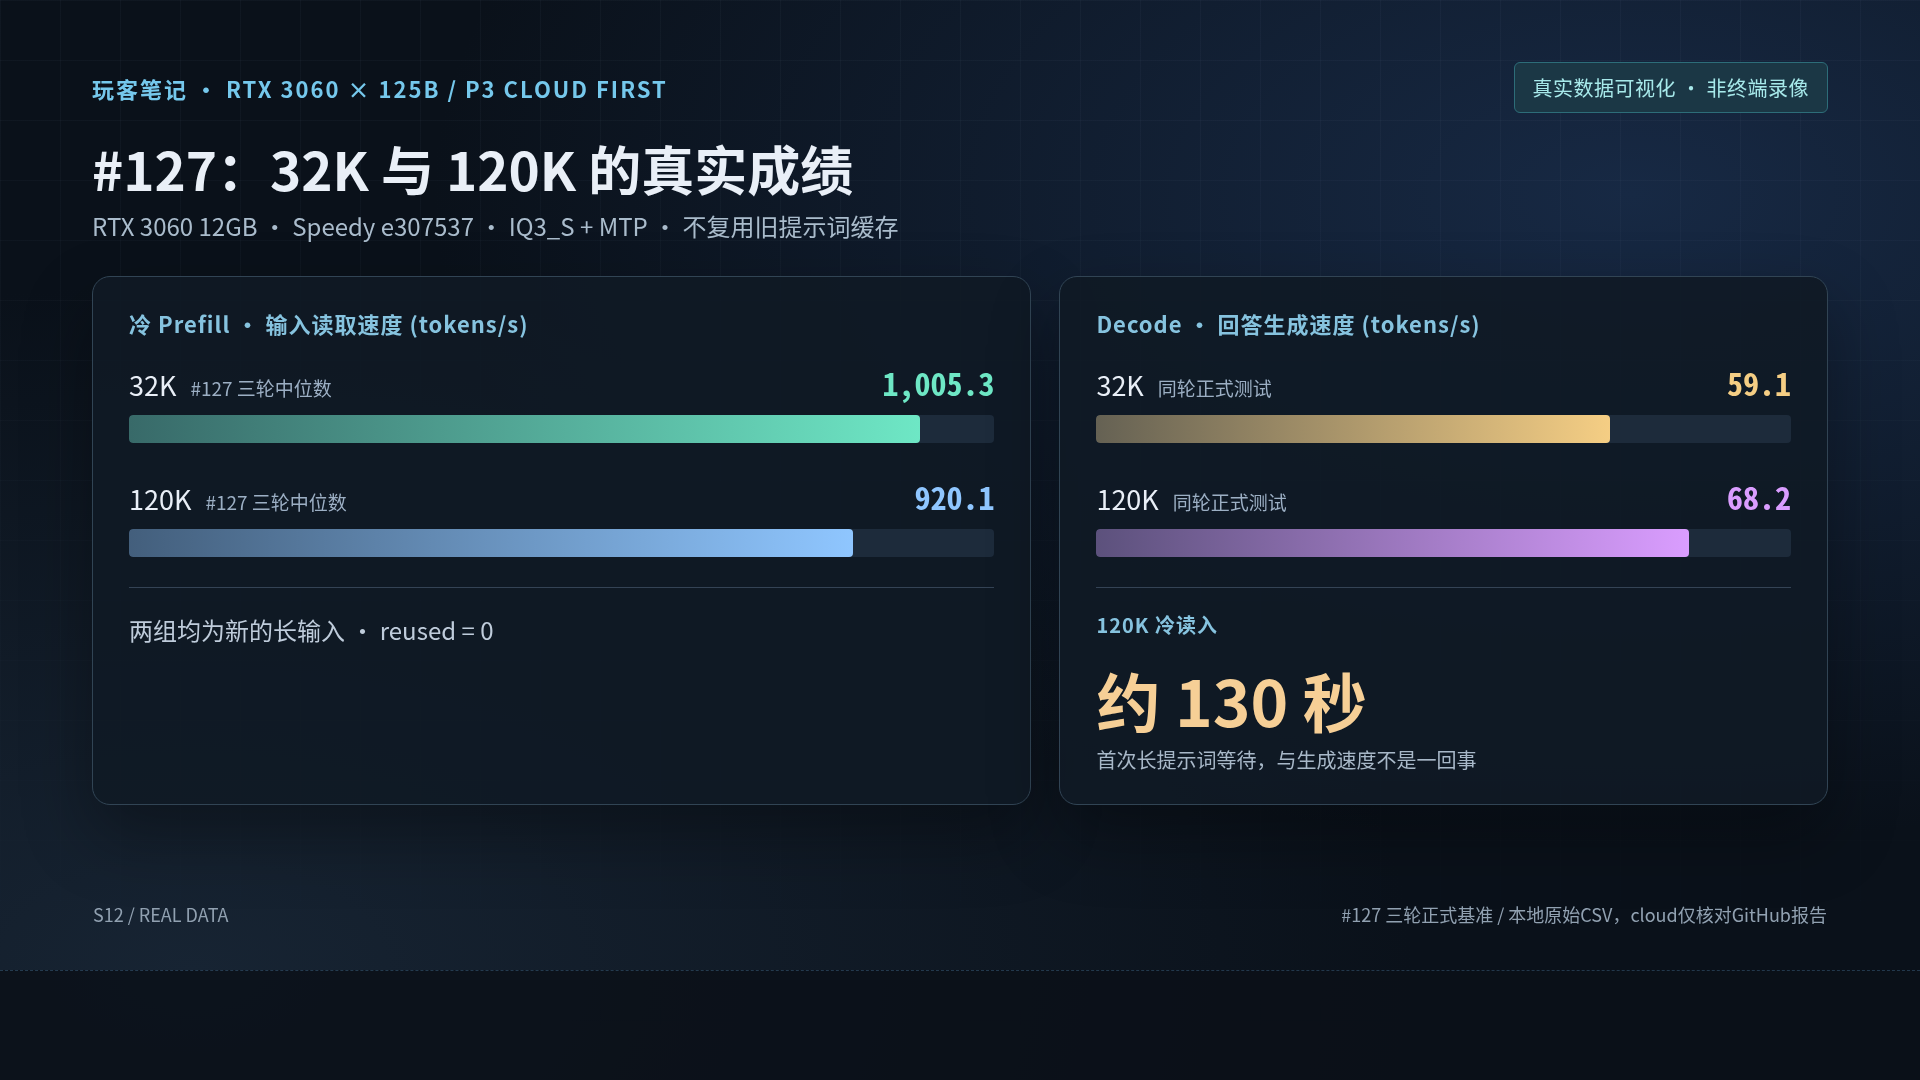
在关闭缓存复用(reused=0)、32K 与 120K 各连续执行三轮的严格口径下:
| 测试档位 | 三轮冷 Prefill 记录 (tok/s) | Prefill 中位数 | Decode 生成中位数 | 首次冷读入耗时中位 | 稳态显存占用 |
|---|---|---|---|---|---|
| 32K 上下文(3 轮) | 1005.3 / 1046.9 / 946.2 |
1,005.3 tok/s | 59.1 tok/s | 约 32 秒级 | ~11,509 MiB |
| 120K 上下文(3 轮) | 907.3 / 952.6 / 920.1 |
920.1 tok/s | 68.2 tok/s | 130.482 秒(约 130.5 秒) | ~11,509 MiB |
- Prefill vs Decode:Prefill 是模型读入提示词的速度,Decode 才是模型逐词生成回答的速度。切勿将
1005.3 tok/s理解为每秒写出上千个词。 - 单次历史监控演示说明:视频中出现的
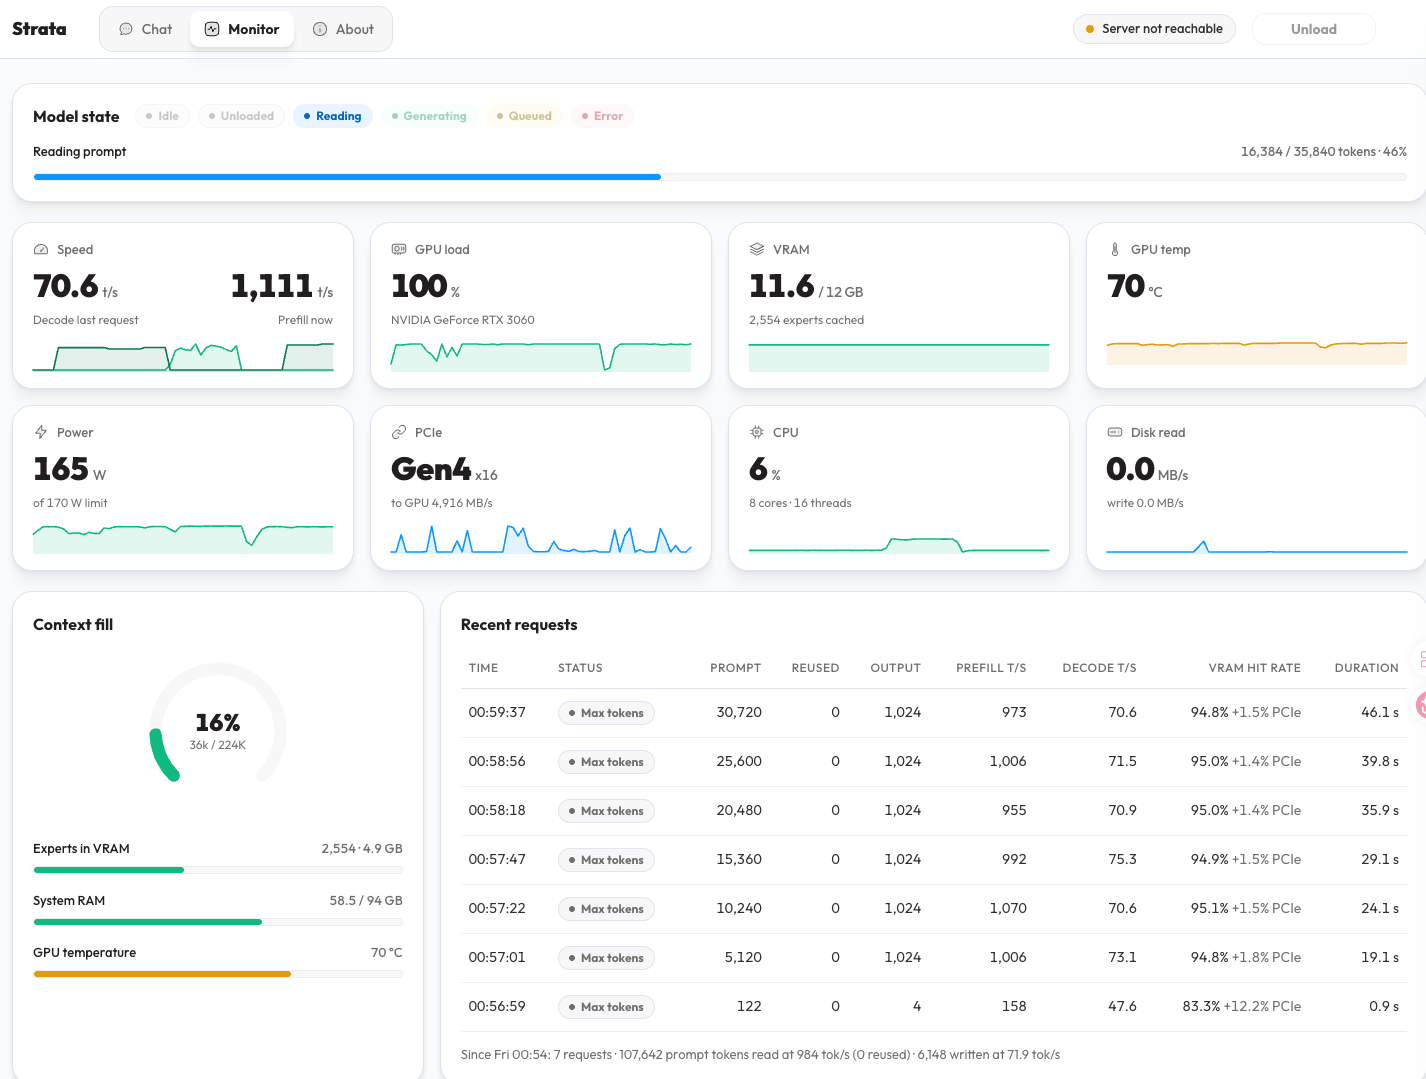
70.6 tok/s(显存11.6/12GB)以及 5K–30K 多档单轮演示的70–75 tok/s,属于另一组真实历史单轮监控记录,不能与上方六轮reused=0基准混为同一组中位数。
2.2 与历史 RTX 3080 10GB 数据的观察对照(非严格单变量 A/B)
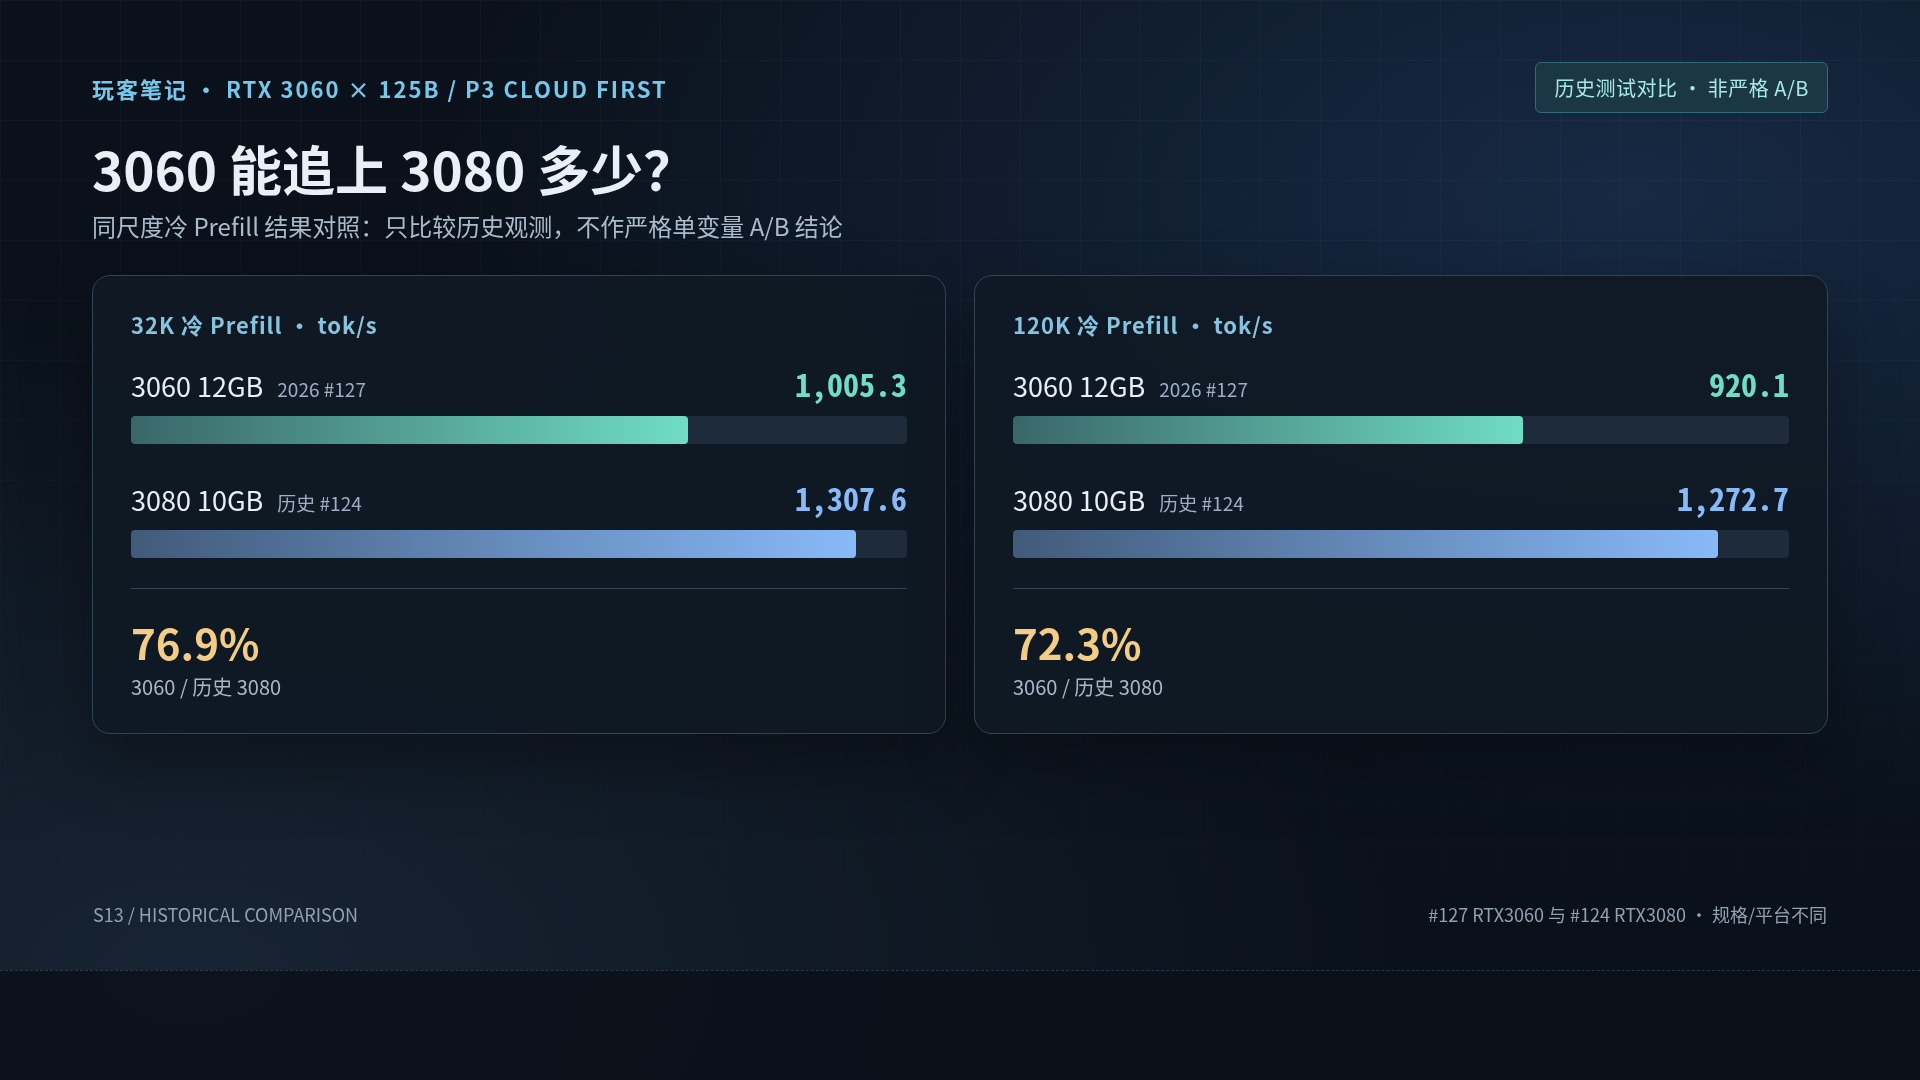
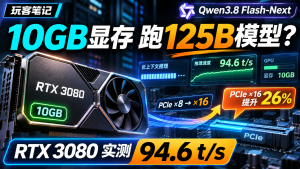
在早期 Issue #124 的 RTX 3080 10GB 历史测试中,32K 与 120K 冷 Prefill 中位数分别为 1,307.6 tok/s 与 1,272.7 tok/s。横向对照可见,RTX 3060 12GB 在该历史观测下达到了 3080 约 76.9%(32K) 与 72.3%(120K) 的 Prefill 水平。需要注意:两台测试环境的显卡架构细节、显存容量及具体配置参数并不相同,仅作跨档位参考,不构成严格单变量因果推断。
三、部署实操参考:官方交互式安装与手动源码构建两条路线
以下步骤整理自配套资料包(01_零基础安装部署教程.md 与 02_手动构建与配置参考.md),仅面向本人可管理的 Ubuntu Linux 机器。
第 1 步:安装前只读环境体检(不改系统、不启模型)
打开 Ubuntu 终端,依次确认显卡、CUDA 编译器、整机内存与磁盘剩余空间:
nvidia-smi
nvcc --version
free -h
lsblk -o NAME,FSTYPE,SIZE,MOUNTPOINT
df -h "$HOME"
python3 --version
cmake --version
解压配套资料包后,也可直接运行纯只读体检脚本:
bash scripts/01_check_environment.sh
判读要点:
– nvidia-smi 右上角显示的 CUDA Version 是驱动最高兼容版本;真正的编译工具链版本以 nvcc --version 为准。若提示找不到 nvcc,先检查 /usr/local/cuda/bin 是否已加入 PATH,切勿盲目覆盖系统驱动。
– 初次运行前确保 RTX 3060 没有被其他大模型服务或高负载图形程序占满显存。
第 2 步:路线 A(推荐新手)— 使用 Speedy 官方 ./setup.sh 准备资产
打开 DevDock-AI/Speedy 官方仓库 并阅读 docs/SOURCE_INSTALL.md。官方交互式 setup.sh 会引导准备 Python 虚拟环境、推理引擎、双分片 GGUF、packs/iq3_s/(含 tokenizer)与 mtp/rt/ 草稿层资源:
mkdir -p "$HOME/projects/ai/speedy-3060-guide"
cd "$HOME/projects/ai/speedy-3060-guide"

git clone https://github.com/DevDock-AI/Speedy.git speedy
cd speedy

git rev-parse --short HEAD
./setup.sh --help
核对当前版本的 --help 参数说明后,可按以下方向准备 IQ3_S、关闭视觉模块并以保守的 32K (32768) 上下文起步验证:
# 注意:--no-start 仅代表准备完成后不立即拉起服务,执行过程中仍会下载大体积模型与依赖
./setup.sh --family qwen --model IQ3_S --context 32768 --vision no --no-start
如果上游新版本的选项名称与上行命令有出入,一律以本机 ./setup.sh --help 输出为准。使用官方安装器时无需再手工重复下载同一套 GGUF。
第 3 步:核对模型双分片文件名与 SHA256 完整性
本期使用的公开量化仓库为 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF(位于 IQ3_S/ 目录)。两个分片必须同时存在:
IQ3_S/
├── Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf   # 54.8GB(十进制)
└── Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf   # 28.8GB(十进制)
官方页面与历史 #127 记录一致的参考 SHA256:
00001 分片:4c1eb2ceb4915e1192f4f386021897bde56a97f40a0bb78bb86465e0f7d2aca3
00002 分片:316b46f3a2dbd68c900f43136ab9449f9dcc3725dfd8c794847c204bc161e113
如需单独通过 Hugging Face 官方 CLI 下载(请先确认磁盘余量充足):
python3 -m venv .hfcli-venv
.hfcli-venv/bin/pip install 'huggingface_hub[cli]'

.hfcli-venv/bin/hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF \
  --include 'IQ3_S/*' \
  --local-dir "$HOME/projects/ai/qwen38-models"
⚠️ 仅下载两个 GGUF 分片不等于部署完成:Speedy 运行还需要匹配版本生成的 packs/iq3_s/(内含 tokenizer/)与 mtp/rt/ 目录。切勿将不同版本或未知来源的 pack / MTP 文件强行混拼。可使用资料包的只读校验脚本核查目录结构:
# 默认快速核查文件与非空目录存在性,不读取 83.6GB 全量字节
python3 /path/to/EP19_RTX3060_125B_Deployment_Kit/scripts/02_verify_assets.py \
  --weights-dir /YOUR/WEIGHTS/IQ3_S \
  --pack-dir /YOUR/PACKS/iq3_s \
  --mtp-dir /YOUR/STRATA_DATA/mtp/rt \
  --engine "$PWD/build/strata"

# 如需完整计算 83.6GB 双分片哈希比对,再显式追加 --sha256
第 4 步:路线 B(进阶可选)— 手动编译 build/strata 与生成本机配置
熟悉 Linux CMake 构建的用户,可参考官方 docs/BUILD-LINUX.md 针对 RTX 3060 的 Ampere sm_86 架构编译 build/strata(注:历史测试机的 CUDA 12.0.140 最小兼容改动未包含在公开源码中;当前官方构建说明主要面向 CUDA 13 环境):
export PATH=/usr/local/cuda/bin:$PATH
nvcc --version

cmake -S . -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DSTRATA_ENABLE_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=86 \
  -DSTRATA_MMQ_KQUANTS=ON \
  -DSTRATA_MMQ_TQ_OVERLAY=ON \
  -DSTRATA_NATIVE_EXPERTS=ON \
  -DSTRATA_Q6K_EXPERTS=ON

cmake --build build --target strata -j 4

python3 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
ls -lh build/strata
生成本机配置文件时,可借助资料包内的单次写入脚本 03_fill_config.py 从仓库官方模板 configs/cards/rtx3080-10gb/1x/strata-iq3_s.json 填充本机真实路径(脚本强制绑定 127.0.0.1 且绝不覆盖已有文件):
mkdir -p configs/mine

python3 /path/to/EP19_RTX3060_125B_Deployment_Kit/scripts/03_fill_config.py \
  --template configs/cards/rtx3080-10gb/1x/strata-iq3_s.json \
  --speedy-root "$PWD" \
  --weights-dir /YOUR/WEIGHTS/IQ3_S \
  --pack-dir /YOUR/PACKS/iq3_s \
  --mtp-dir /YOUR/STRATA_DATA/mtp/rt \
  --out configs/mine/strata-3060-iq3_s.json \
  --context 32768

python3 -m json.tool configs/mine/strata-3060-iq3_s.json >/dev/null
配置重要提醒:仓库内的
rtx3080-10gb/1x/strata-iq3_s.json(及资料包templates/strata-iq3_s-upstream3080-reference.json)是上游 RTX 3080 10GB 参考形状,并非退役 3060 测试机的原始私有配置。首次运行请先从--context 32768起步观察--kv-resident、--vram-reserve-mib与引擎日志,确认稳定后再评估是否上调至131072。
第 5 步:启动本地服务与真实问答验证
当引擎、双分片权重、pack、tokenizer 与 MTP 全部就位后,在 Speedy 根目录启动本地回环服务:
.venv/bin/python serve/server.py \
  --engine strata \
  --config configs/mine/strata-3060-iq3_s.json \
  --port 8080
打开第二个终端执行只读探针检查:
curl -i http://127.0.0.1:8080/health
curl -sS http://127.0.0.1:8080/v1/models

# 或使用资料包只读探测脚本(仅请求 127.0.0.1 的 /health 与 /v1/models)
python3 /path/to/EP19_RTX3060_125B_Deployment_Kit/scripts/04_probe_local.py --port 8080
随后通过自带 WebUI 或本地接口发送一条中文测试问题(例如:“请用中文解释什么是 MoE,并举一个生活中的例子”),确认能返回正常中文回答且 nvidia-smi 同步出现 GPU 计算负载,才算真正部署跑通。
四、高频排错与避坑要点(摘自《05_常见问题.md》)
nvidia-smi显示 CUDA 13,但nvcc --version显示 12,冲突吗?
不冲突。前者是显卡驱动支持的最高 CUDA 协议版本,后者才是本机实际安装的编译工具链版本。CMake 编译以nvcc为准,无需因此盲目升降驱动。- 只下载第 1 个 54.8GB 分片能不能先跑起来?
不行。第一分片为主模型权重(--native),第二分片含 n-gram 查表与辅助数据(--ple-gguf),缺一不可;同时还需配套版本的专家pack、tokenizer与MTP目录。 - 只有 RTX 3060 12GB + 32GB 系统内存,能跑到 70 tok/s 吗?
不能保证。本期实测机配有约 96GB 物理内存;内存不足时部分权重读取会退化到磁盘交换甚至触发内存不足退出,切勿按 96GB 机器的表现预期低内存主机。 - 提交 120K 超长提示词后两分钟没吐字,是程序卡死了吗?
未必。历史实测中 120K 冷 Prefill 中位数本身就需要 约 130.5 秒,这属于首次读入上下文的正常计算阶段。请先观察 GPU 利用率与服务日志是否有 OOM 报错,不要误杀正在 Prefill 的进程。 - 报
CUDA out of memory时,能把--vram-reserve-mib改成 0 吗?
不建议。应先排查是否有其他进程占用显存,并从32768上下文起步调优;盲目将显存预留清零极易在长上下文推理中途引发崩溃。 - 可以把服务改为
0.0.0.0直接暴露到公网吗?
默认严禁裸奔开放公网。请保持绑定127.0.0.1本机回环;如确需局域网或远程访问,务必先阅读官方 SECURITY.md 配置 API Key 鉴权与访问控制。
五、配套资料包下载、上游仓库与交流社群
本期整理归档的 EP19_RTX3060_125B_部署资料包_v1.zip 文件清单如下:
EP19_RTX3060_125B_Deployment_Kit/
├── README.md                                        # 资料包总览、使用顺序与权限安全边界
├── 01_零基础安装部署教程.md                          # 新手友好的完整图文教程与验证步骤
├── 02_手动构建与配置参考.md                          # CMake sm_86 编译与手动配置填充指南
├── 03_视频画面与命令速查.md                          # 视频镜头命令对照与真实性角标说明
├── 04_实测证据及来源.md                              # #127 六轮基准数据、历史 SHA256 与证据分级
├── 05_常见问题.md                                    # 18 条高频症状与最小排错手册
├── PACKAGE_MANIFEST.json                            # 资料包版本、测试状态与文件字节清单
├── SHA256SUMS.txt                                   # 包内全部文件 SHA256 校验值
├── scripts/
│   ├── 01_check_environment.sh                      # 纯只读机器硬件与工具链检查
│   ├── 02_verify_assets.py                          # 只读双分片 GGUF / pack / MTP 完整性核验
│   ├── 03_fill_config.py                            # 单次写入生成绑定 127.0.0.1 的本机 JSON 配置
│   └── 04_probe_local.py                            # 本机 8080 端口 /health 与 /v1/models 只读探测
└── templates/
    └── strata-iq3_s-upstream3080-reference.json     # 上游单卡 IQ3_S 参考模板(非 3060 原机私有配置)
RTX 3060 12GB × 125B 部署资料包 V1 已上线
内含《EP19_RTX3060_125B_部署资料包_v1.zip》(5 篇中文部署与排错文档、4 个只读/受控辅助脚本、参考配置模板与 SHA256 清单)及《RTX3060本地AI资料中心.pdf》可点击索引。当前 V1 不含 83.6GB 模型权重、引擎二进制或原始测速日志;也可在 B站评论区或私信发送【3060】自动获取。
公开上游源码与模型地址
- Speedy 官方仓库(MIT 许可):https://github.com/DevDock-AI/Speedy
- Speedy Linux 交互安装说明:https://github.com/DevDock-AI/Speedy/blob/main/docs/SOURCE_INSTALL.md
- Speedy Linux 源码构建文档:https://github.com/DevDock-AI/Speedy/blob/main/docs/BUILD-LINUX.md
- Speedy 配置文件占位符规则:https://github.com/DevDock-AI/Speedy/blob/main/docs/CONFIG-PLACEHOLDERS.md
- ISTA-DASLab
IQ3_S官方模型仓库:https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
如果您在本地复现过程中遇到硬件选型、CUDA 工具链兼容或 MoE 显存缓存调优问题,欢迎扫描下方微信二维码添加作者,备注「3060」加入「玩客笔记 · 本地算力极客交流群」一起交流探讨:
本文基于历史实测记录与开源上游公开文档编制,转载请注明出处:玩客笔记 (blog.757688.xyz)
About The Author