目录
适用环境:
- macOS
- Apple Silicon 芯片(M1 / M2 / M3 系列)
- 以 Mac Studio / MacBook Pro 为代表的统一内存设备
- 希望在本机运行 ComfyUI,并追求极速出图与原生中文提示词的用户
⚠️ 核心警告:
Z-Image-Turbo拥有完全独立的节点链路。绝对不能在之前Flux2的工作流上直接替换模型文件,否则必定报错(维度不匹配2560 vs 7680)。请严格按照本教程重新搭建工作流。
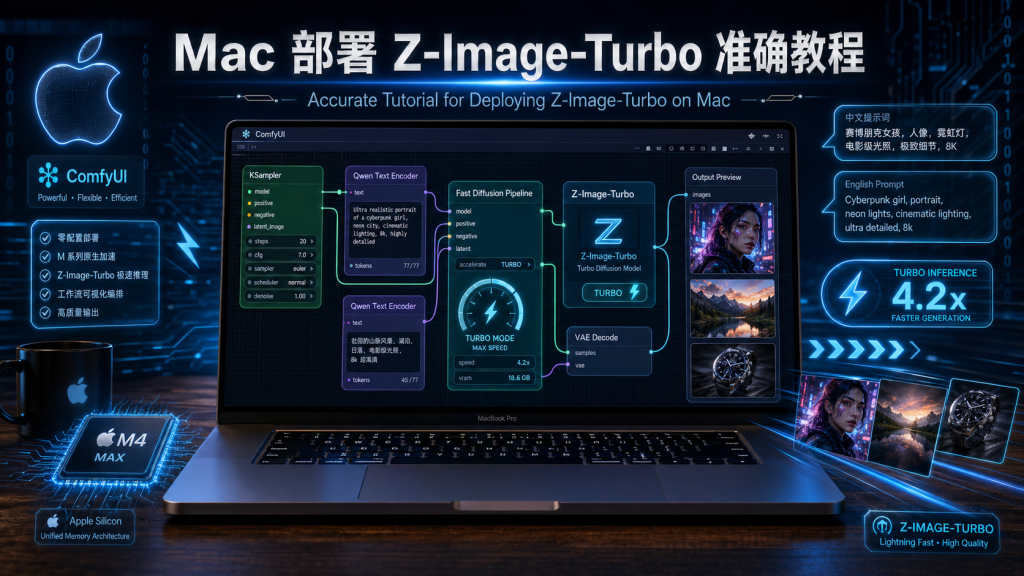
一、最终使用的模型组合
本教程使用以下 3 个核心文件。请勿混用以前下载的任何 Flux2 模型或 VAE。
- 主模型:
z_image_turbo_bf16.safetensors - 文本编码器:
qwen_3_4b.safetensors - VAE 模型:
ae.safetensors
二、准备 Mac 基础环境
打开 macOS 自带的 Terminal(终端),依次执行以下命令:
1. 安装 Homebrew(如已安装可跳过)
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"
2. 安装 Python 3.11、Git 和 Hugging Face 命令行工具
brew install [email protected] git
pip3 install -U "huggingface_hub[cli]"
三、克隆并安装 ComfyUI
建议安装在用户主目录下。在终端执行:
1. 下载源码并创建虚拟环境
cd ~
git clone https://github.com/comfy-org/ComfyUI.git
cd ComfyUI
python3.11 -m venv venv
source venv/bin/activate
2. 安装依赖项
pip install --upgrade pip
pip install -r requirements.txt
四、模型下载与归位
推荐使用命令行极速下载并自动归位(支持断点续传)。确保当前在 ~/ComfyUI 目录,且虚拟环境已激活。
1. 下载主模型
hf download Comfy-Org/z_image_turbo --local-dir models/diffusion_models --include "split_files/diffusion_models/z_image_turbo_bf16.safetensors"
# 整理目录
mv models/diffusion_models/split_files/diffusion_models/z_image_turbo_bf16.safetensors models/diffusion_models/
2. 下载文本编码器(Qwen 4B)
hf download Comfy-Org/z_image_turbo --local-dir models/text_encoders --include "split_files/text_encoders/qwen_3_4b.safetensors"
# 整理目录
mv models/text_encoders/split_files/text_encoders/qwen_3_4b.safetensors models/text_encoders/
3. 下载配套 VAE
hf download Comfy-Org/z_image_turbo --local-dir models/vae --include "split_files/vae/ae.safetensors"
# 整理目录
mv models/vae/split_files/vae/ae.safetensors models/vae/
如遇网络问题,也可前往 Hugging Face Z-Image-Turbo 官方仓库 手动下载并放入对应文件夹。
五、启动 ComfyUI
确保当前在 ~/ComfyUI 目录,且虚拟环境已激活 (venv)。
运行以下命令启动服务:
python main.py --use-split-cross-attention --preview-method none
启动成功后,在浏览器打开:http://127.0.0.1:8188
六、搭建 Z-Image 专属工作流(极其重要)
不要手动改旧图!直接导入官方模板是最稳妥的做法。
第一步:获取官方图纸
- 访问 ComfyUI 官方的 Z-Image 示例页面。
- 将网页上展示的 Z-Image 工作流图片,直接用鼠标拖拽进你的 ComfyUI 网页画布中松开,系统会自动连好正确的节点。
第二步:在节点中选择本地模型
- Load Diffusion Model 节点: 选
z_image_turbo_bf16.safetensors - Load CLIP 节点: 选
qwen_3_4b.safetensors - Load VAE 节点: 选
ae.safetensors
第三步:安全检查清单(防报错必看)
在点击生成之前,请扫视全图,确保画布上绝对没有以下字样的节点(如果存在,说明你混用了 Flux 工作流,必须删除重拉):
- ❌
Flux2 - ❌
Flux引导 (FluxGuidance) - ❌
Flux2调度器 (Flux2Scheduler) - ❌
空Latent图像 (Flux2)
七、推荐参数(极速出图)
Z-Image-Turbo 是一款主打极速响应的模型,不要使用传统模型 20 步以上的习惯。
默认高质量参数
- 宽度 / 高度:
1024 x 1024 - Guidance(引导系数):
4.0 - Steps(采样步数):
4
快速测试参数
- 宽度 / 高度:
768 x 768 - Steps(采样步数):
2到4
八、原生中文提示词编写
得益于 qwen_3_4b 文本编码器,你可以彻底告别英文标签,直接使用流畅的中文描述画面。
格式建议: 核心画质/风格描述 + 画面主体 + 环境光影 + 氛围细节
中文提示词示例
电影级写实摄影大片。一位身穿白衣的古代侠客站在云雾缭绕的山巅,手里拿着一把长剑。清冷的月光打在他的侧脸上,背景是深邃的夜空和隐约可见的松树。画面对比度高,极具武侠氛围,8k分辨率,极致细节。
生成后的图片默认保存在:~/ComfyUI/output。
配置完毕后,点击 Queue Prompt,体验秒级出图的快感吧。
About The Author