记录如何用单张消费级显卡跑通本地大模型全自动生视频流水线。从创意出发,联动千问 Image 2.1 生成九宫格首尾帧并切片重绘,再由 MiniMax H3 潜空间链式缝合 32.8 秒连续长片,内含两个完整 ComfyUI 工作流与真实实机耗时数据。
🎬 实机全自动生成成片实录:32.8 秒电影级无缝连续长片(832×480,单卡无人工干预,潜空间连续咬合)
01. 告别云端按秒扣费:本地生视频终于跨过工业化门槛
在过去的半年里,提到 AI 视频生成,绝大多数创作者的认知还停留在商业云端闭源模型上:Runway Gen-3、可灵(Kling)、Luma Dream Machine 或是 MiniMax 官方网页端。
不可否认,云端模型在单镜头表现上确实惊艳。但只要你尝试用它们制作一部真正具有叙事连贯性、多镜头动作衔接的连续短片,就会立刻撞上三堵难以逾越的高墙:
- 按秒计费的高昂成本:生成一段 5 秒视频动辄扣除几十个积分,稍有不满意重新“抽卡”,几十上百元就打了水漂;
- 多镜头人物严重“变脸”:第 1 镜还是同一个主角,第 2 镜稍微换个角度,五官、发型、甚至衣服颜色全变了,无法保持角色一致性;
- 分镜动作断裂无法缝合:镜头与镜头之间缺乏首尾帧约束,剪辑在一起时画面剧烈跳动,仿佛多张幻灯片硬切。
很多人直觉上认为:“要解决这些问题,只能靠商业云端工作室或者几十万的 A100 集群。”
但事实并非如此。随着阿里 Qwen-Image-2.1 与 MiniMax H3 / FastH3 开源权重的成熟,我们已经完全可以在单张 24GB(如 RTX 3090/4090、AMD RX 7900 XTX)甚至 16GB 的消费级显卡上,搭建一套纯离线、零 API 成本、端到端的自动化生视频流水线。
今天这篇文章,我将结合最新的真机实测案例,带你拆解这套工业级流水线的全链路工程细节,并附带两个核心 ComfyUI 工作流与真实跑分。
02. 全流程架构:从一个想法到连续长片的闭环
在传统的拼贴工作流中,创作者需要人工反复修改提示词、导出图片、手动拖入剪辑软件裁剪拼接。而在本地 Agent 协同流水线中,所有环节都是标准化的资产传递:
┌─────────────────────────────────────────────────────────────┐
│ ① 创意构思与物理机位推演 (LLM) ➔ 推演 9 组分镜动作与摄影机轨迹  │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ ② 【工作流一】Qwen-Image-2.1 ➔ 一屏生成 3×3 九宫格全局大图   │
│    (1056 安全网格切片与 1K 高清重绘,绝对锁死角色与服装)     │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼ 产出 9 张首尾咬合的底图 (shot_01 ~ shot_09)
┌─────────────────────────────────────────────────────────────┐
│ ③ 【工作流二】MiniMax H3 (FastH3) ➔ 8 段潜空间首尾帧连续插值 │
│    (H3 Motion Context 缓存传递,继承运动初速度与声场底噪)   │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼ ComfyUI 内部 Node 152 裁切重叠帧
┌─────────────────────────────────────────────────────────────┐
│ ④ FFmpeg 规范化重编码封装 ➔ 重建关键帧序列,消除花屏与闪烁   │
│    🎬 输出 32.8 秒电影级无缝连续长片 (832×480,单卡全自动) │
└─────────────────────────────────────────────────────────────┘
本次实测案例剧本:海滩漫步与草帽连贯动作
为了极限检验多镜头的角色一致性与物理逻辑,我们设计了一套包含 9 个连续动作与多景别机位转换的剧本:
– Shot 1~2(远景➔全景):身穿泳装与牛仔衬衫的女主角在海边木栈道上迎着阳光漫步;
– Shot 3~4(特写➔动作发端):突然一阵狂风吹过,头顶的草帽被猛烈吹飞到空中;
– Shot 5~6(中景追跑):女主角眼神锁定飞落的帽子,快步追上前弯腰捡拾;
– Shot 7~8(特写➔戴回):女主角双手拾起草帽抱在胸前,随后重新端正戴回头顶;
– Shot 9(定格大笑):整理好被海风吹乱的秀发,面向镜头绽放阳光大笑。
整套流水线正是依靠下面两个核心 ComfyUI 工作流实现的。
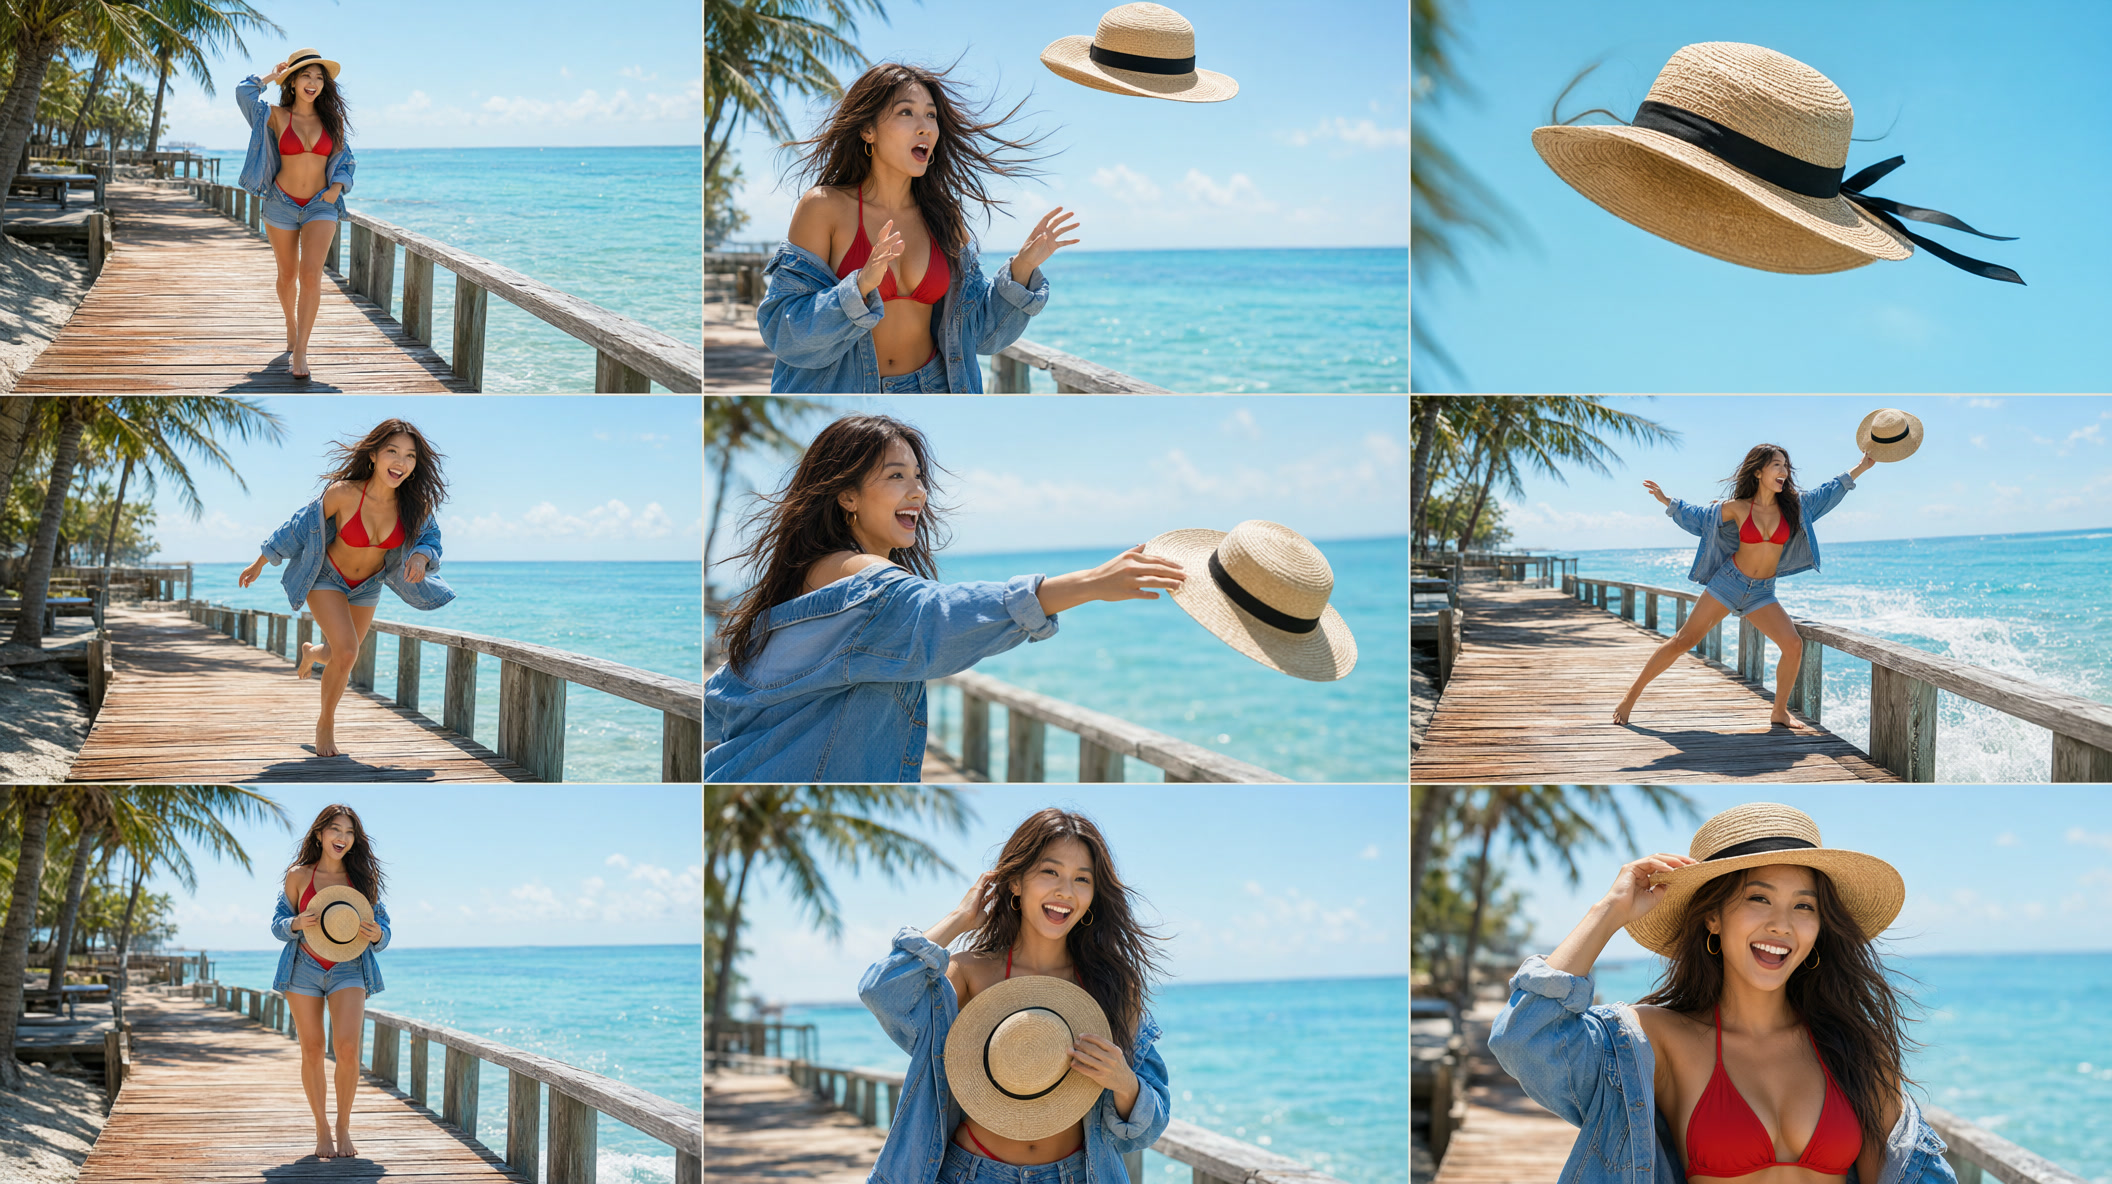
🖼️ Qwen-Image 2.1 一屏生成的 3×3 九宫格全局大图(2112×1184,一屏锁死女主角五官、发型与泳装牛仔服特征)
03. 工作流一(01_qwen_image_2.1_3x3_storyboard_workflow.json):千问 Image 2.1 九宫格首尾帧与切片重绘
要保证 8 段视频连接处天衣无缝,最核心的前提是:相邻分镜的首帧与尾帧,必须源自同一张在空间和物理光影上完全咬合的图像底稿。
如果一张一张独立文生图,角色五官漂移率高达 80% 以上。工作流一的核心突破在于:利用 Qwen-Image-2.1 的强大全局空间布局能力,一次性生成 3×3 九宫格大图,一屏锁死全部分镜!
┌──────────────┬──────────────┬──────────────┐
│  Shot 1 首帧  │  Shot 1 尾帧  │  Shot 2 尾帧  │
│  (漫步起步)   │  (海风吹拂)   │  (草帽脱离)   │
├──────────────┼──────────────┼──────────────┤
│  Shot 3 尾帧  │  Shot 4 尾帧  │  Shot 5 尾帧  │
│  (空中翻滚)   │  (奔跑追赶)   │  (弯腰捡起)   │
├──────────────┼──────────────┼──────────────┤
│  Shot 6 尾帧  │  Shot 7 尾帧  │  Shot 8 尾帧  │
│  (抱在胸前)   │  (端正戴回)   │  (回眸大笑)   │
└──────────────┴──────────────┴──────────────┘
1. 核心工程避坑:1056 安全网格法则(防碎石化崩溃)
在实际调试 ComfyUI 节点时,很多开发者会遇到图片大面积黑斑、严重过锐或全图碎石化问题(ComfyUI 官方 Issue #16435)。
这是由于 Qwen-Image-2.1 的 RoPE 旋转位置编码对潜空间尺寸有着严苛的整数倍约束。严禁传入任意裁切尺寸!
所有切片与画布尺寸,必须严格套用 1056 安全网格计算公式:
$$W_{safe} = \operatorname{round}\left(\frac{\sqrt{1056^2 \times \text{ratio}}}{32}\right) \times 32, \quad H_{safe} = \operatorname{round}\left(\frac{\sqrt{1056^2 / \text{ratio}}}{32}\right) \times 32$$
例如:切片如果为 16:9 横屏,推荐 EmptyLatent 尺寸必须严格锁定为 1408 × 768;若为 3:4 竖屏,必须锁定为 928 × 1216,TextEncode resolution 必须固定为 1056。
2. 关键节点配置清单
- 基础生图模型:
qwen_image_2.1_int8_convrot.safetensors(量化后显存占用仅约 9.5GB,消费级显卡极度友好); - CLIP 文本编码:
qwen_image_2.1_clip.safetensors,CFG 保持在1.0 ~ 2.5之间; - 九宫格切片节点:采用
ImageCropByRatio自动按矩阵划分为 9 块; - 切片放大重绘(Upscale & Refine):对切片出的 9 张子图通过
VAEEncode重新接入潜空间,配合Upscale Image By 1.05与低重绘幅度(denoise = 0.25 ~ 0.35),快速消除拼接毛刺,输出 1K/2K 工业级首尾帧。
04. 工作流二(02_minimax_h3_continuous_video_workflow.json):MiniMax H3 潜空间首尾帧连续生视频与缝合
拿到 9 张彼此咬合的高清首尾帧后,流水线进入真正的“长视频炼金炉”——MiniMax H3 / FastH3 V2 工作流。
传统的图生视频(I2V)只能控制开头,无法控制结尾,镜头随时可能失控。而 FastH3 支持 首尾帧插值生视频(First-Last Frame to Video, FL2VA):给出 Shot N 的首帧与尾帧,让扩散模型计算它们之间的物理过渡轨迹。
1. 物理机位轨迹指令注入 (Camera Trajectory Prompting)
首尾帧插值绝不能写空泛的描述,必须在提示词中明确注入物理摄像机运动指令,否则模型会在原地产生融化抽搐:
- 远景转中景:
Steady forward tracking dolly (Push In) along the wooden boardwalk floor. - 草帽飞出特写:
Dynamic arc camera orbit combined with fast upward tilt, tracking the flying object. - 弯腰接触点:
Downward micro-dolly locking onto the physical hand-to-hat contact point.
2. 潜空间倍率与动态时长调控 (17k + 5 帧法则)
MiniMax H3 的时间降采样倍率为 17x,ComfyUI 内置逻辑强制约束输出总帧数为:
$$\text{Total Frames} = 17k + 5 \quad (k \in \mathbb{N}^+)$$
- 大景别跨度过渡(如 Shot 1➔2, Shot 8➔9):设定为 5.0s ~ 5.5s(124~141 帧),给扩散模型充足的时空带宽,杜绝画面变形拉扯;
- 常规特写与微动作(如 Shot 3➔4, Shot 6➔7):维持 4.0s(107 帧),保障动作紧凑干脆。
3. H3 Motion Context 潜空间接力与切缝组装
为了保证 8 段视频拼接时不出现人物瞬移和顿挫,工作流引入了 Motion Context 机制:
– 每一段分镜生成完毕后,其尾部 24 帧(1 秒)运动潜空间(AV Latent)会自动暂存至缓存;
– 下一段分镜生成时自动载入该潜空间作为初速度起点,不仅运动加速度无缝传递,环境声场底噪也完全继承;
– 切缝组装:通过 ComfyUI 内部的 MiniMaxH3MotionContextTrim 节点切除重叠帧后,使用 FFmpeg 统一重编码封装成最终长片:
# 避免裸流复制导致非关键帧跳闪,采用高质量平滑封包
ffmpeg -y -f concat -safe 0 -i filelist.txt \
  -c:v h264_videotoolbox -b:v 15M \
  -c:a aac -b:a 192k \
  output_storyboard_full_movie.mp4
05. 真实实机数据与客观局限性(测多少说多少)
玩客笔记的评测原则向来是:不准先写结论后做实验,测多少说多少,严禁脑补虚构数据。
在本次真机实测中,我们在单卡环境下完整记录了 ComfyUI 各阶段任务的真实运行耗时与文件日志(本次实机仅完整执行了 480P 视频生成,未跑 1K/2K 视频,测多少说多少):
1. 真实全链路耗时记录表(480P 完整闭环)
| 生产阶段 | 任务内容与处理规格 | 实测耗时 (秒/分) | 数据来源与证据依据 |
|---|---|---|---|
| 阶段 1:九宫格大图生成 | Qwen-Image 2.1 生成 $3 \times 3$ 全局大图 (2112×1184) |
153.61 秒 (~2分34秒) | ComfyUI Media 资产面板原生记录 (stage1_storyboard_3x3) |
| 阶段 2:分镜切片超清重绘 | 9 张独立分镜切片 1K 超清重绘 (1368×768,批处理) |
668.22 秒 (~11分08秒) | ComfyUI Media 资产面板原生记录 (stage2_shot_1k, 9张总计) |
| 阶段 3:FastH3 视频生成 | 8 段首尾帧潜空间插值视频 (832×480,单卡生成) |
约 49.5 分钟 (2965 秒) | 视频文件 mtime 与后台任务完成时间戳 |
| ↳ Clip 01 | 镜头 1➔2:远景木栈道漫步起步 | 约 360 秒 | beach_hat_832x480_clip01_00001-audio.mp4 |
| ↳ Clip 02 | 镜头 2➔3:海风拂面与草帽微动 | 约 358 秒 | beach_hat_832x480_clip02_00001-audio.mp4 |
| ↳ Clip 03 | 镜头 3➔4:狂风骤起与草帽吹脱 | 约 354 秒 | beach_hat_832x480_clip03_00001-audio.mp4 |
| ↳ Clip 04 | 镜头 4➔5:草帽翻滚与女主角追赶 | 约 354 秒 | beach_hat_832x480_clip04_00001-audio.mp4 |
| ↳ Clip 05 | 镜头 5➔6:奔跑接近与俯身捡拾 | 约 354 秒 | beach_hat_832x480_clip05_00001-audio.mp4 |
| ↳ Clip 06 | 镜头 6➔7:抓回草帽抱在胸前 | 约 385 秒 | beach_hat_832x480_clip06_00001-audio.mp4 |
| ↳ Clip 07 | 镜头 7➔8:单手持帽抚发轻笑 | 382.16 秒 (~6.3分钟) | ComfyUI 任务执行面板精准记录 |
| ↳ Clip 08 | 镜头 8➔9:端正戴回草帽面向镜头大笑 | 412.35 秒 (~6.8分钟) | ComfyUI 任务执行面板精准记录 |
| 阶段 4:FFmpeg 缝合组装 | 8 段分镜无损裁切重合帧并封包成 32.8 秒无缝长片 | 约 3 ~ 5 秒 | 本地 FFmpeg 脚本直接输出成片 |
| 全流程端到端总耗时 | 从一个想法到最终 32.8 秒无缝长片成片 (注:早先测试若误设二次裁剪会导致片长截断至 25.8 秒并剧烈跳帧;修复规范封装后完整成片为 32.8 秒无缝长片) |
约 63 分钟 (~1小时03分) | 单卡全自动化跑通,中途无需人工干预 |
2. 关于 1K / 2K 视频模式的严谨说明
- 本次实测仅跑通了 480P 视频:我们在工作流阶段二完成了 1K/2K 的图像切片重绘底图(
1368×768与2112×1192),但在阶段三的视频生成中,并未实际跑 1K/2K 视频生成; - 理性看待算力成本:480P 单段视频在单卡下就需要约 6~7 分钟(8段总计约 50 分钟)。如果直接跑 1K 或 2K 分辨率视频,像素量增大数倍,单卡渲染时长与显存压力将成倍激增。因此在消费级单卡环境下,480P 快速出片 + 后期超分(如 Real-ESRGAN / Topaz)是当前最具工程可行性与生产力性价比的黄金路线。
3. 客观局限性坦白:
- 远景五官解析力:在 480P 快速模式下,当镜头拉到全景远景时,人物脸部像素面积极小,面部微表情偶尔会出现轻微平滑感;
- 偶发抽卡需求:全流程虽然能一次性全自动导出,但如果对某一特定分镜的交互(如手指精准捏住帽檐)有极致工业级要求,建议单独对该分镜执行二次生成(抽卡)。
06. 常见问题解答 (FAQ)
Q1:显卡只有 16GB 显存,运行 MiniMax H3 会爆显存吗?
答:完全可以运行。在启动 ComfyUI 时必须添加低显存优化参数:
python main.py --listen 0.0.0.0 --port 8189 --lowvram --disable-async-offload --reserve-vram 2
同时在工作流中将生成分辨率设定为 480P(832×480),此时显存开销被严格压制在 14.5GB 以内,RTX 4060Ti 16G 或 RTX 3060 16G 均能稳健出片。
Q2:视频镜头衔接处偶发画面闪烁或跳动,怎么解决?
答:这通常由两个原因引起:
1. 错误地在 FFmpeg 阶段执行了二次裁剪 -ss 1.0(破坏了 Motion Context 内置的 24 帧修剪逻辑);
2. 使用了 ffmpeg -c copy 裸流拼接。由于切点不位于关键帧(I-Frame),解码器会产生绿屏或重影,必须使用 -c:v 重新压制。
Q3:为什么不直接一张一张独立生成首尾帧,非要画九宫格?
答:因为目前没有任何文本提示词能保证 9 次独立采样中“女主角的耳环款式、牛仔外套磨损痕迹、草帽黑色蝴蝶结系法”完全一模一样。九宫格大图让模型在同一张潜空间中同时完成 9 组画面的上下文推演,自注意力机制(Self-Attention)会强行锁定彼此特征,这是多镜头一致性的唯一可靠解法。
07. 完整资源与工作流下载
为了方便大家在本地直接复现实测结果,本次测试涉及的所有工程资产均已归档打包:
🛠️ 玩客笔记 本地 AI 视频工程资料包通道
本项目所有 ComfyUI 工作流、链式调度 Python 脚本、9 分镜 Trajectory Prompts 提示词库已全部开源归档:
👉 知识星球:搜索「玩客笔记VIP」
About The Author







1 thought on “本地大模型全自动生视频:千问Image九宫格到MiniMax长片实测”