一句“你好”吃掉 31K 上下文?开源工具 skill-context-doctor 帮你为 AI Agent 瘦身
随着 Claude Code、Codex、PI CLI、Cursor 等工具的高频使用,很多开发者的本地环境不知不觉装了上百个 Skills。本文通过一个“开局一句话吃掉 31K 上下文”的真实排查案例,剖析 Agent Skill 隐形占用 System Prompt 的机制,并介绍专为此设计的开源审计与无损优化工具 skill-context-doctor。
01. 你的 AI Agent,是否也患上了“Skill 囤积症”?
在日常使用 Claude Code、Codex、PI CLI、Cursor 或 OpenCode 等 AI 编程助手时,许多开发者的本地环境都会经历这样一条相似的演进轨迹:
- 发现一个不错的开源 Skill 套件,直接一键全量安装;
- 看到某个好用的工具脚本,复制进
.agents/skills或软链接过来; - 多个 Agent 客户端共用同一套目录,交叉引用;
- 几个月下来,本地悄然累积了 几十甚至两三百个 Skills。
很多人的直觉是:“工具装得越多,Agent 懂的越多,能力自然越强。”
但事实恰恰相反。
为了让大模型具备自主工具规划(Tool-Use Planning)的能力,主流 Agent 框架在初始化会话时,普遍会将所有可用 Skill 的元数据(名称、Description 描述、路径等)无差别注入到 System Prompt 中。这是目前 Agent 架构为了自主性而做出的工程妥协。
这就导致了一个极其隐蔽的性能杀手:你装了但从来没用过的 Skill,每分每秒都在吞噬你宝贵且昂贵的上下文窗口。
02. 一个真实案例:一句“你好”,60% 上下文先没了
skill-context-doctor 这个项目的诞生,不是为了“造一个轮子”,而是源于我自己在 PI CLI 中遇到的一次真实崩溃现场。
某天,我新开了一个干净的会话窗口,仅仅敲入了一句测试指令:
你好
当查看当前的上下文用量时,终端显示出来的数字让我愣住了:
31K tokens / 约 50K 可用窗口
业务工作一行代码都还没写,60% 左右的上下文窗口已经被消耗殆尽。
深度排查:究竟是谁偷跑了 31K Token?
我拉出当前会话完整的 System Prompt 进行分词统计,发现大头既不是历史聊天记录,也不是 MCP Server 的工具定义,而是本地环境里累积的 276 个 Skills。
每个 Skill 虽然没有把几千行的代码或长文全部塞进 Prompt,但它的 name、description 和 location 都会常驻。几百个累加起来,硬生生把基础 Prompt 堆到了 31K Tokens。
更夸张的是接下来的使用率审计。
我扫描了机器上的 183 个 Everything Claude Code(ECC)Skills,并通过日志分析脚本对 125 个真实历史会话日志 进行了完整复盘,匹配以下调用证据:
– 显式调用:/skill:<name>
– 核心读取:read .../SKILL.md
– 命令行查看:bash cat/head/sed .../SKILL.md
审计结果令人哭笑不得:
| 183 个 ECC Skills 实际状态 | 数量 | 占比 | 代表案例 |
|---|---|---|---|
| 真正存在调用证据 | 6 | 3.3% | accessibility, fal-ai-media, django-tdd 等 |
| 仅在上下文中被文件名提及 | 103 | 56.3% | 搜索或列表扫描时路过,从未真正执行 |
| 完全没有任何出现记录 | 74 | 40.4% | 从安装第一天起就在“吃白食” |
这意味着:安装数量与实际生产力完全脱节。 95% 以上常驻上下文的 Skill,纯粹是在白白消耗资源、增加注意力漂移风险并拖慢回复速度。
优化思路:不是暴力删除,而是精准隐藏
直接把 Skill 目录删掉固然省事,但后续万一要用怎么办?多 Agent 共用的软链接断了怎么办?
最佳方案是:让绝大部分低频 Skill 退出默认的 System Prompt 自动暴露机制,但在需要时依然保留随时手动唤醒的能力。
通过将低频 Skill 标记隐藏,保留真正高频的入口:
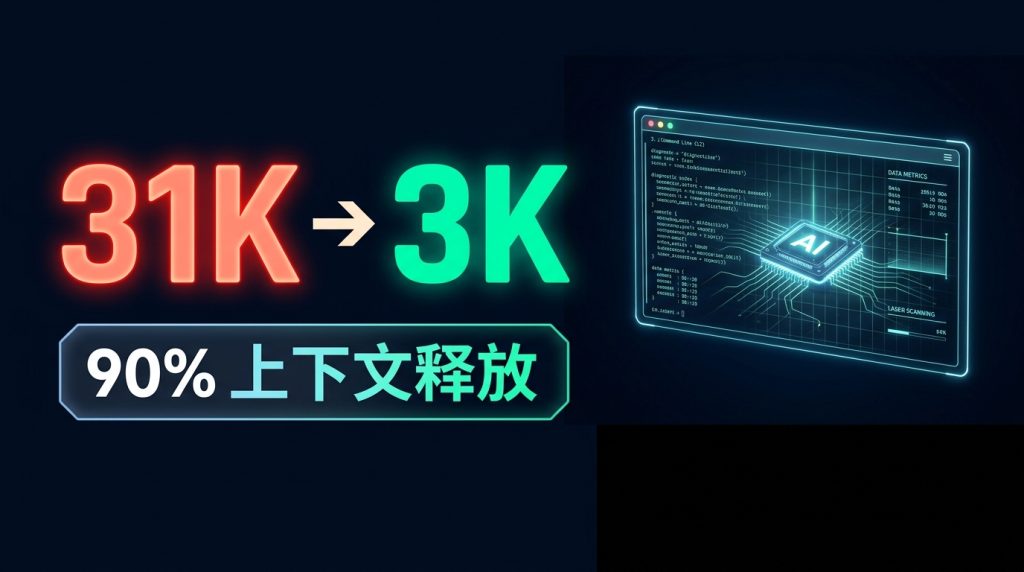
– 模型自动可见 Skill:276 个 → 16 个
– System Prompt 基础开销:31K → 3K Tokens
– 总上下文启动占用:32K → 4K Tokens
固定上下文常驻开销直接暴降 90%!
而那些被隐藏的 Skill 依然完好无损地躺在本地,需要使用时敲一行 /skill:xxx 即可秒级加载。
这次排查沉淀下的核心工作流,最终被我固化成了开源工具:skill-context-doctor。
03. 认识 skill-context-doctor
skill-context-doctor 是一个专为 AI Agent Skill 设计的使用审计、Token 成本透视与安全优化 CLI。
- GitHub 开源仓库:yang2020chen/skill-context-doctor
- npm 全局安装:
npm install -g skill-context-doctor - 支持环境:Claude Code、Codex、PI、OpenCode、Cursor
它不强求你全量安装,直接通过 npx 即可在几秒内看清本地环境的“亚健康”状况:
npx skill-context-doctor audit
整个工具围绕一套严谨的四步闭环构建:
┌─────────────────┐
│   1. Audit      │  全面盘点:真实使用历史、闲置周期、Token 占用与断链检测
└────────┬────────┘
         ▼
┌─────────────────┐
│  2. Recommend   │  确定性规则决策:给出 KEEP / HIDE / REVIEW / REMOVE 建议
└────────┬────────┘
         ▼
┌─────────────────┐
│  3. Optimize    │  安全无损降噪:默认 Dry Run,仅写入隐藏标记,保留手动调用
└────────┬────────┘
         ▼
┌─────────────────┐
│    4. Undo      │  高可靠事务回滚:SHA-256 校验,带防冲突覆盖保护
└─────────────────┘
04. 核心工作流实测
1. Audit:看清楚到底发生了什么
运行审计指令:
npx skill-context-doctor audit
控制台会即刻输出一份结构化诊断面板:
Skill Context Doctor
--------------------------------------------------
Skills discovered:       207
Installations:           316
Model-visible:           137
Actually used:            88
Stale (>30d):             40
Never used:              119
Duplicate groups:         51
Broken installations:      1

Estimated Context Overhead:
Visible skill metadata:  ~10.8K tokens
它不单单统计数量,更能洞察:
– 历史真实痕迹:不仅看有没有装,更结合日志分析最后调用时间;
– 状态分流:区分哪些真正暴露给模型(Model-visible),哪些已经被隐藏;
– 环境坏味道:揪出无效软链接、损坏配置与多处重复安装;
– 成本量化:直接换算出这些元数据常驻占用的 Token 估值。
2. Recommend:规则明确,拒绝“AI 黑盒推荐”
分析完数据后,运行建议指令:
npx skill-context-doctor recommend
工具会依据明确的确定性规则,对每一个 Skill 分类:
– KEEP:高频活跃使用,继续保持可见;
– HIDE:长期不用或从未使用,但元数据占用显著,建议退出默认注入;
– REVIEW:存在依赖关联或异常,需人工核对;
– REMOVE CANDIDATE:已失效的孤儿软链接或彻底损坏的配置。
例如:
xlsx
  Recommendation: HIDE
  Reasons:        MODEL_VISIBLE | NEVER_USED | HIGH_CONTEXT_COST
  Visible Tokens: 236
逻辑一目了然:该工具在 System Prompt 中常年吃掉 236 个 Token,但在历史会话中从未被触发过。它最好的归宿不是删掉,而是配置 disable-model-invocation: true 退出默认感知。
3. Optimize:外科手术式优化,绝不破坏环境
执行优化时,默认完全处于 Dry Run 模式,绝不贸然动你的磁盘:
npx skill-context-doctor optimize
它会提前预览本次操作将隐藏多少 Skill、预计释放多少 Token 上下文,以及哪些 Skill 受到规则保护被跳过。
只有当你明确带上 --apply 时,才会真正执行:
npx skill-context-doctor optimize --apply
Optimize 的原则是“隐蔽”而非“毁灭”:
它只会在配置中追加disable-model-invocation: true。所有 Skill 源码都在本地,随时可以按需唤起。
如果你想更稳健地渐进式优化,支持极其精细的过滤控制:
# 只优化指定的一个 Skill
npx skill-context-doctor optimize --apply --only xlsx

# 只处理 Token 占用最大的前 3 个 Skill
npx skill-context-doctor optimize --apply --limit 3

# 强制豁免保留某些关键 Skill,即便它最近没被调用
npx skill-context-doctor optimize --apply --keep hyperframes
4. Undo:带冲突感知的事务级回滚
很多开发者不敢用自动化优化脚本,最大的顾虑是:万一改坏了环境,找不回来怎么办?
skill-context-doctor 在底层引入了类似数据库事务的安全保护机制:
– 备份与指纹:修改前做全量字节级备份,计算 SHA-256 哈希;
– 原子操作:原子化写入,保留原有的 POSIX 文件权限;
– 自动 Rollback:写入过程一旦发生任何异常,自动回滚至初始状态。
如果你想撤销操作,只需执行:
npx skill-context-doctor undo latest
更贴心的是,如果你在执行优化之后,自己又手动编辑过那个 Skill 文件,Undo 时哈希校验会立即拦截,并报出:
CONFLICT_AFTER_OPTIMIZE
宁愿放弃自动回滚,也绝对不会强行覆盖你后来手写的心血代码。
05. 进阶玩法:支持 JSON 与工程化集成
对于重度开发者或团队工程基建,所有子命令均原生支持 --json 参数:
npx skill-context-doctor audit --json
npx skill-context-doctor recommend --json
npx skill-context-doctor optimize --json
你可以轻松把它接入团队的 CI/CD 流程、本地环境初始化脚手架,或是定期跑在 cron job 中,保持开发环境的清爽轻盈。
06. 快速开始与项目信息
极速上手(免安装)
无需全局安装,终端直接跑:
# 1. 跑一次体检
npx skill-context-doctor audit

# 2. 查看优化建议
npx skill-context-doctor recommend

# 3. 模拟优化,看看能省多少 Token
npx skill-context-doctor optimize
全局安装(常用推荐)
npm install -g skill-context-doctor

# 核心命令速查
skill-context-doctor audit
skill-context-doctor recommend
skill-context-doctor optimize --apply
skill-context-doctor undo latest
项目背景与开源信息
- 项目名称:
skill-context-doctor - GitHub 开源仓库:yang2020chen/skill-context-doctor
- 协议与致谢:项目基于开源项目
vltansky/skillkill(MIT 协议)演进重构,完整保留原项目版权与 Attribution。 - 开发状态:当前处于 Feature Complete(功能完整)维护状态。核心能力已闭环,后续不盲目追求堆砌功能,专注于修复真实场景反馈与多 Agent 兼容性。
07. 写在最后:AI 时代的“数字断舍离”
大模型时代的工程实践往往会给我们一种错觉:功能越多越强,插件装得越满越专业。
但现实往往是骨感的:过载的元数据挤压了推理空间,分散了注意机制,甚至导致幻觉与工具误选。
如果你正在使用的 Claude Code、Codex 或 PI 环境已经运行了几个月,建议不妨在终端敲一行:
npx skill-context-doctor audit
看一看究竟有多少工具在默默陪跑,又有多少真正参与了生产。
有时候,让 AI Agent 变聪明、变敏捷的第一步,不是继续教它新本领,而是果断把它根本用不上的东西请出上下文。
欢迎在评论区晒出你的体检截图,看看你的 Agent 被偷跑了多少 Token!
About The Author