AI Benchmarks Local AI Deployment Qwen 3.8 125B MoE on Dual RX 7900 XTX: 48K Context at 28 Tok/s Benchmark & Guide 玩客 2026年9月18日 0 Benchmark & deployment guide for Qwen 3.8 125B on...Read More
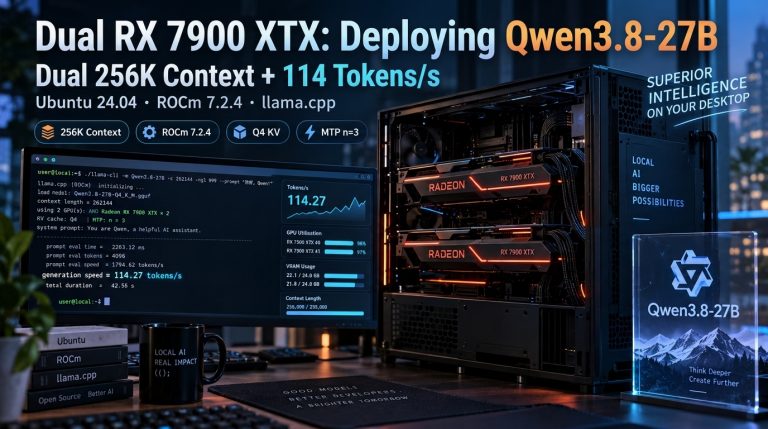
AI Benchmarks Local AI Deployment Deploying Qwen3.8-27B on Dual RX 7900 XTX: Dual Independent 256K Context at 114 Tokens/s (Ubuntu 24.04 + ROCm + llama.cpp) 玩客 2026年9月14日 0 How to deploy Qwen3.8-27B across dual AMD Radeon RX...Read More