RTX 3080 10GB 极限挑战 125B 大模型:Speedy 部署与实测指南|玩客笔记
实机环境:Ubuntu 24.04 LTS | AMD Ryzen 7 3700X | 96GB DDR4 | GeForce RTX 3080 10GB (Ampere sm_86)
实测模型:Qwen3.8-Flash-Next GSQ-RCO IQ3_S(125B 主体参数 + 51B N-gram 查找表 + 4B MTP 推测头)
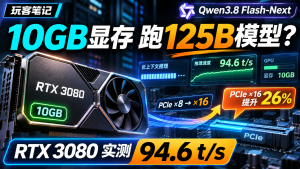
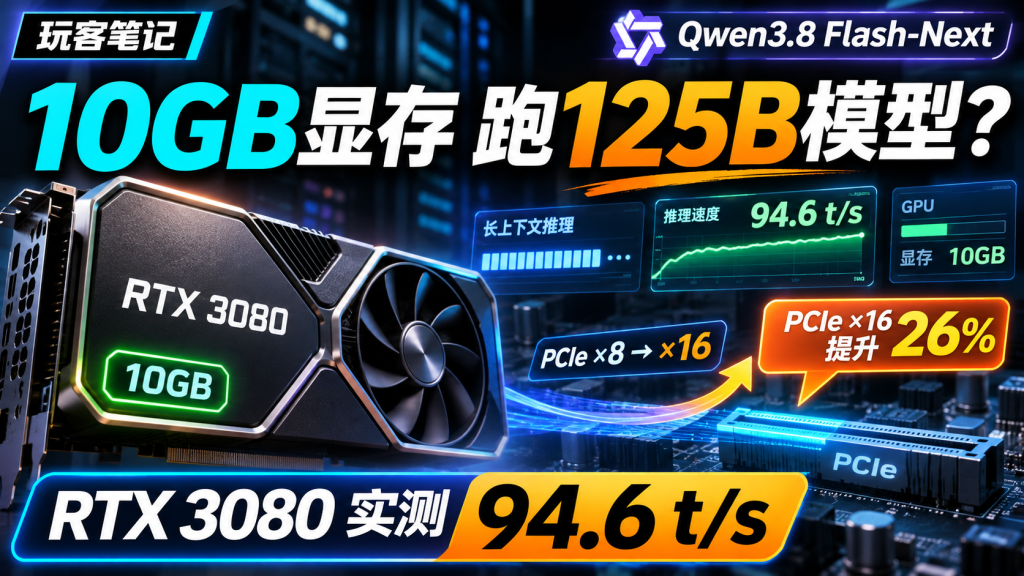
实测战报:短文本单次生成峰值 94.6 tokens/s | 2K~200K 全上下文生成中位数 87.2 tokens/s | PCIe 4.0 ×16 满血直连预填充提速 +26.0%
一、打破“显存不够必然卡死”的固有认知
在本地大语言模型的传统认知中,一直存在一条近乎不可逾越的“容量铁律”:
一旦模型的参数量超出显卡的物理显存,常规推理框架(如原生 llama.cpp 的纯 CPU Offload 方案)就会被迫在 PCIe 总线上进行全量权重的频繁搬运,导致生成速度瞬间断崖式下跌至 1~2 tokens/s,体验如同幻灯片。
然而,面对总下载量高达 83.6 GB、主体参数量达 125B 的通义千问最新架构旗舰模型 Qwen3.8-Flash-Next,我们在手头这台平民级的实机机台上,用一张只有 10GB 显存的 GeForce RTX 3080,跑出了令人惊叹的实测成绩:
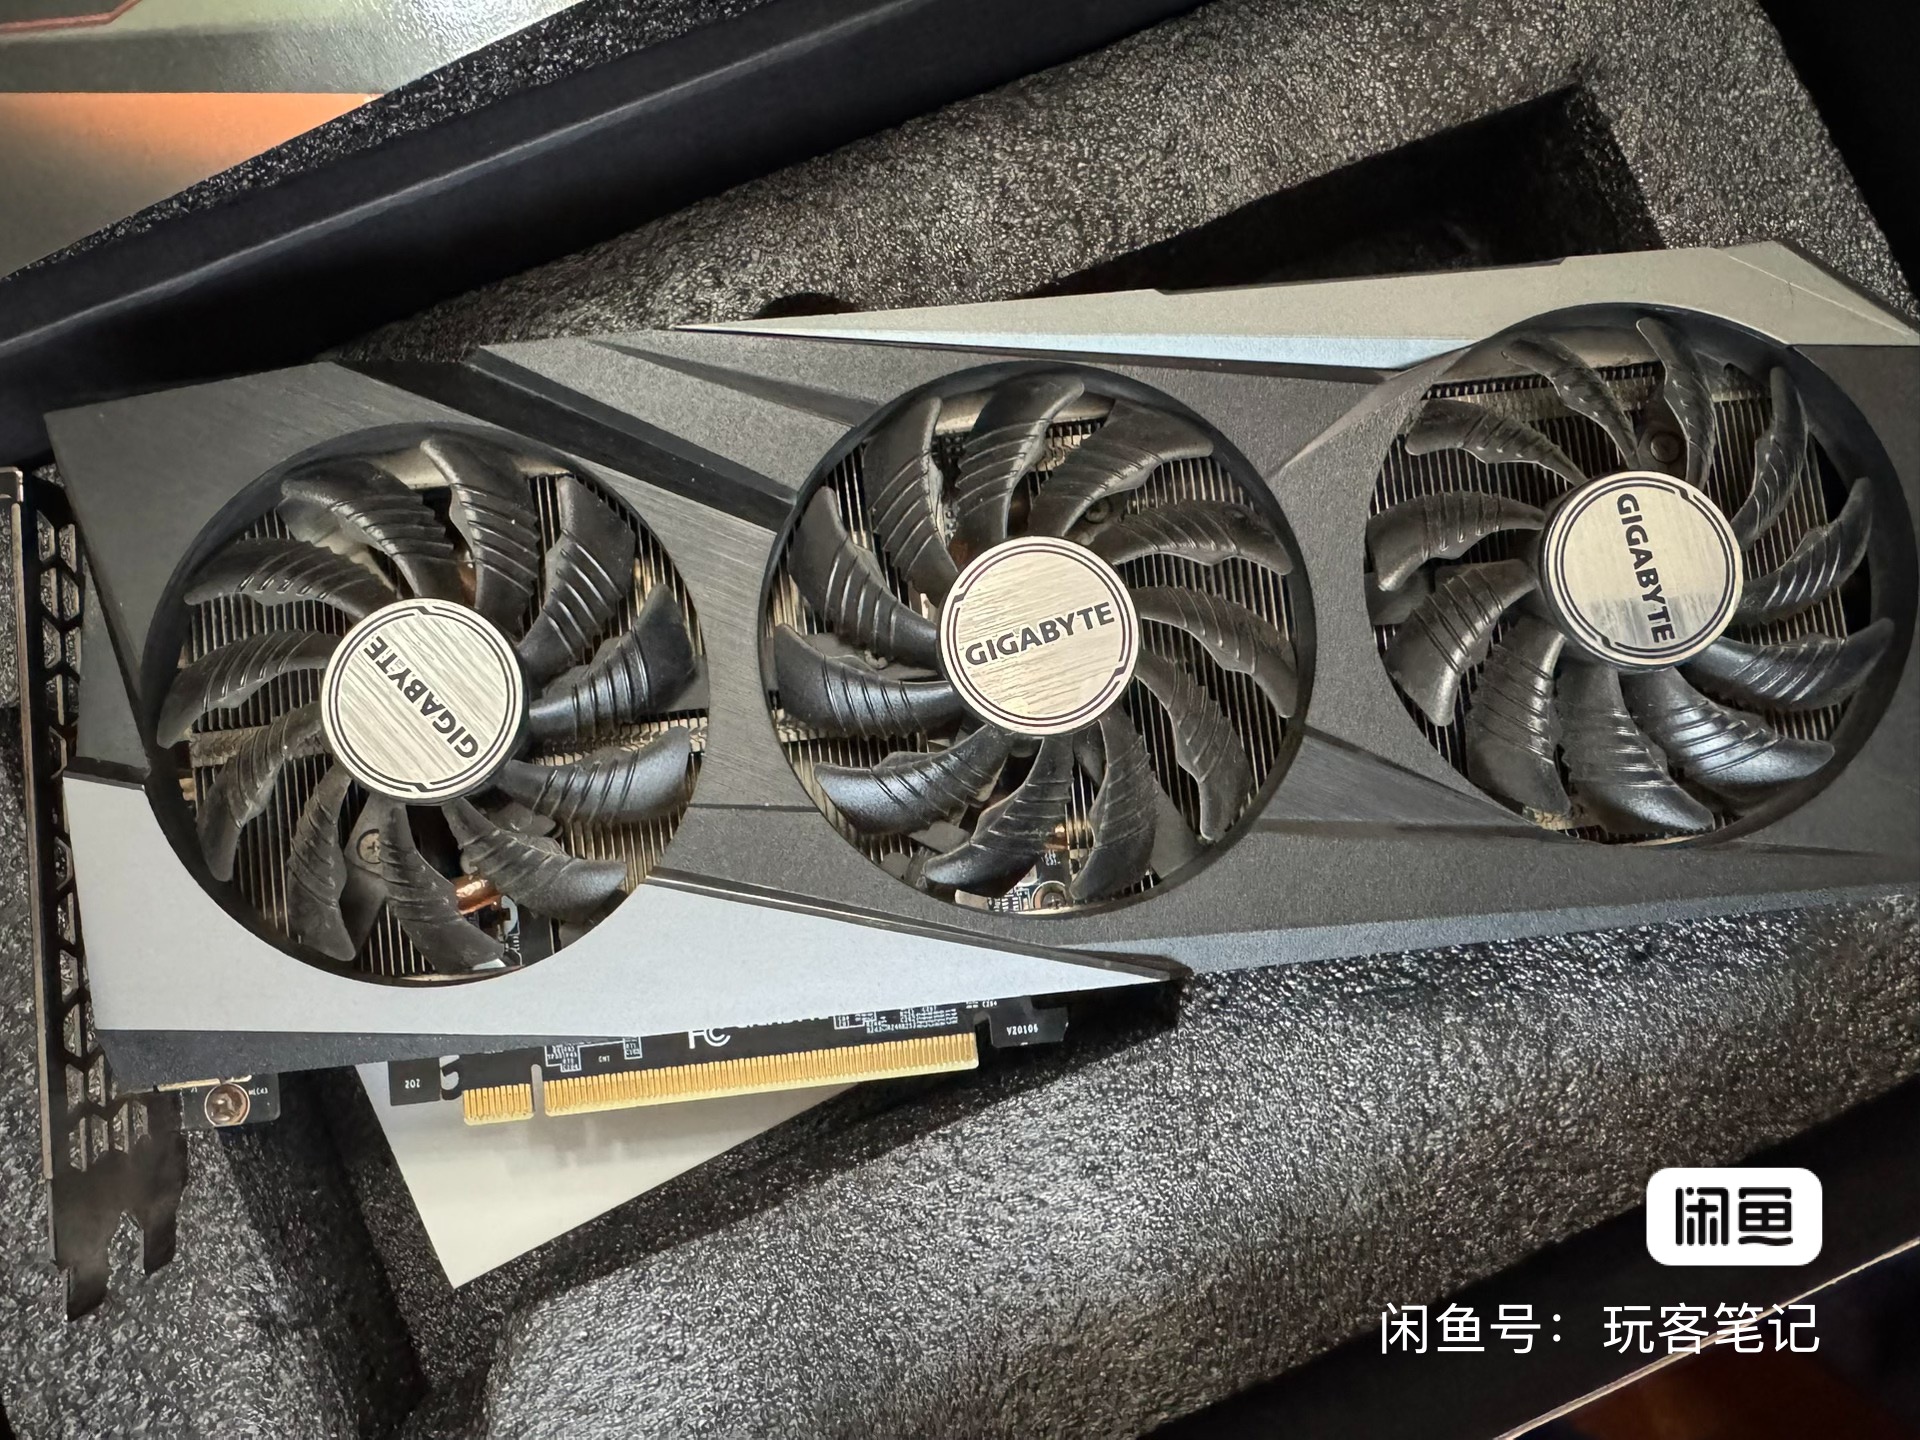
核心实测指标一览:
- 生成速度 (Decode):日常会话打字速度稳定在 94.5 ~ 104.3 tokens/s,即使上下文推到 200K 超长深度,生成速度中位数依然牢牢锁定在 87.2 tokens/s;
- 词间延迟 (ITL):平均词间间隔仅 10.5 ~ 12.5 毫秒,完全达到人体肉眼阅读的极速瀑布流体验;
- 长文本预处理 (Prefill):在 120K 超长 Prompt 输入下,通过恢复 PCIe 4.0 ×16 满血通道,冷启动耗时直接从 118.9 秒压缩至 94.3 秒,一次性净省近 25 秒!
二、架构解密:Speedy 推理引擎的三把“破局手术刀”
一张 10GB 显存的老显卡,为什么不仅没有爆显存崩溃,反而能飙出近百速?核心秘诀在于模型极致稀疏化架构与 Speedy 推理引擎底层工程调校的紧密咬合:
┌────────────────────────────────────────────────────────────────────────┐
│ 96GB DDR4 系统内存底座:完整驻留 80GB 静态权重与 51B 按需读取 N-gram 查找表  │
└───────────────────────────────────┬────────────────────────────────────┘
                                    │ PCIe 4.0 ×16 (满血 32 GB/s 高速链路)
┌───────────────────────────────────▼────────────────────────────────────┐
│ 10GB RTX 3080 显存核心计算区:                                          │
│  ├─ 刀法 1:MoE 热门专家显存常驻缓存(~1,448 个专家槽位)                │
│  ├─ 刀法 2:异步错峰重叠流水线(内存搬运与 Tensor Core 计算完全并行)     │
│  └─ 刀法 3:MTP 多 Token 推测解码(突破串行吐字物理极限)               │
└────────────────────────────────────────────────────────────────────────┘
- 刀法一:MoE 专家显存缓存 (Expert VRAM Cache)
Qwen3.8-Flash-Next 拥有 512 个混合专家网络,但单步推理极端稀疏——仅激活 Top 10 + 1 个共享专家(激活参数仅约 6B)。Speedy 利用 10GB 显存中开辟的高速槽位,动态常驻约 1,448 个最高频触发的专家权重,命中率高达 80% 以上,极大地避免了总线重复搬运; - 刀法二:异步错峰重叠流水线 (Async Prefetch Pipeline)
在 GPU 计算当前层激活专家的同时,引擎利用后台独立的 DMA 引擎,提前跨 PCIe 总线异步预取下一层所需的未命中专家。计算与搬运完全错峰重叠,显卡算力几乎没有等待空泡; - 刀法三:MTP 多 Token 预测 (Multi-Token Prediction)
传统自回归是一步吐一个词;Speedy 激活了模型内建的 4B 轻量级推测投机头,单次前向直接预测多个候选 Token 并由主模型在同一步验证接收,使等效输出吞吐直接提升了 1.5 ~ 2 倍。
三、EvalScope 自动化压测与基准数据复核
为了保证数据的严谨性,我们杜绝了单次短跑的“幸存者偏差”,采用阿里云官方大模型自动化压测套件 EvalScope 进行了长达数小时的连续梯度压测:
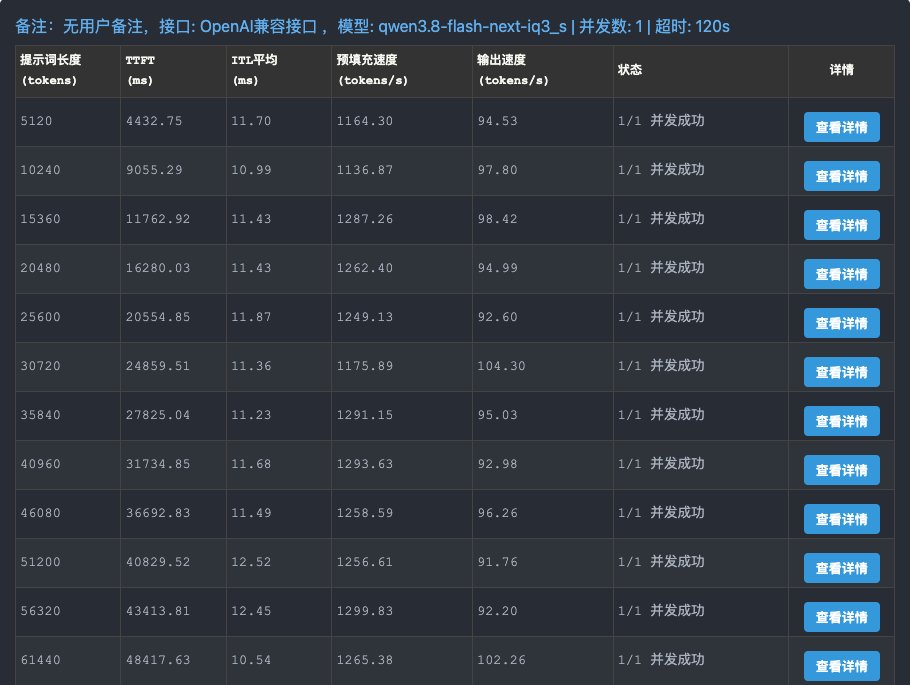
1. 全上下文深度下的稳定性
从 5,120(5K)、10,240(10K)一路阶梯加压到 61,440(61K)上下文深度:
– 输出速度:稳定在 91.76 ~ 104.30 tokens/s 窄幅区间内,没有任何内存泄漏或断崖衰减;
– 首字延迟 (TTFT):从 5K 上下文的 4.4 秒随着文本深度线性平稳过渡;
– 平均预填充速度:全流程保持在 1,136 ~ 1,299 tokens/s 的极速响应水平。
2. 统计总表与真实百分位分布
在最初的非标准打流测试中,曾因打字统计窗口偏差记录过 74 t/s 的读数。随后我们逐行核对 Speedy 原生日志,通过 EvalScope 自动化闭环重新校验,锁定了真实的基线全貌:
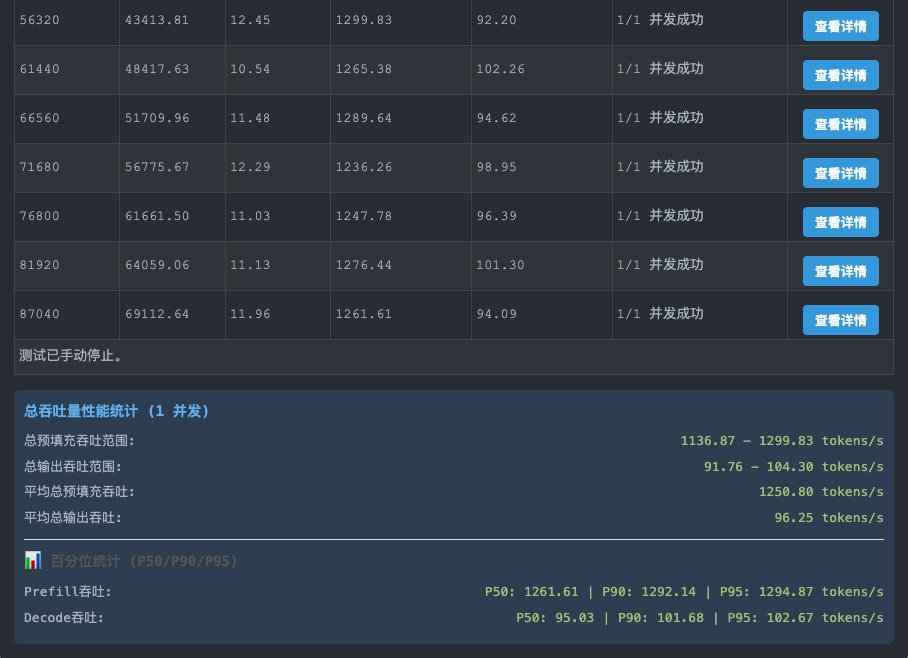
- 平均总输出吞吐:96.25 tokens/s;
- P50 中位数:95.03 tokens/s;
- P90 / P95 高性能段:分别达到 101.68 与 102.67 tokens/s。
四、物理拔卡实测:解开 26% 的预填充性能锁
在软硬件咬合的极端调校过程中,我们曾遭遇过长文本读入变慢的物理瓶颈。排查发现,测试台因为此前安装了副卡,触发了 AMD X570 主板的通道自动拆分机制,主卡 RTX 3080 实际上被限速在 PCIe 4.0 ×8 模式(单向带宽仅 13.38 GiB/s)!
随后我们执行了物理断电拔卡实验,将副卡彻底取下,恢复主卡直通 CPU 的 PCIe 4.0 ×16 满血链路(32 GB/s 理论带宽):
| 测试场景(单并发) | PCIe 4.0 ×8 模式 | PCIe 4.0 ×16 满血模式 | 性能提速幅度 | 节省绝对等待耗时 |
|---|---|---|---|---|
| 32K 输入预填充 | 1,045.3 tok/s (30.7s) | 1,307.6 tok/s (24.5s) | +25.1% | 净省 6.2 秒 |
| 120K 超长文本预填充 | 1,009.8 tok/s (118.9s) | 1,272.7 tok/s (94.3s) | +26.0% | 净省 24.6 秒 |
实测结论:对于依靠主机内存与显存协同交互的百亿/千亿稀疏模型,PCIe 通道带宽是决定长文本首字等待体验的绝对物理生命线!
五、完整部署复现指南(四步手把手实操)
本指南基于配套资料包中的自动化运维脚本设计,建议使用普通非 root 用户在 Ubuntu 24.04 系统下执行。
阶段一:硬件与只读环境预检
在动任何代码之前,必须先核查硬件环境。执行只读检查脚本:
# 运行环境预检脚本(只读无副作用,不停止服务、不修改功耗)
bash scripts/00_preflight.sh
关键核查项:
1. 显卡与驱动:nvidia-smi 正常显示,驱动建议 535/550/570 系列;
2. 总线协商状态:检查 PCI Link Width 是否为 x16(如果是 x8,建议检查主板插槽分配与 BIOS 设置);
3. 系统内存:free -h 确认物理内存总量达到 96GB(DDR4 3200MHz 极佳,若为 64GB 建议调小上下文缓存);
4. 编译依赖:确认系统已就绪 nvcc, cmake, ninja, git, python3。
阶段二:Speedy 源码编译与 CUDA 12 兼容补丁
克隆官方 Speedy 仓库并切至经过实机完全验证的固定提交版本:
# 1. 独立目录准备 Speedy 源码(自动锁定 commit e307537)
bash scripts/01_prepare_source.sh "$HOME/projects/ai-inference/speedy-rtx3080-iq3s"

# 2. 如果系统使用 CUDA 12.0(nvcc 12.0.x),应用 kBatchRoom 兼容性修补
python3 scripts/02_cuda12_kbatchroom_patch.py \
  --repo "$HOME/projects/ai-inference/speedy-rtx3080-iq3s" --apply

# 3. 针对 Ampere 架构(sm_86)编译优化二进制与 Python 虚拟环境
bash scripts/03_build_engine.sh "$HOME/projects/ai-inference/speedy-rtx3080-iq3s"
阶段三:模型与权重资产准备
下载通义千问官方发布的 Qwen3.8-Flash-Next 对应量化版本 ISTA-DASLab IQ3_S GGUF:
# 使用 HuggingFace CLI 下载两分片 IQ3_S GGUF
hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF \
  --include "IQ3_S/*" \
  --local-dir "$HOME/models/Qwen3.8-Flash-Next-GSQ-RCO-GGUF"
使用资料包脚本根据你本机的实际文件绝对路径,自动生成校验过的配置文件:
python3 scripts/04_make_config.py \
  --repo "$HOME/projects/ai-inference/speedy-rtx3080-iq3s" \
  --gguf-1 "$HOME/models/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf" \
  --gguf-2 "$HOME/models/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf" \
  --pack "$HOME/models/packs/iq3_s" \
  --mtp "$HOME/models/mtp/rt" \
  --output "$HOME/projects/ai-inference/speedy-rtx3080-iq3s/configs/rtx3080_iq3s_local.json"
阶段四:启动推理服务与冒烟验证
启动本地 OpenAI 兼容的 Web 推理服务:
# 启动 strata 引擎守护进程(监听 18081 端口)
bash scripts/05_start_server.sh \
  "$HOME/projects/ai-inference/speedy-rtx3080-iq3s" \
  "$HOME/projects/ai-inference/speedy-rtx3080-iq3s/configs/rtx3080_iq3s_local.json"
打开另一个终端,执行冒烟测试探针:
# 发起一次真实的长文本问答冒烟探测
python3 scripts/06_smoke_test.py --url http://127.0.0.1:18081 --send
六、常见问题与深度排障 (FAQ)
Q1:我的内存只有 64GB,能跑得起来这套配置吗?
答:可以启动,但需要精细调控显存与内存水位。模型总静态占用约在 50~55GB 左右。如果只有 64GB 内存,建议在启动配置中将
--conversation-cache-mib缩减到2048,并将--max-context限制在32768以内,避免在长文本前向计算时触发 Linux OOM Killer。
Q2:为什么编译时报错提示 kBatchRoom 未定义或容量超限?
答:这是使用 CUDA 12.0 / 12.1 早期编译器时常见的符号容量问题。官方上游更推荐 CUDA 12.8 或 13.x。如果您由于系统驱动稳定考量不想动 CUDA Toolkit,直接运行资料包中的
scripts/02_cuda12_kbatchroom_patch.py --apply即可安全注入版本兼容守卫。
Q3:PCIe 3.0 主板或者通道被拆分成 x8 会影响日常打字速度吗?
答:对 Decode(打字吐字)几乎无感知,但对 Prefill(首字读入)影响巨大。因为 Decode 阶段绝大部分专家已被热缓存命中或错峰重叠,速度依然能稳定在 80+ tokens/s;但在初次读入 32K~120K 复杂文档时,PCIe 带宽不足会导致首字等待时间延长 25% 以上。
七、实测资料包获取与极客社群
本次实测涉及的所有自动化构建脚本、补丁工具、参数模板与原始 CSV 压测报告,已完整打包为标准交付物:
╔═════════════════════════════════════════════════════════════════════════╗
║          📦 玩客笔记 EP17 · RTX 3080 Speedy 125B 专项资料包 V1           ║
╠═════════════════════════════════════════════════════════════════════════╣
║ 📂 资料包清单包含:                                                      ║
║   • scripts/00~08:全流程 9 个只读预检、源码编译、补丁注入与导出脚本     ║
║   • example_config/:经过 10GB 显存微调验证的生产级单卡 JSON 配置模板   ║
║   • benchmarks/:PCIe x8 vs x16 逐级吞吐对照表与 facts.json 事实底账    ║
║   • docs/:Ubuntu 24.04 深度排障笔记与实机避坑要点                      ║
║                                                                         ║
║ 🔗 资料包领取入口见下方链接,也可在 B站私信发送「3080」领取。             ║
║    当前 V1 不含模型权重和原始测速日志,请先阅读资料范围说明。             ║
╚═════════════════════════════════════════════════════════════════════════╝
RTX 3080 资料包 V1 已上线
包含部署手册、9 个辅助脚本、配置快照与测试汇总。当前 V1 不含模型权重或原始测速日志;也可在 B站私信发送【3080】领取。
About The Author