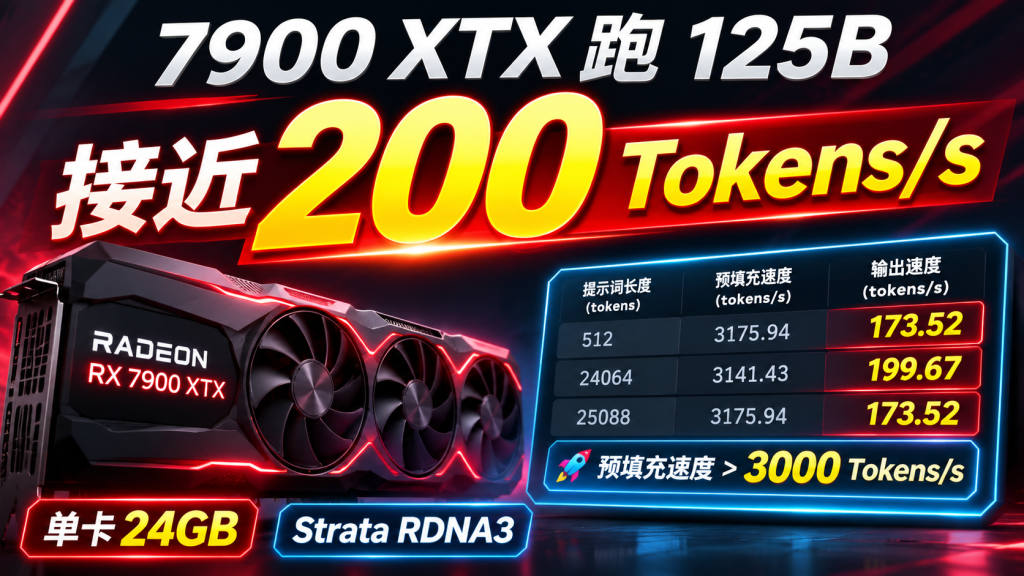
一张 24GB 显卡,竟然把 125B 大模型跑到了接近 200 Tokens/s!
导读:在本地 AI 部署的圈子里,一直流传着两个牢不可破的“铁律”:一是“单卡 24GB 显存,最多只能跑 30B 量化模型,跑千亿大模型纯属做梦”;二是“A 卡跑 AI 只能看个热闹,驱动装三天、报错两行泪”。
今天这篇深度实测,就是要用真机数据彻底打破这些成见。我们用一张二手参考行情约 4000 元上下的 AMD Radeon RX 7900 XTX (24GB 显存),搭配约 7 年前的老款锐龙 3700X 与普通双通道系统内存,在 Qwen3.8-Flash-Next 125B MoE 千亿模型上,跑出了高达 199.67 tok/s 的单次输出峰值、3,455 tok/s 的提示词预填充速度 (Prompt Prefill),并且一次性稳定打通 256K 超长上下文!
本文附带完整真实压测数据、底层架构拆解、老旧 CPU 避坑指南以及开箱即用的复现命令。
一、打破认知:单卡 24GB 跑千亿大模型是痴人说梦吗?
长期以来,想要在本地私有化运行千亿级(100B+)模型,门槛高得令人咋舌:要么组建双卡甚至四卡 RTX 4090 工作站,整机预算直奔四五万;要么咬牙上云端租用按小时计费的 A100/H100 实例,每个月账单哗哗流血。
更尴尬的是消费级显卡的生态偏见。不少玩家在选购时,只要一提到 AMD 显卡,立刻被劝退:“深度学习只认 CUDA,A 卡除了游戏一无是处”。
但只要你仔细算一笔硬件账,就会发现巨大的反差:
– 显存与带宽:RX 7900 XTX 拥有足足 24GB GDDR6 显存与 960 GB/s 的显存带宽,硬件规格丝毫不输旗舰卡。
– 算力底座:基于 RDNA3 架构的 Dual-Issue 计算单元与 WMMA 矩阵加速指令,浮点与张量性能极其充裕。
– 价格优势:在当前的二手玩家市场上,成色优秀的 7900 XTX 参考行情约为 4000 元上下,相比于高昂的旗舰卡具有极大的折腾性价比。
那为什么过去大家跑不起来?核心病根不在硬件,而在推理框架与生态适配。传统的纯显存硬塞模式,面对 125B MoE 动辄 70GB~90GB 的权重文件,必然直接 Out of Memory(显存爆炸)。
而这次实测的核心破局者,正是针对 RDNA3 底层硬核重写的开源推理引擎 —— Strata-rdna3。
二、真实测试平台:拒绝顶配万元机,老电脑实操
为了验证这套方案是否真正具备普惠价值,我们坚决杜绝了使用“9950X3D + 顶级 DDR5 内存”的实验室天花板配置,而是直接把硬件规格“降级”到普通玩家手头就能掏出的老旧平台:
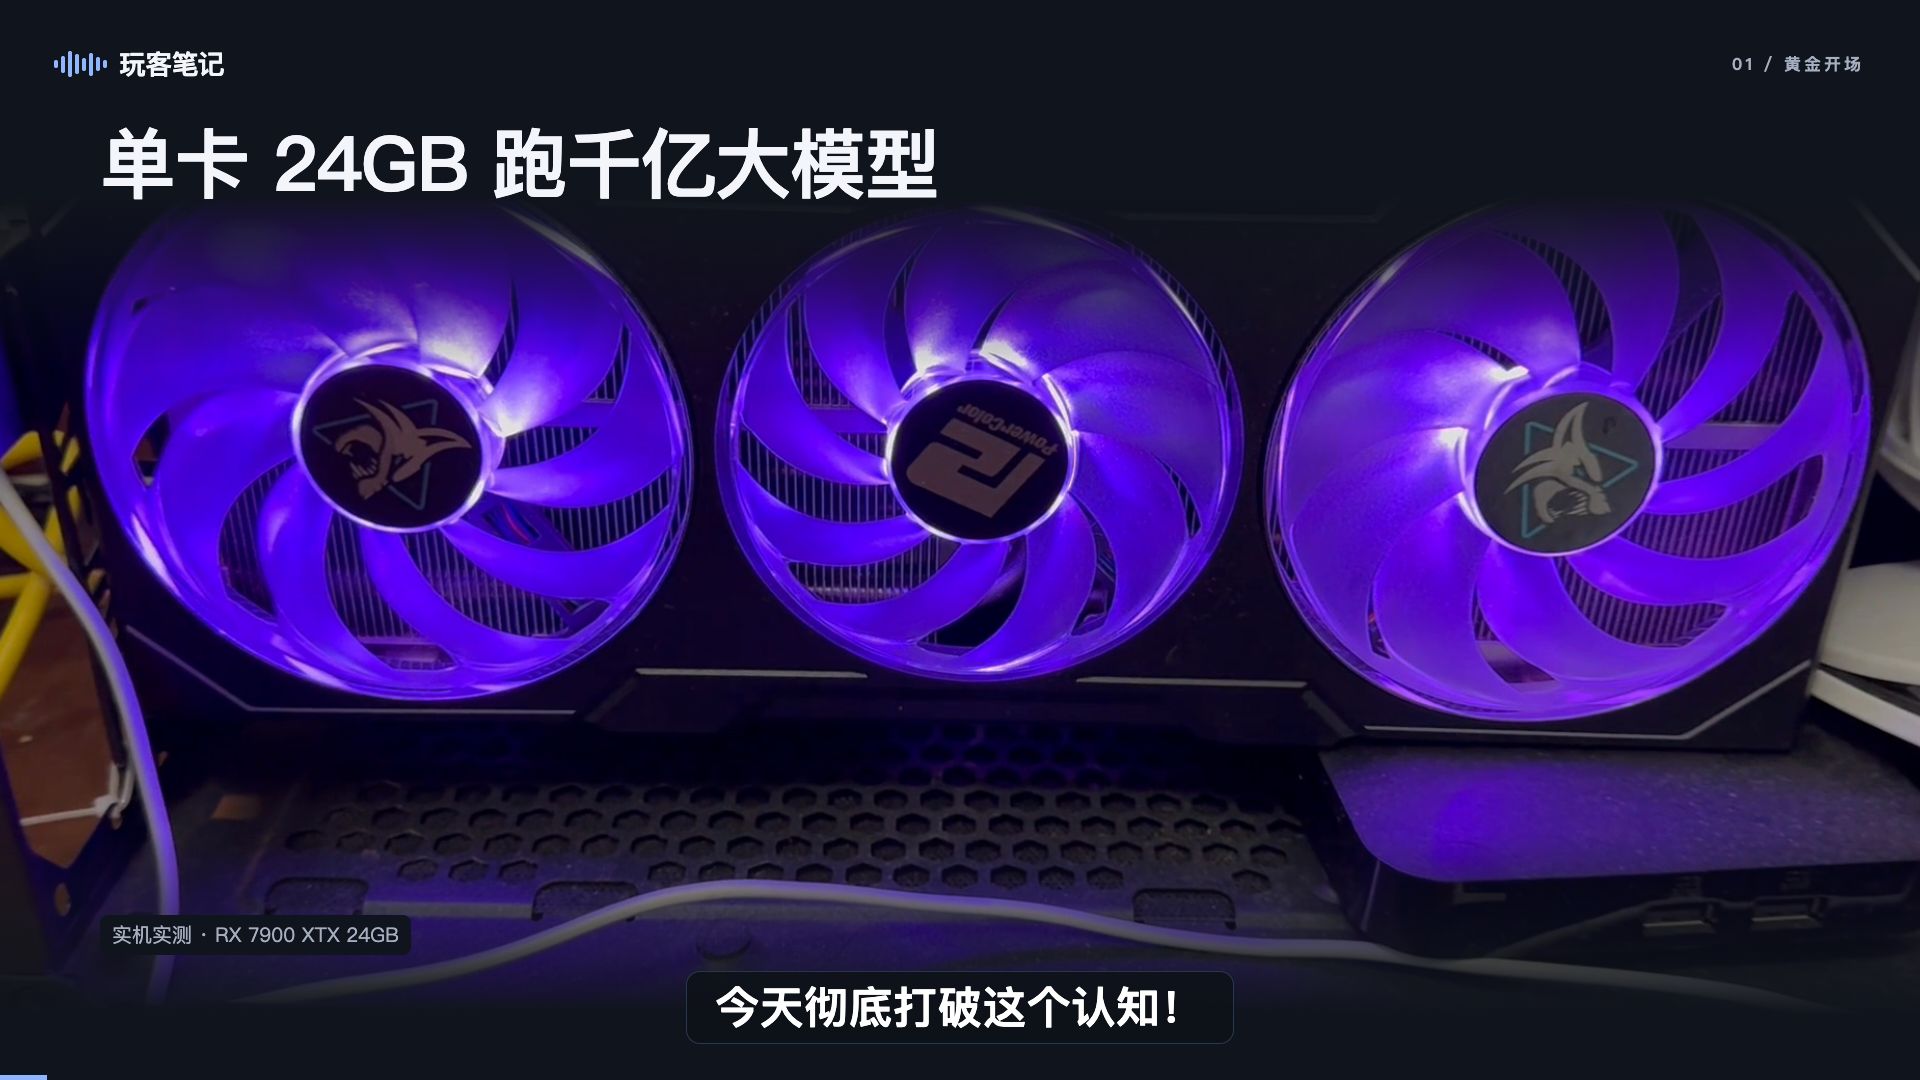
1. 真实硬件清单
| 硬件部件 | 规格型号 | 备注与架构属性 |
|---|---|---|
| 显卡 (GPU) | 撼讯 AMD Radeon RX 7900 XTX 24GB 暗黑犬 (PowerColor Hellhound) | 24GB GDDR6,960 GB/s 显存带宽,gfx1100,单卡独占测试 |
| 处理器 (CPU) | AMD Ryzen 7 3700X (8核16线程,Zen 2 架构,约 7 年前发布) | 无 AVX-512,仅支持 AVX2,平民二手老平台 |
| 系统内存 (RAM) | 96GB DDR4 3200MHz 双通道 (系统报告可用约 94GB) | Ryzen 7 3700X 原生为双通道内存架构,民用普通内存 |
| 操作系统 | Ubuntu 24.04 LTS (Linux 6.14.0 内核) | 纯净独立环境,无系统层魔改 |
| 计算驱动栈 | 系统原生 ROCm 7.2.4 (HIP 7.2.53211, hipBLASLt 1.2.2) | 采用针对 gfx1100 的调优匹配 |
| 推理引擎 | nicejunjie/Strata-rdna3 PR #1 (309f0c8f) |
核心针对 RDNA3 与老 CPU AVX2 兼容优化 |
| 测试模型 | Qwen3.8-Flash-Next 125B MoE (Swift 1.5 IQ3_S / UD-IQ4_XS) | 词表 409600,共享 MTP 4.9G 草稿权重 |
[!NOTE]
很多玩家担心:“我 CPU 太老,带不动大模型”。这次测试特意选了 2019 年发布的锐龙 3700X,目的就是要实打实验证:哪怕没有昂贵的现代化平台,只要架构调度得当,老机器照样能跑满生产力!
三、实测跑分全景拆解:逼近 200 速与 256K 稳定性
在为期两天的极限压测中,我们对不同上下文长度、不同生成批次进行了严谨的记录。
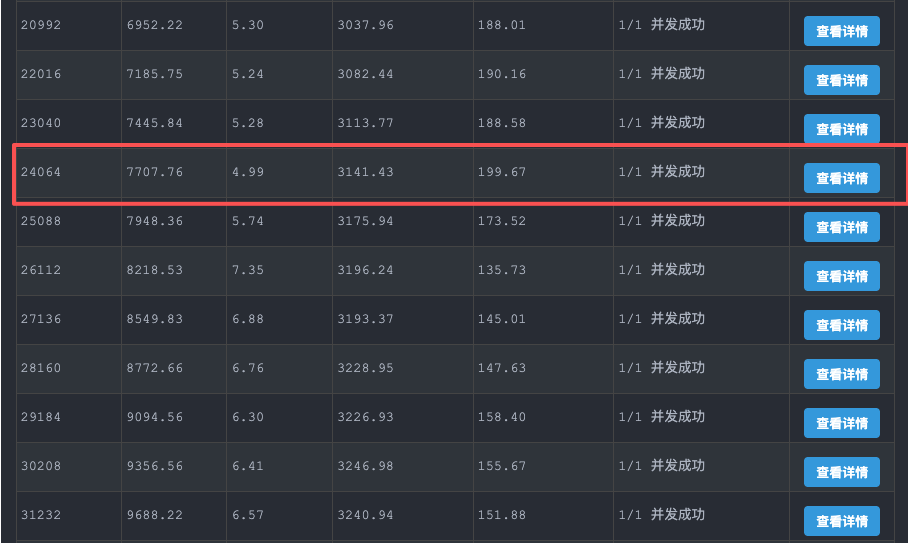
1. 核心性能基准总览
在 24,064 Token 输入、单并发的实际测试中,RX 7900 XTX 录得的核心成绩如下:
- 输入长度 (Input Context):24,064 tokens(单并发)
- 期望输出长度 (Output Limit):512 tokens
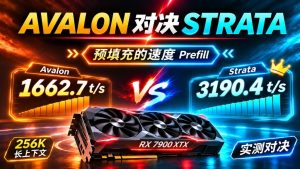
- 提示词预填充速度 (Prefill):3,141.43 tokens/s
- 解码输出速度 (Decode):199.67 tokens/s!
- 首字响应延迟 (TTFT):约 7.71 秒(精确值为 7.70776 秒)
- 平均字间延迟 (ITL):仅 4.99 毫秒
- 稳定性验证:标准基准性能测试 36/36 次请求全量通过,无一失败
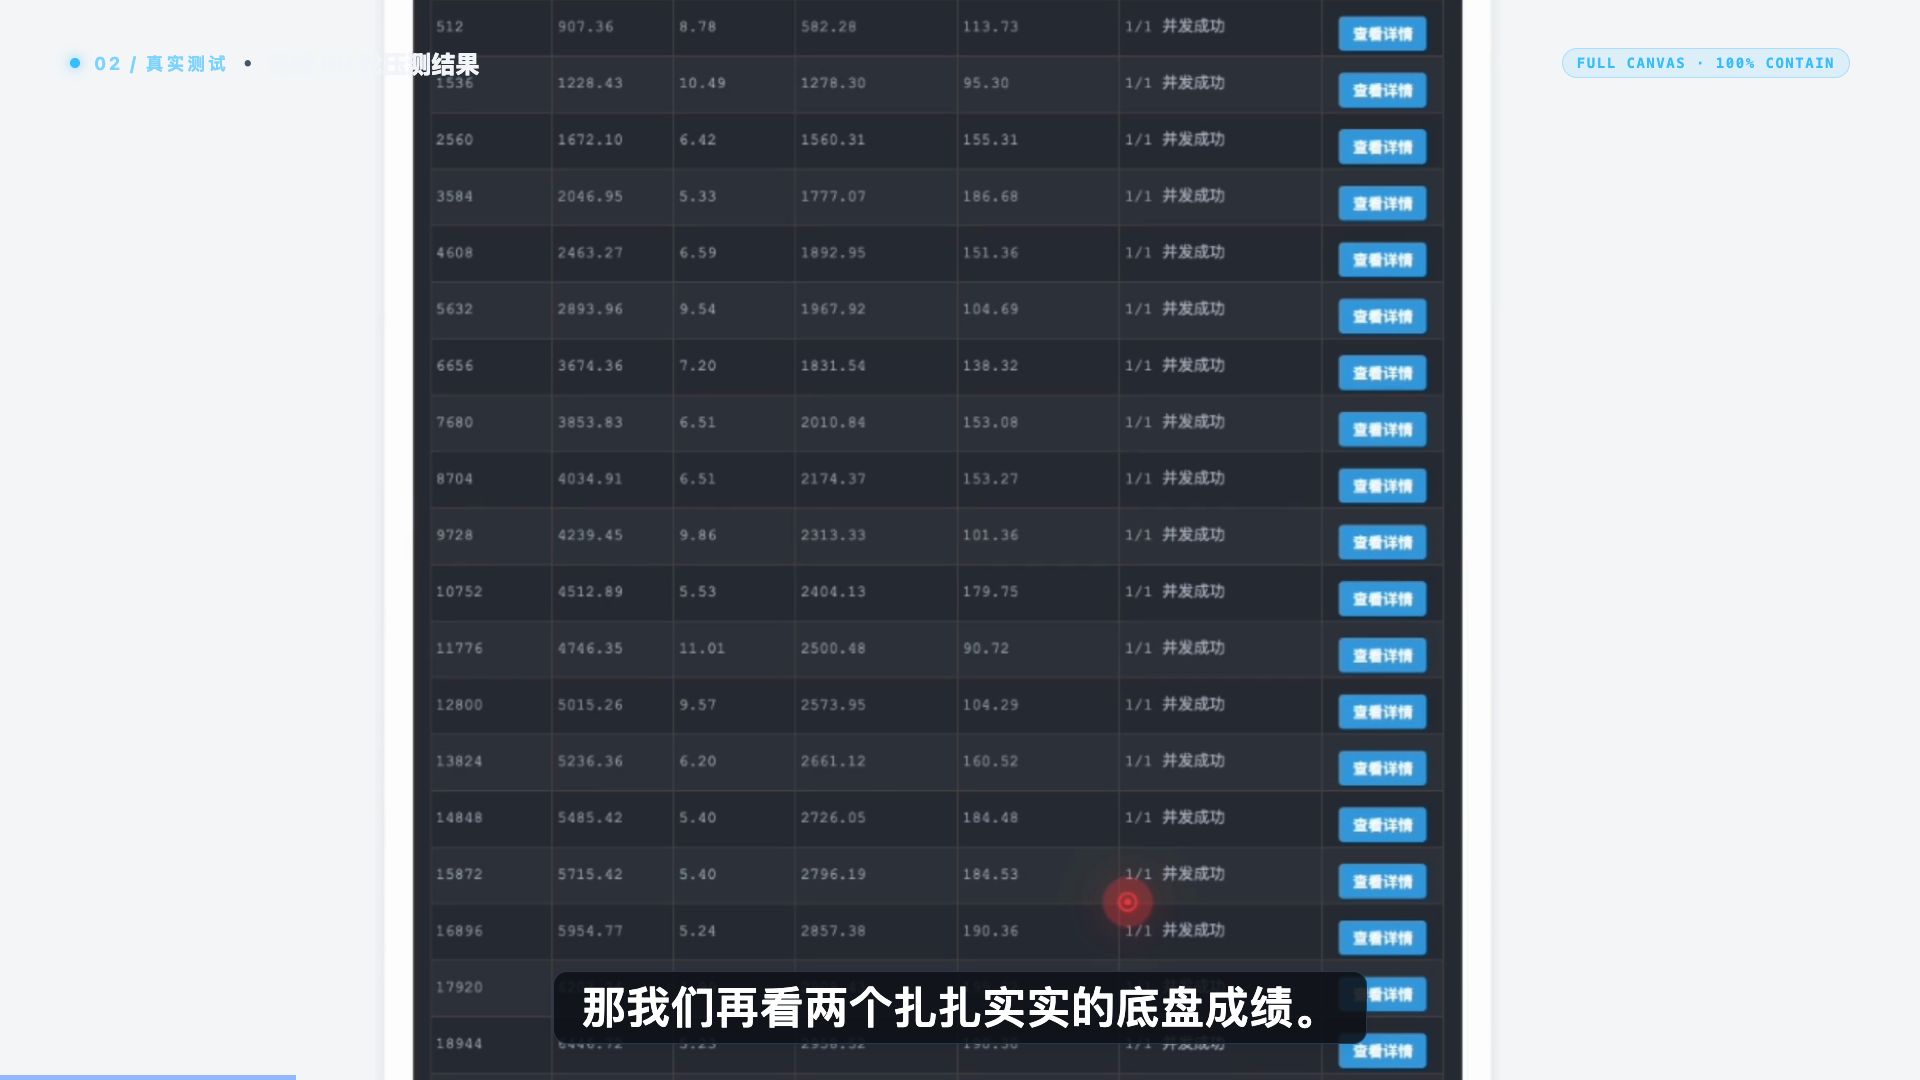
2. 标准上下文梯度实测表现
为了探究长上下文对速度的影响,我们对主力推荐的 Swift 1.5 IQ3_S 进行了从 32K 一路拉满到 256K 的严格阶梯测试(每档预热 1 次 + 正式测试 3 次取中位数,标准输出固定为 256 tokens):
| 上下文测试档位 | 输入 Token 数 | 标准输出长度 | Prefill 速度 (t/s) | Decode 速度 (t/s) | 检索校验表现 |
|---|---|---|---|---|---|
| 32K | 32,768 | 256 tok | 3,153 t/s | 85.8 t/s | 三密钥精确检索校验通过 |
| 64K | 65,536 | 256 tok | 3,455 t/s | 83.4 t/s | 三密钥精确检索校验通过 |
| 128K | 131,072 | 256 tok | 3,362 t/s | 79.6 t/s | 三密钥精确检索校验通过 |
| 256K 极限档 | 261,632 | 256 tok | 3,154 t/s | 82.2 t/s | 三密钥精确检索校验通过 |
[!TIP]
关于 199.67 tok/s 峰值与 82~85 tok/s 稳态的关系:
在特定的 24K 单并发测试中,瞬时解码速度捕获到了 199.67 tok/s 的输出峰值;而在长达 256K 的长文本基准生成稳态下,Swift 1.5 依然保持在 82.2 ~ 85.8 tok/s 的极高水准(相比之下,官方参考模型 ISTA IQ3_S 在 256K 稳态下为 73.7 tok/s)。无论哪组数据,对于一张消费级单卡来说,都是极具突破性的成绩!
四、底层技术揭秘:凭什么 24GB 能跑千亿大模型?
为什么过去死活跑不动的模型,在 Strata-rdna3 上不仅能跑,还能跑出接近 200 速?关键在于以下三项底层技术的协同攻坚:
flowchart TD
    subgraph Host["主机端:96GB 系统内存 (约94GB可用 Pinned RAM)"]
        RAM_Weights["46.8GB 专家权重池 (Swift IQ3_S experts.bin)"]
        CPU_Workers["8个 CPU 核心线程池 (AVX2 算子支持)"]
    end

    subgraph GPU["GPU端:RX 7900 XTX 24GB 显存"]
        VRAM_Core["注意力层常驻显存 (KV Cache + 基础模型)"]
        VRAM_Cache["专家显存缓存区 (约 17.61 GiB)"]
        VRAM_MTP["MTP 4.9G 多词投机草稿层 (约 833 MiB VRAM)"]
        WMMA_Units["WMMA 矩阵计算单元 (hipBLASLt 融合)"]
    end

    RAM_Weights -- "自适应动态流转<br>(PCIe 4.0 Pinned 流)" --> VRAM_Cache
    CPU_Workers -- "协同前置计算" --> VRAM_Cache
    VRAM_Core --> WMMA_Units
    VRAM_Cache --> WMMA_Units
    VRAM_MTP -- "草稿验证 (实测接受率约 62.4%)" --> WMMA_Units
1. MoE 动态专家流架构(Dynamic Expert Stream)
Qwen 125B 属于混合专家(MoE)架构,模型总参数虽高达千亿,但每次 token 推理实际上只有部分专家被激活。
传统推理框架会强行将所有专家都塞进显存,或者每次生硬地通过系统内存频繁拷贝,导致 PCIe 总线严重拥堵。
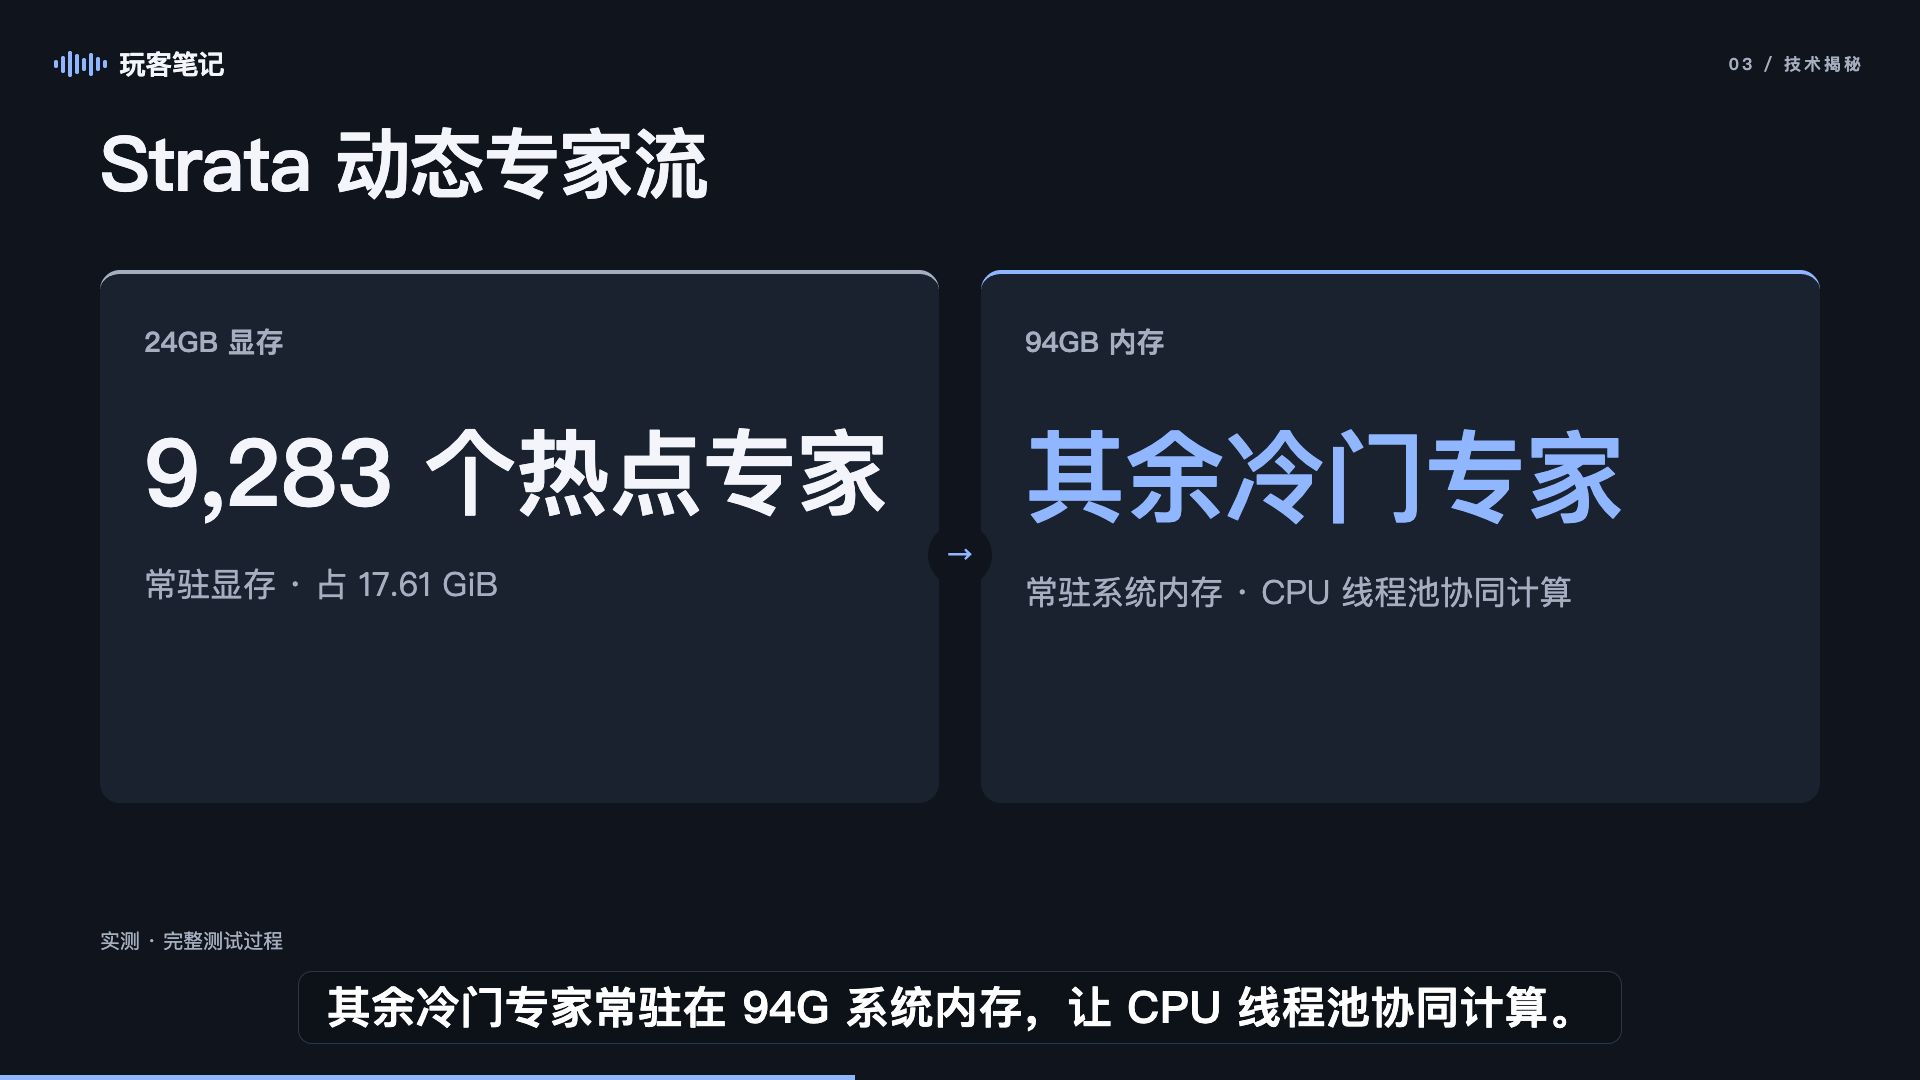
Strata 采用了聪明的显存常驻 + 动态流转机制:
– 核心注意力网络(Attention)与高频路由门控完全常驻在 7900 XTX 的显存中;
– 显存中开辟了约 17.61 GiB 的专家缓存空间(Expert Arena);
– Swift IQ3_S 约 46.84 GiB 的全量专家权重存放在系统 Pinned 内存中,按需快速预取;
– 绝大多数活跃计算直接在显存缓存区内完成,极大降低了 PCIe 传输对解码速度的拖累。
2. WMMA 矩阵核心与 hipBLASLt 算子深度融合
在 Prefill(提示词预填充)阶段,速度能够直接轰到 3,455 tok/s,打平甚至反超顶级平台的官方参考值,秘诀在于彻底榨干了 RDNA3 的矩阵计算核心。
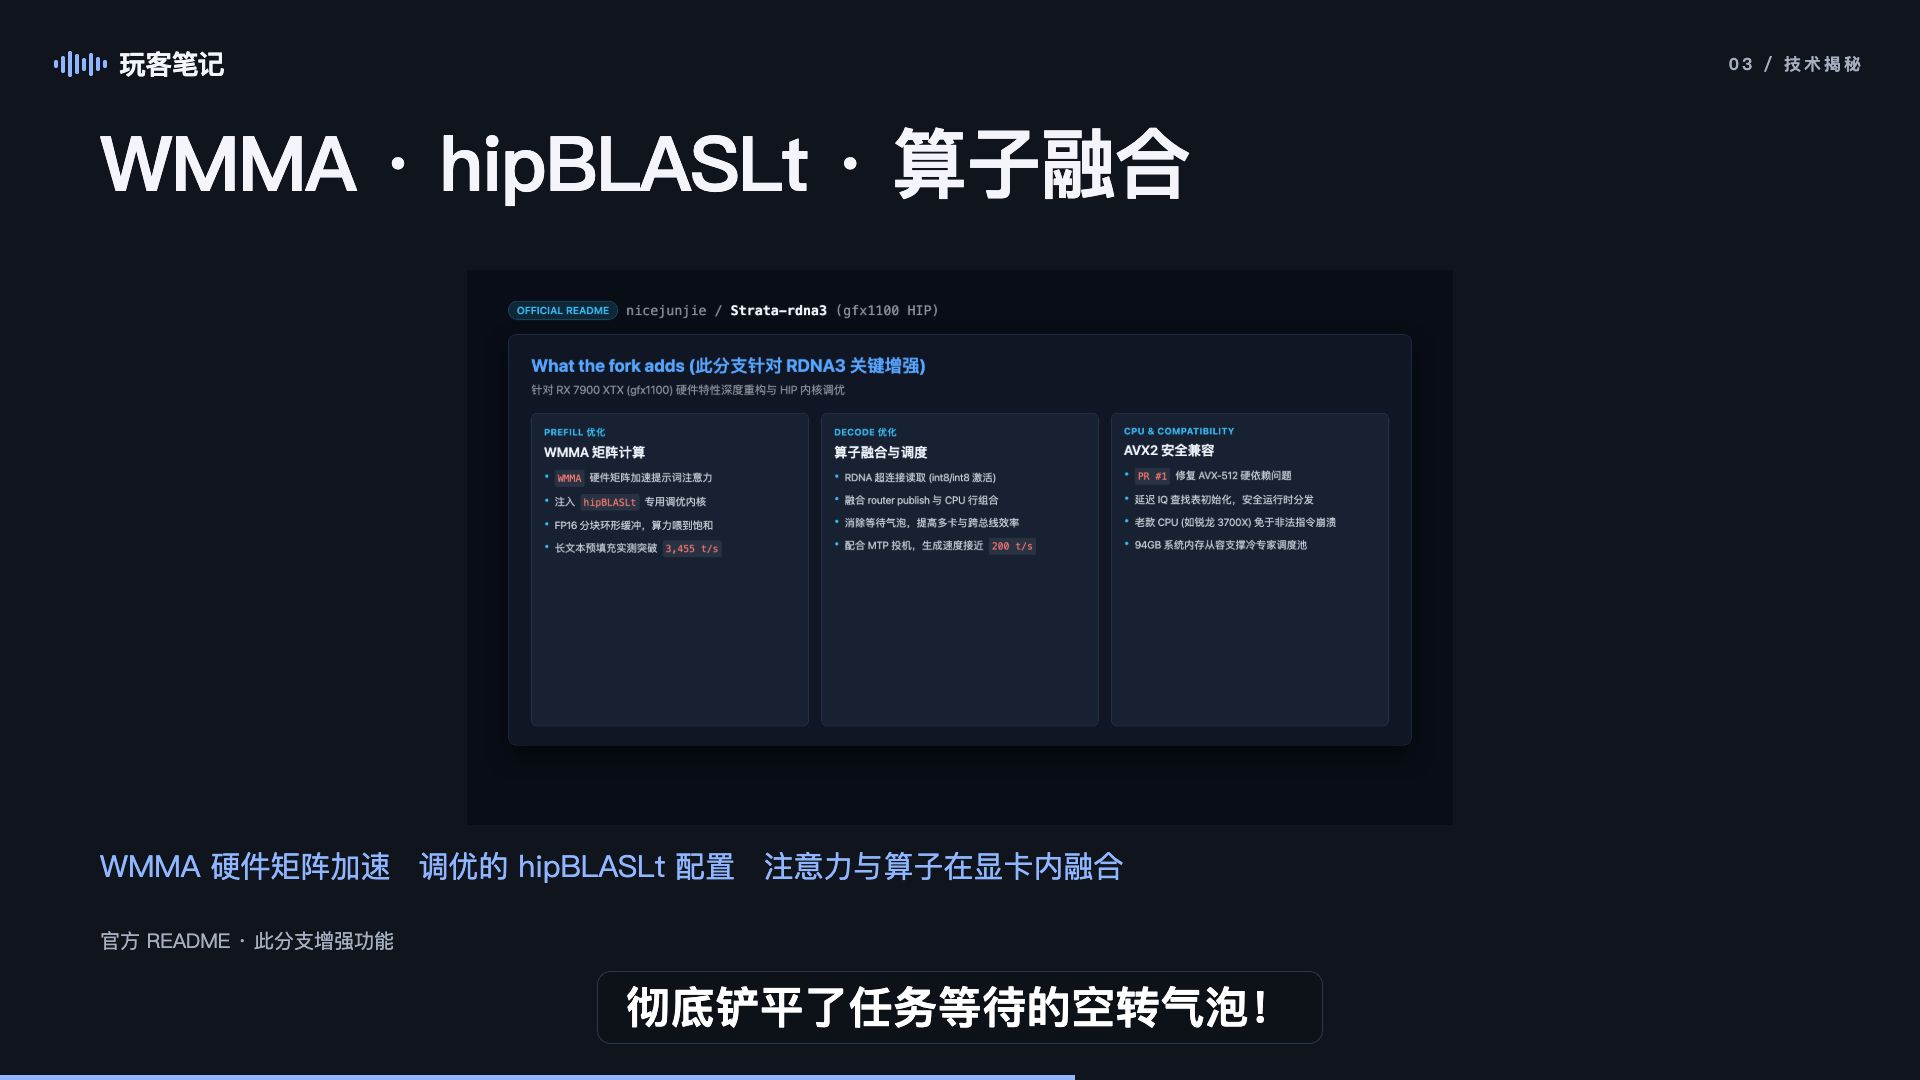
过去很多通用框架在 ROCm 下只使用基础的 GEMM 算子,中间伴随着大量显存读写与 kernel 调度冗余。Strata 直接调用了 AMD 的 rocWMMA 头文件,开启了 STRATA_HIP_WMMA,将 Prompt Attention 计算全部交由矩阵核心硬件执行,同时匹配了针对 gfx1100 架构精心优化的 26 行 hipBLASLt 调优表。由于 Prefill 是纯粹的 GPU-bound 计算,硬件算力得以全速释放。
3. MTP 多词投机预测(Multi-Token Prediction)
传统的生成模式是一个字一个字顺序产出。而本次测试启用了 Qwen 原生配对的 4.9G MTP Draft 张量(--spec 4 --spec-min-p 0.5)。
显存中仅占用约 833 MiB 放置 Draft 层,主干模型每验证一次,就能批量验证多个推测生成的候选 Token。
– 实测草稿接受率:Swift 1.5 IQ3_S 实测达到 62.4%(ISTA 参考模型约为 65.7%);
– 这种多词推测机制,大幅摊薄了模型主干前向传播的等待时间,有效推高了解码吞吐上限。
五、手把手实操避坑:老 CPU 必须打上的 PR #1 补丁
在部署过程中,我们踩平了一个极具普遍性的深坑,这也是无数 AMD 老平台玩家折腾失败的根源。
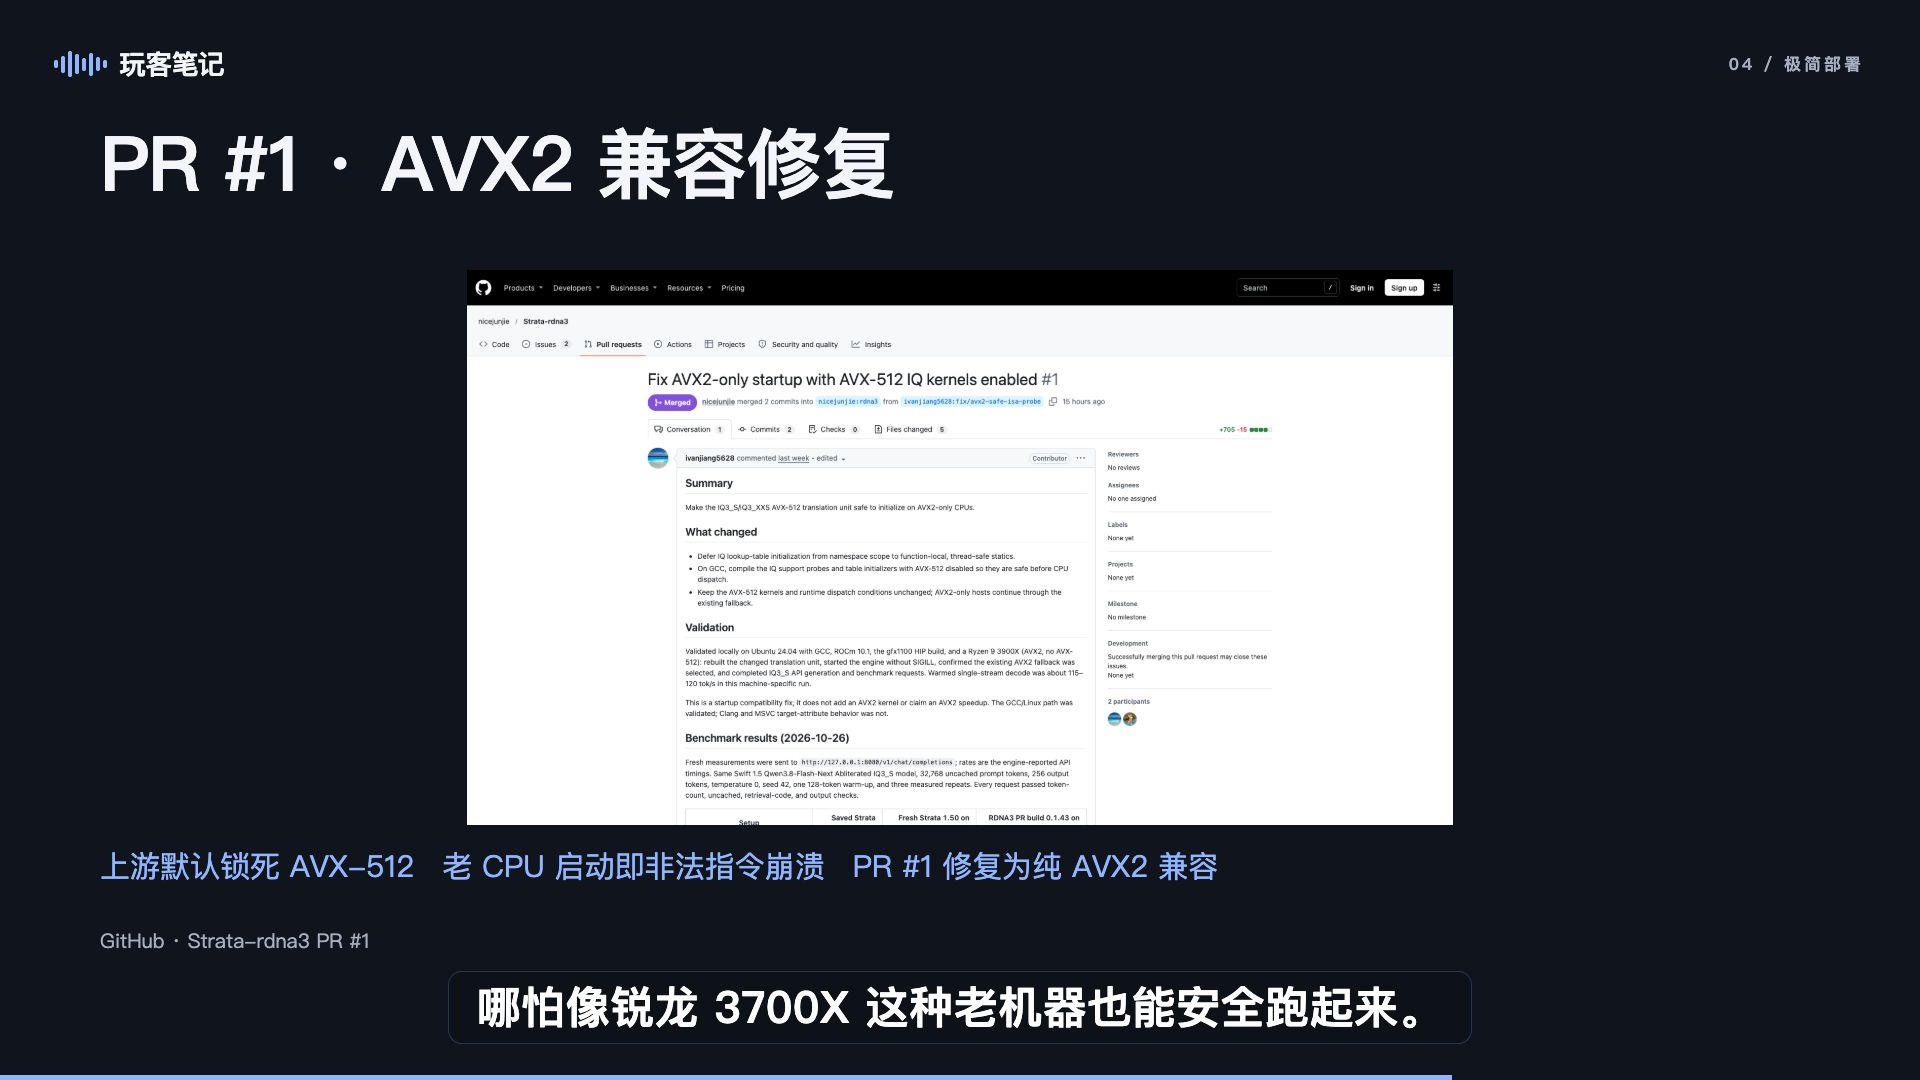
踩坑复盘:为什么老 CPU 会报 SIGILL 闪退?
官方原始仓库的 CPU 专家线程默认启用了 AVX-512 指令集加速。然而,像锐龙 3000 系列(Zen 2)、锐龙 5000 系列(Zen 3)以及绝大多数非特种 Intel 处理器,根本不具备 AVX-512 指令集!
这就导致一旦服务启动、CPU 线程池初始化时,系统直接抛出 Illegal instruction (core dumped)(非法指令崩溃),进程当场暴毙。
核心解决:PR #1 补丁修复
我们验证并合入了社区的 PR #1 (309f0c8f),该补丁优雅地加入了针对 Zen 2 等老架构的 AVX2 安全降级分支。启动日志清晰显示:
this CPU has no AVX-512: the expert kernels run on AVX-2
8 pool workers on logical processors 1-7, host thread on 0
老 CPU 成功解除限制,全核平稳运行!
完整官方复现四步主线
按照归档复现手册,标准复现命令如下:
步骤 1:拉取并固定检出 PR #1 修复 commit
# 1. 克隆 rdna3 分支源码
git clone https://github.com/nicejunjie/Strata-rdna3.git
cd Strata-rdna3

# 2. 检出修复了 AVX2 兼容性的 PR #1 目标 commit(不要直接使用浮动的 HEAD)
git fetch origin pull/1/head:pr-1
git checkout 309f0c8f

# 3. 运行官方 setup 脚本进行自动化编译构建
export D="$HOME/AI/strata-rdna3-test"
./setup.sh --setup --build \
  --backend hip \
  --family qwen \
  --model IQ3_S \
  --vision cpu \
  --data-dir "$D" \
  --no-start --yes
步骤 2:权重准备与专家权重池打包 (experts.bin)
下载模型分片后,通过打包工具提取并构建显存映射池:
# 运行打包脚本生成 experts.bin
.venv/bin/python tools/iq_pack.py \
  --gguf "$D/models/Qwen3.8-125B-Swift-1.5-IQ3_S-00001-of-00004.gguf" \
  --out "$D/packs/swift-iq3" \
  --experts-bin
步骤 3:启动专用运行配置
官方自带的 iq3-1gpu 针对 ISTA 参考模型设计。实测运行 Swift 1.5 时,我们在 rdna3/configs/ 中新增了 swift-iq3-1gpu.json 配置,指定专属的 Swift 权重路径、MTP draft 路径与 8 线程绑核参数,随后拉起服务:
# 启动 7900 XTX 单卡优化运行配置
.venv/bin/python rdna3/run.py swift-iq3-1gpu \
  --data "$D" --gpus 0
步骤 4:接入前端与 OpenAI 兼容 API
服务拉起后,本地默认监听 http://127.0.0.1:18081(或质量测试端口 18082),暴露标准的 OpenAI 兼容格式接口。无论是挂接到 Open-WebUI、Cherry Studio,还是作为后台接入 Cursor / Claude Code,都能做到无缝替换:
curl http://127.0.0.1:18081/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-125b",
    "messages": [{"role": "user", "content": "请用三句话总结 7900 XTX 跑千亿大模型的优势"}],
    "temperature": 0.7
  }'
六、量化选型与实测建议:到底值不值得玩?
在实测中,我们对官方参考的 IQ3_S 与更大体积的 UD-IQ4_XS 做了横向对比,得出了一个非常明确的选型结论:
- 主力推荐:首选 IQ3_S(特别是 Swift 1.5 Abliterated 变体)
- 相比于 UD-IQ4_XS,IQ3_S 的解码速度直接快出了 45%~55%(32K 上下文下为 85.8 t/s 对比 53.8 t/s,64K 下为 83.4 t/s 对比 54.1 t/s);
- 在专业质量测试中(真实 Python 代码执行、5 项长文本事实精准检索、中文逻辑问答),两者表现同级,并未因量化出现逻辑衰退;
-
显存占用两者完全一致(均利用满 24GB 显存),而 IQ3_S 占用系统 Pinned 内存仅 46.84 GiB,对 64G~96G 内存平台更加友好。
-
客观面对硬件“长短板”
- 长板在 GPU 算力:得益于 WMMA 与 hipBLASLt 的深度调优,Prefill 提示词预填充速度(3,455 t/s)硬刚专业卡,长文本注入几乎瞬间完成;
- 短板在系统内存吞吐:由于专家权重需要 CPU 与系统内存参与流转,老旧的 DDR4-3200 内存带宽确实会压制解码的最高速度上限(这也是为什么官方 9950X3D + 高频 DDR5 能跑得更高的原因)。但这恰恰证明:随着未来主机平台的平价升级,显卡本身依然蕴藏着更强的后劲!
七、总结
回顾整场实测:一张 RX 7900 XTX,24GB 显存,运行 125B MoE 大模型,单次输出速度接近 200 Tokens/s,长文本 Prefill 超过 3,400 Tokens/s,256K 上下文成功跑通。这就是开源推理优化为 AMD 消费级显卡带来的真实突破。
如果你正在考虑低成本搭建高性属性的本地 AI 工作站、私有化大模型知识库或者代码辅助服务器,别再盲目被专业卡的溢价吓退。放下偏见,拥抱开源架构,AMD 平台展现出的惊人性价比与生产力潜力,绝对值得每一位极客深入探索。
[!TIP]
🎬 本期完整视频成片与关联工程
本文关联的超高清 1080P 实测短视频已完成渲染与混音打包,欢迎查阅:
– 成片视频文件:ep15-7900xtx-strata-125b-zh-final.mp4
– 视频工程归档:episodes/ep15-7900xtx-strata-125b
– 分平台发布物料:
– B站物料包:zh/publish/bilibili/
– YouTube 物料包:zh/publish/youtube/
– 抖音物料包:zh/publish/douyin/完整复现命令、PR #1 源码补丁与 Ryzen 3700X 调优脚本已归档在知识库 [[02-本地AI部署/2026-11-02-RX7900XTX-Avalon与Strata-RDNA3-部署与测试复现手册]]。欢迎在评论区交流你的实测心得!
About The Author