长音频变声神器:Applio / RVC 部署实战,1小时男生录音无痛转女声(Mac / Win 双平台教程)
导读:在音频制作、视频配音或有声书录制中,我们常常遇到需要将整段录制好的男声换为女声的场景。如果是长达 1 小时的连续音频,很多现代扩散模型容易出现显存溢出(OOM)或前后音色不均的问题。本文系统盘点开源变声领域最稳健的解决方案——基于 VITS 与特征检索架构的 Applio / RVC,提供 macOS(Apple Silicon)与 Windows 双平台一键部署指南,提供多款开箱即用的高品质中文女声模型直接下载链接,并分享 1 小时长音频“男变女”保姆级参数调优秘籍。
一、 为什么长音频变声首选 RVC / Applio?
在 AI 音色转换领域,很多小伙伴容易将 TTS(文本转语音) 和 VC(声音到声音转换) 混为一谈:
- TTS 模型(如 IndexTTS、CosyVoice、ChatTTS 等):
- 属于“文本驱动”。输入必须是一段文字台词,再模仿女声念出来。
- 痛点:会彻底抹平原录音里的呼吸声、即兴停顿、自然笑声与真实语速节奏,变成“重新照本宣科”。
- 零样本扩散 VC(如 Seed-VC):
- 优势是只需 5 秒目标女声即可转换,但在处理 1 小时长音频时,切片扩散容易引入微小底噪,且前后段容易发生轻微音色漂移。
- 特征检索音色转换(RVC / Applio):
- 音色高度稳定:目标模型经过数百轮充分训练,无论音频是 3 分钟还是 1 小时,第 1 分钟与第 59 分钟的声线绝对一致;
- 长音频切片不爆显存:内置自动化静音切片与无缝拼接机制;
- 变调自然:搭载专业级 RMVPE 音高提取算法,将男声基频拉高一个八度(+12 半音)后,极少产生机械电音感;
- 生态庞大:各大模型站与社区有海量现成的国配声优、主播高质量女声权重可直接调用。
二、 系统与硬件配置门槛
很多极客玩家关心:我的电脑配置能不能跑?
实际上,RVC 在推理模式(直接使用已有模型变声)下对硬件相当友好:
| 硬件维度 | macOS (Apple Silicon) | Windows (NVIDIA 平台) |
|---|---|---|
| 最低显卡 / 芯片 | Apple M1 / M2 / M3 基础款(8G/16G 统一内存) | NVIDIA GTX 1060 (6G) / GTX 1650 (4G) |
| 推荐显卡 / 芯片 | M2 Pro / M3 Pro / M4 (16G+ 统一内存) | NVIDIA RTX 3060 / 4060 及以上 (8G~12G 显存) |
| 系统物理内存 | 建议 16 GB(1小时长音频解压进内存需占用数 GB) | 建议 16 GB ~ 32 GB |
| 1小时音频耗时 | 约 15 ~ 25 分钟 (MPS 硬件加速) | 约 5 ~ 12 分钟 (CUDA 加速) |
注:如果没有独立显卡,RVC 亦支持纯 CPU 推理,转换 1 小时音频大约需要 1 ~ 2 小时,但完全能够平稳跑完。
三、 Applio 极简安装部署(Mac / Win 双方案)
Applio 是目前开源社区对原版 RVC 进行现代重构的顶级分支,界面友好、运行稳定,推荐以下两种部署途径:
方案 1:Pinokio 一键安装(零代码,强烈推荐)
Pinokio 是一个开源的自动化 AI 应用容器,支持 macOS 与 Windows:
1. 访问 Pinokio 官网 下载并安装客户端;
2. 打开 Pinokio,在 Discover 页面搜索 Applio;
3. 点击 Install,软件会自动配置独立沙箱、Python 环境与 MPS/CUDA 依赖;
4. 安装完成后点击 Launch,即可在浏览器中一键打开 Web 控制台。
方案 2:官方原生终端部署
如果你习惯使用终端命令行:
macOS 平台:
# 1. 拉取代码
git clone https://github.com/IAHispano/Applio.git
cd Applio

# 2. 执行官方安装脚本(自动初始化虚拟环境)
chmod +x run-install.sh
./run-install.sh

# 3. 启动应用
chmod +x run-applio.sh
./run-applio.sh
Windows 平台:
git clone https://github.com/IAHispano/Applio.git
cd Applio
run-install.bat
run-applio.bat
四、 高品质女声模型精选推荐与直接下载
RVC 转换的效果上限,几乎 90% 取决于你下载的女声模型品质。为了免去大家到处寻找筛选的麻烦,这里精选整理了几款经过数万人验证、适合日常说话、有声书与长篇播客的高质量中文女声模型,提供直接下载链接:
1. 经典高品质女声模型直接下载表
| 模型名称 | 声线风格与适用场景 | 训练规格 | 直接下载链接 |
|---|---|---|---|
| 黑天鹅 (崩铁国配 – 杨梦露) | 成熟知性 / 优雅播音 声线温和富有磁性,非常适合长篇有声书、纪录片旁白、知识讲解 |
RVC v2 / 高纯净度干声 | ⬇️ 点击直接下载 heitiane.zip |
| 神里绫华 (原神国配 – 小N) | 端庄清甜 / 温柔少女 咬字极为清晰自然,音色柔美,适合生活 VLOG、剧情叙事与对话 |
RVC v2 / RMVPE | ⬇️ 点击直接下载 ayaka-cn.zip |
| 芙宁娜 (原神 – 48k 精品) | 元气灵动 / 情绪饱满 音色明亮多变,表达力极强,适合幽默轻快或情绪起伏较大的音频 |
RVC v2 / 275 Epochs / 48k | ⬇️ 点击直接下载 furina-v2.zip |
| 崩铁女角色模型合集 (银狼/白露等) | 多风格角色声线 包含萝莉音、冷傲少女音等多种预打包模型,解压即用 |
RVC v2 / 独立打包 | 📁 直达 Hugging Face 仓库浏览下载 |
| Voice-Models 国际高赞中文专区 | 日常说话 / 虚拟主播 / 播音员 包含大量如 嘉然、乃琳、专业配音演员的说话声模型,支持在线试听 |
社区万赞认证 | 🌐 访问 Voice-Models 中文女性专区 |
2. 挑选高质量模型的“避坑三要素”
- 文件齐全:下载解压后,包内必须包含两个核心文件:
{模型名}.pth:主网络权重。added_..._{模型名}.index:特征检索索引(核心!缺少 index 会导致普通话咬字含糊不清)。- 训练轮数(Epochs):选择标明在 200 ~ 400 轮 之间的模型(过低不像本人,过高易出现破音与电音)。
- 场景匹配:务必挑选标注为“纯干声 / 日常说话声 / 播客”训练的模型,切勿使用“高音唱腔专用模型”来处理正常说话。
3. 模型文件存放路径
下载解压后,将对应文件丢入 Applio 根目录:
* 将 .pth 文件放入:assets/weights/
* 将 .index 文件放入:logs/(或与 .pth 同目录)
* 放置后回到 Web 页面,点击 “Refresh / 刷新音色列表” 即可在下拉菜单中选中。
五、 实战:1 小时长音频“男变女”保姆级操作流
处理 1 小时的长音频,如果直接把含有背景音乐的录音丢进 AI,背景音乐会被严重畸变。请严格遵循标准三步工业级流水线:
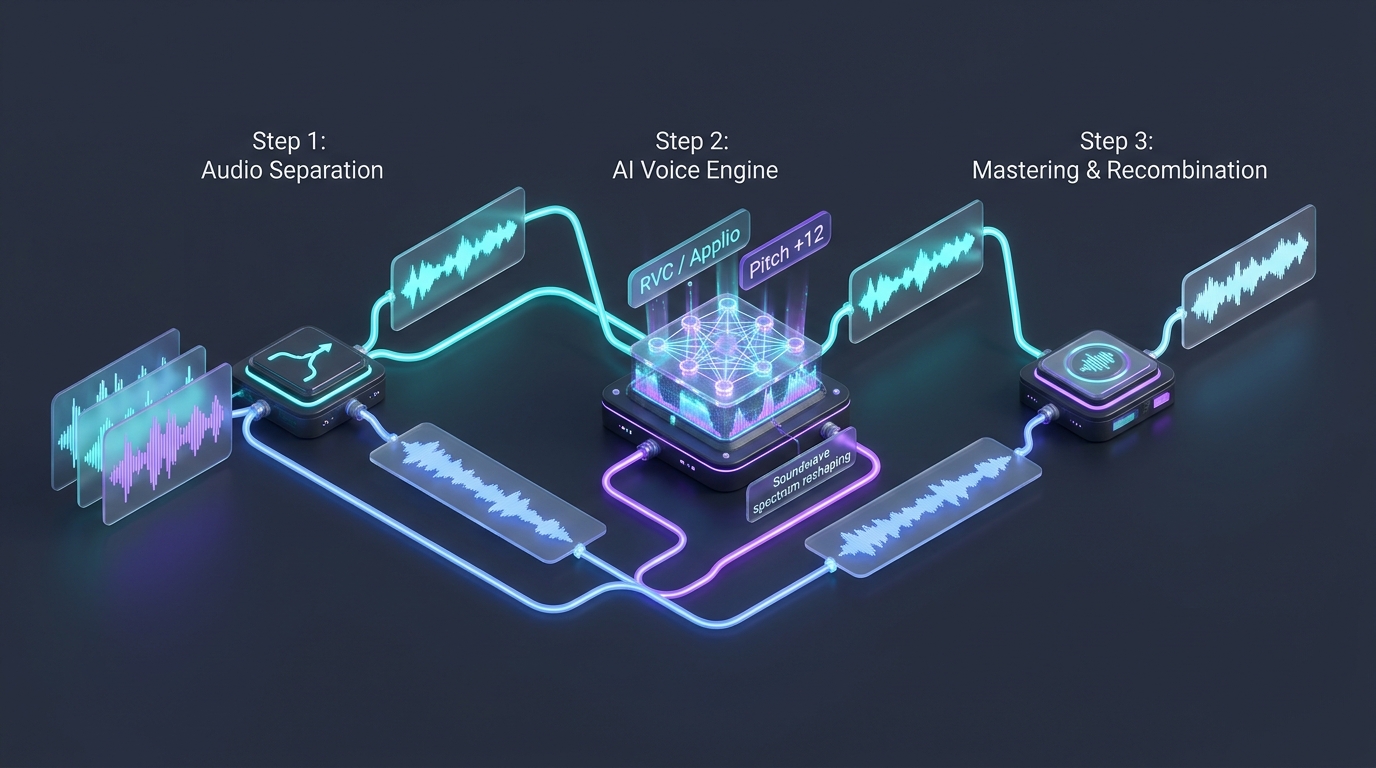
步骤 1:人声与伴奏分离(UVR5)
- 若原音频包含背景音乐或环境音,使用免费开源工具 UVR5 (Ultimate Vocal Remover);
- 架构选择
VR Architecture或MDX-Net(模型推荐选择MDX-Net: Kim Vocal 2或UVR-MDX-NET-Inst_HQ_3); - 导出得到无伴奏的
纯人声.wav与纯伴奏.wav。
步骤 2:Applio 核心参数调优(关键环节)
进入 Applio 的 Inference(推理 / 变声) 页面,参考下方参数配置面板:
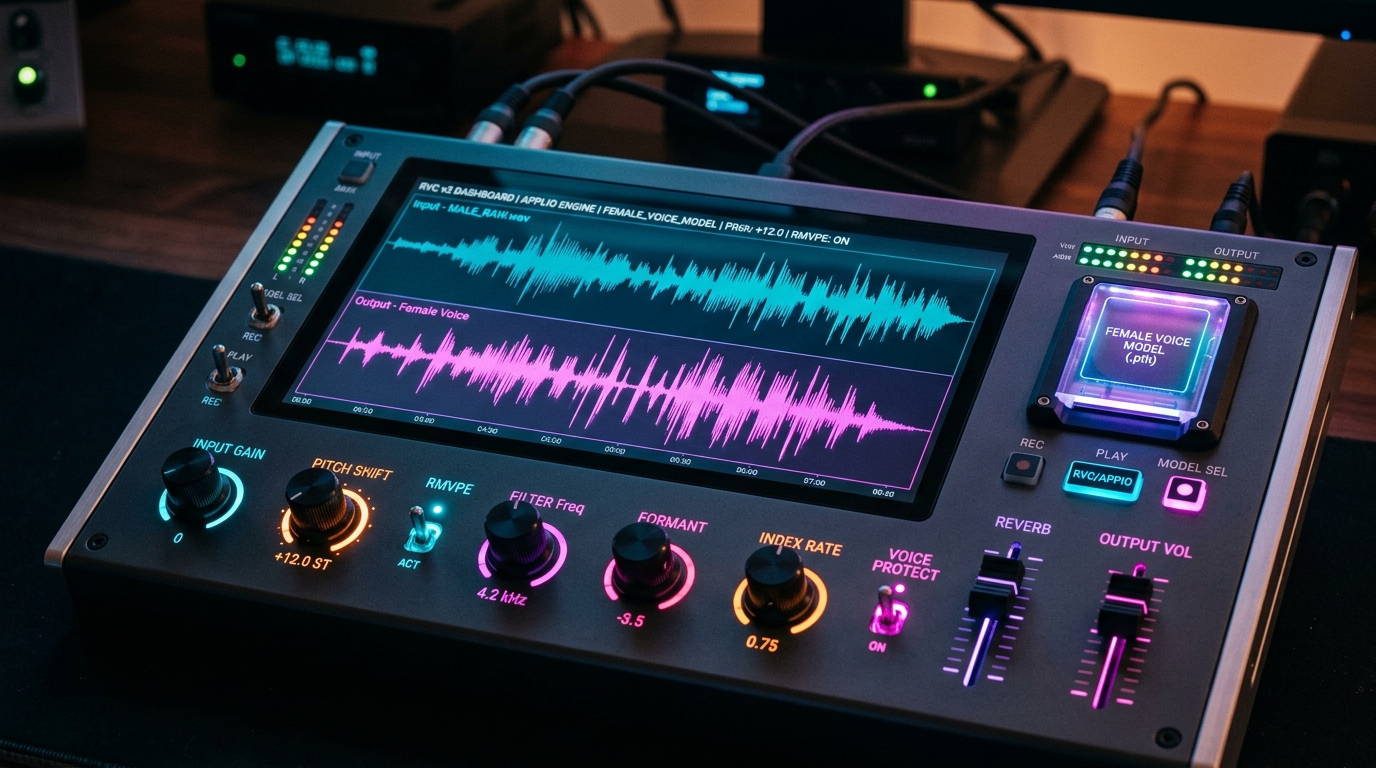
核心参数配置清单:
- Pitch / Key Shift (变调):
+12 - 原理解析:男性与女性的平均音高相差约一个八度(12 个半音)。如果保持 0 不变,转出的声音是“粗声粗气的怪异女声”;设为 +12 才能进入自然女声的基频区间。如果男生原音特别粗沉,可微调至
+13。 - Pitch Extraction Algorithm (算法):选择
rmvpe - RMVPE 是目前针对语音抗噪和音准平滑度最好的算法,远优于传统的 harvest 或 pm。
- Index Rate (检索特征占比):推荐
0.65 ~ 0.75 - 既能保证声线贴合目标女声,又能保持原说话者的清晰咬字。
- Protect Voiceless Consonants (辅音保护):推荐
0.33 - 有效保护呼吸声与气音,避免转音破损。
- 开始转换:直接拖入 1 小时音频,系统会自动分片推理并无缝缝合,耐受等待数分钟即可导出。
步骤 3:音轨混音输出
- 打开剪映、CapCut 或 Audacity;
- 新建项目,将转换好的
Female_Vocal.wav与步骤 1 提取的Instrumental.wav同时导入两条音轨; - 长度默认 100% 对齐,直接导出为最终高品质 MP3。
六、 常见问题与调优技巧(FAQ)
- Q1:转出的声音像“小黄人/花栗鼠”,尖锐刺耳?
- 原因:男生说话原声偏细,升 12 个半音后超出了目标女声的最佳频段。
- 调整:将 Pitch 从
+12下调至+10或+11。 - Q2:转出的声音像“捏着嗓子假扮女声”?
- 原因:男生原音过于低沉浑厚,升 12 半音仍未完全脱离男声共鸣区。
- 调整:将 Pitch 上调至
+13或+14,并将 Index Rate 提升到0.85以上。 - Q3:macOS 运行提示 MPS 报错或显存不足?
- 调整:在终端运行
python3 -c "import torch; print(torch.backends.mps.is_available())"确认 MPS 加速可用。尽量输入标准 WAV 格式音频,避免长 MP3 解码时的瞬时内存堆叠。
结语
通过 UVR5 剥离人声 + Applio (RMVPE, +12 变调) + 剪映音轨贴合 的组合拳,长达 1 小时的男声录音可以在 10~20 分钟内平稳、高质量地转换为自然逼真的女声音色,全程离线开源、数据隐私绝对安全。配合文中提供的直接下载模型包,大家可以立刻动手体验!
About The Author