48G 显存挑战 125B 大模型!双 7900 XTX 实测 Qwen3.8 Flash:日常 38 tok/s、48K 长文本稳定 28 速度
导读与事实基底声明(SSOT)
本文的参数、显存读数与性能数字来自 2026-09-16 的同一台测试主机:Ryzen 7 3700X、RX 7900 XTX 24GB × 2、96GB 物理内存(系统显示约 94.2GiB)、Ubuntu 24.04、Linux 6.14、TheRock ROCm 7.14,以及nasone32/llama.cpp-RDNA3-7900xtx-optcommit15995a12d1d530645a4f34c72afdaa30fa680149。
以下结果只代表这套硬件、这份模型量化、这次软件构建和这组测试负载;不是所有双 7900 XTX 的理论上限,更不是对其他模型的性能承诺。部署状态说明
FAST-50K 是本文的性能基线,STABLE-64K 是已验证的按需配置。本文更新时,测试机临时保留ctx-size=32768供客户端跑日常 API 扫描;这不改变 50K / 64K 的历史 A/B 结果,也不代表已经上线多 Profile 自动路由。64GB 内存适用范围
本文的性能数据来自 96GB 测试机,不能改写成“64GB 实测成绩”。但在--parallel 1、--load-mode none、--lazy-mode on-direct、不运行其他重内存模型服务的前提下,64GB 可作为 FAST-50K / 32K 的部署起点。64K 则应视为 96GB 推荐、64GB 必须单独验收的配置。
两张 24GB 的 7900 XTX,能不能把 90GB 级别的 Qwen3.8 Flash Next GGUF 跑成一个真正可用的本地服务?可以。但这里没有把 90GB 权重硬塞进 48GB 显存:这是一个 双卡分层 + 主机内存 + Lazy Loading 的 MoE 部署。
先说明标题中的速度:它说的是读者实际等待的 输出生成速度(TG),不是预填充(PP)。当前 32K API 扫描在 512–8,192-token 提示词范围内,TG P50 为 38.32 tok/s;固定 48,009-token 输入、固定输出 512 token 的严格压力测试中,FAST-50K 的 TG 为 27.98 tok/s。两者分别对应日常使用与长上下文重负载。
本文的 FAST-50K 性能基线使用 50,144-token 上下文、Q8 KV、MTP draft n-max=2。在完全相同的 48,009-token 输入加 512-token 输出下,三轮平均预填充为 467.03 tok/s,生成速度为 27.98 tok/s。
64K 参数也已完成 48K 严格 A/B 验收:预填充 424.75 tok/s、生成 24.49 tok/s。它是“已验证的按需长上下文 Profile”,不是当前常驻的第二个生产服务,更不是已经由网关自动分流的双实例。
核心技术栈选型一览
| 核心组件 | 本文配置 | 选择理由 |
|---|---|---|
| 推理核心 | nasone32/llama.cpp-RDNA3-7900xtx-opt,15995a12… |
文章中的全部参数与成绩均绑定这次 RDNA3 构建。 |
| 运行时 | TheRock ROCm 7.14,gfx1100 |
独立于系统 ROCm,避免破坏已有工作负载。 |
| 主模型 | Qwen3.8-Flash-Next-UD-Q3_K_XL |
主模型分三卷;显存、系统内存与 lazy loading 共同承担运行负载。 |
| 投机解码 | shared Q8_0 MTP draft,n-max=2 |
本机实测的默认折中点。 |
| KV Cache | q8_0 / q8_0 |
以较小精度代价换取更大的上下文和显存余量。 |
| 性能基线 Profile | FAST-50K,ctx-size=50144 |
48K 严格 A/B 中 PP / TG 都优于 64K。 |
| 长上下文 Profile | STABLE-64K,按需启动 | 已完成 48K 严格验收,但不是常驻路由后端。 |
OpenAI 兼容客户端
        │
        ▼
鉴权网关(完成安全加固后才开放)
        │
        ▼
FAST-50K · llama-server :8082
        │
        ▼
RX 7900 XTX × 2(layer split) + Host RAM + Lazy Loading

超过约 48K 的任务:受控停止 FAST-50K → 启动 STABLE-64K → 验收 → 恢复
⚡ 一、这台机器实际跑出了什么
| 项目 | FAST-50K:性能基线 | STABLE-64K:按需验证 |
|---|---|---|
ctx-size |
50,144 | 65,536 |
batch-size / ubatch-size |
4096 / 1024 | 4096 / 1024 |
| KV Cache | Q8_0 / Q8_0 | Q8_0 / Q8_0 |
| MTP | adaptive,最大 2 token | adaptive,最大 2 token |
fit-target |
3800,1024 | 5000,2048 |
| 48,009-token PP,3 轮平均 | 467.03 ± 1.32 tok/s | 424.75 ± 1.66 tok/s |
| 512-token TG,3 轮平均 | 27.98 ± 0.20 tok/s | 24.49 ± 1.99 tok/s |
| 三轮平均总耗时 | 121.08s | 134.06s |
这组 A/B 的输入 Token ID、采样种子和输出长度一致,且关闭 Prefix Cache:prompt_n=48009、predicted_n=512、cache_n=0、truncated=false。因此它能说明两个 Profile 在 48K 实际工作负载 下的差异。
但它不能替代近窗口上限的容量验收。65,536 是总上下文窗口,输入还必须为系统提示词、模板和输出预留空间;它不等于“百万汉字”或“百万字文档”。
同一服务的 0.5K–8K API 扫描:不要和 48K A/B 混比
另一次单并发 OpenAI API 扫描把提示词从 512 token 递增到 8,192 token。请求自然结束,实际输出只有 119–155 token;它不是固定 512-token 输出的压力测试。界面报告的数据如下:
| 测试口径 | Prompt 范围 | 输出长度 | PP 吞吐 | TG 吞吐 |
|---|---|---|---|---|
| API 扫描,单并发 | 512–8,192 | 119–155,自然结束 | 平均 544.11;P50 583.64 tok/s | 平均 36.07;P50 34.73 tok/s |
| 严格 A/B,FAST-50K | 48,009 | 512,固定输出 | 467.03 tok/s | 27.98 tok/s |
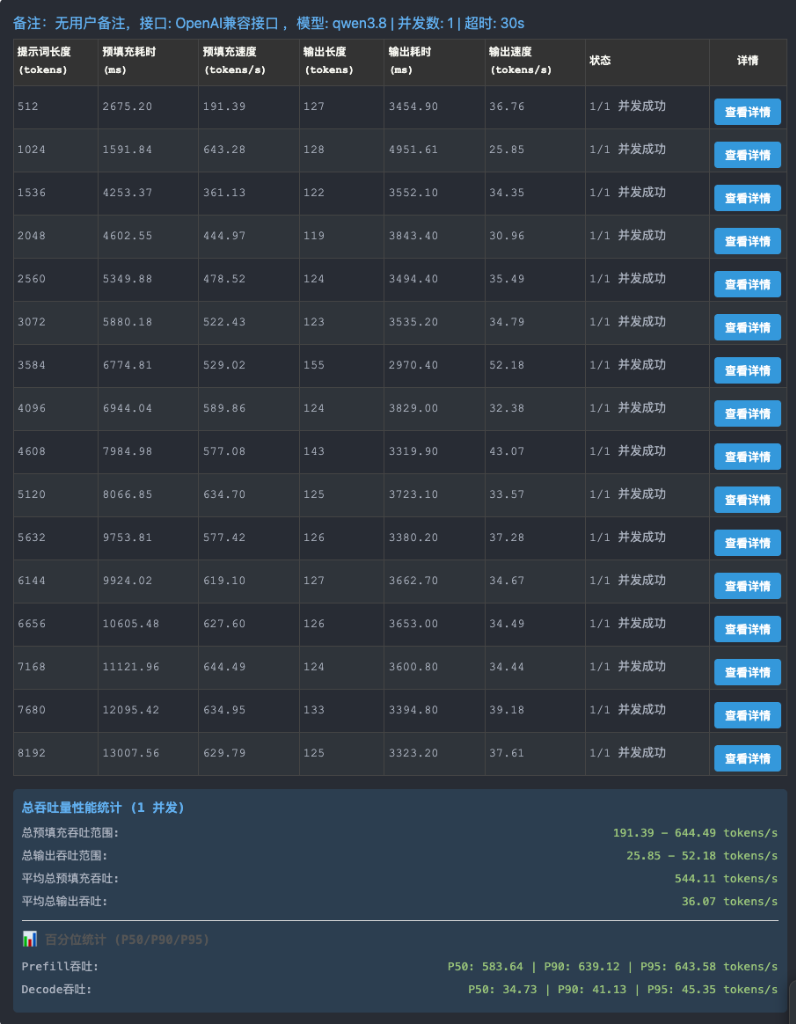
图 1|FAST-50K(50,144 context)日常 API 扫描。PP 平均 544.11 tok/s、P50 583.64 tok/s;TG 平均 36.07 tok/s、P50 34.73 tok/s。每轮输出自然结束在 119–155 token,不是固定 512-token 压测。
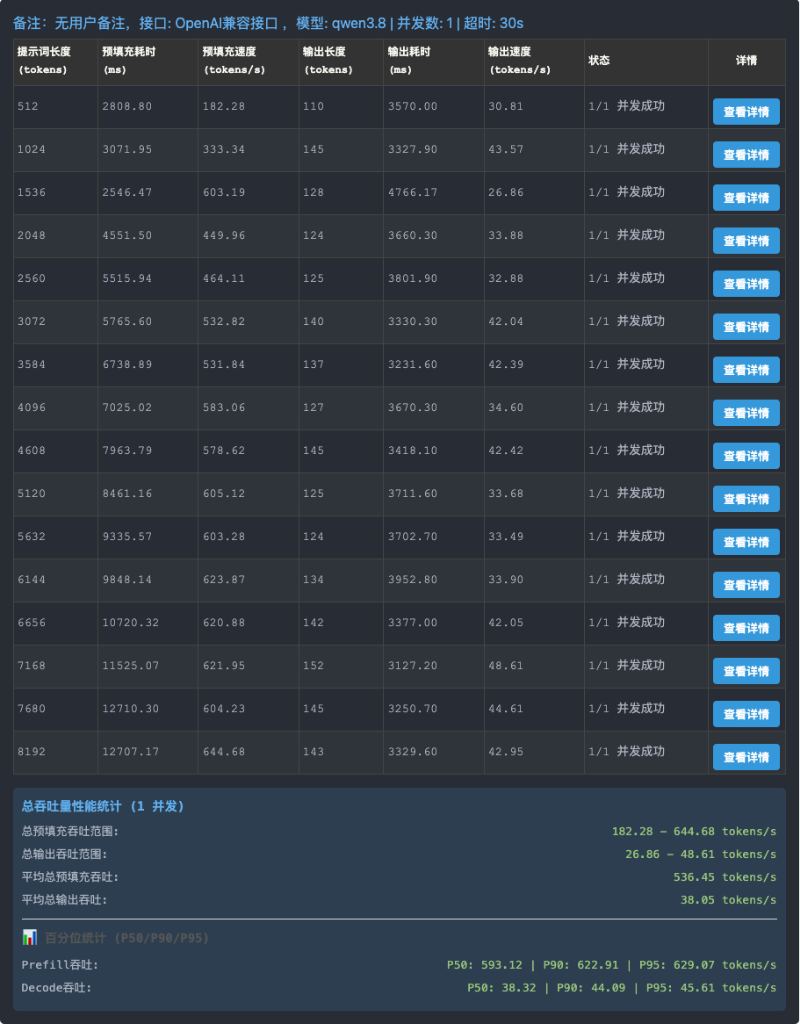
图 2|将服务切为 32,768 context 后,以同一界面和单并发口径复测。PP 平均 536.45 tok/s、P50 593.12 tok/s;TG 平均 38.05 tok/s、P50 38.32 tok/s。相较图 1,P50 PP 小幅提高,TG 指标更高;但每轮自然输出长度不同,不能将这两张 API 扫描图当成严格的因果性能结论。
更严格的 24,576-token + 固定 256-token、cache_prompt=false 对照显示,32K 相比 50K 的平均 PP 从 526.54 提升到 534.68 tok/s(约 +1.5%),TG 从 29.53 提升到 30.39 tok/s(约 +2.9%)。这才是判断“缩短 context 是否更快”的主要依据。
两行数据并不矛盾。随着 prompt 变长,attention 与 KV 访问成本会提高,新的 token 需要关注更长的历史;所以 48K 的 Prefill、尤其 Decode,低于 8K 内的中位数是正常现象。反过来,短扫首轮还会包含 lazy loading、图捕获或后台干扰,截图中 512-token 的 191.39 tok/s 与 1,536-token 的 361.13 tok/s 就不适合被当作模型上限。
以后引用速度时,必须同时写出:prompt token 数、固定或自然结束的输出长度、并发数、是否命中 Prefix Cache,以及 PP / TG 的统计方式。只写一个“tokens/s”没有可比性。
💡 架构边界先说清楚:FAST-50K 是本文常驻基线,64K 脚本已通过严格 A/B,但尚未由独立 systemd 服务常驻,也没有在网关中按模型名自动路由。把两者写成“已上线双 Profile 集群”是不准确的。
🛠️ 二、硬件与软件基线
| 组件 | 实测配置 | 为什么重要 |
|---|---|---|
| GPU | RX 7900 XTX 24GB × 2,gfx1100 |
双卡层切分,共同承载模型与 KV / scratch。 |
| 内存 | 验证平台为 96GB 物理内存(约 94.2GiB) | 这是性能数据的实测环境,不是宣称的最低要求。 |
| 推理核心 | RDNA3 优化分支,commit 15995a12… |
本文所有参数都绑定该构建,不能直接照搬到任意 upstream 版本。 |
| 独立运行时 | TheRock ROCm 7.14 | 不改动既有系统 ROCm;AMD 官方提供 gfx110X tarball。 |
| 主模型 | Qwen3.8-Flash-Next-UD-Q3_K_XL |
主模型分三卷;显存、系统内存与 lazy loading 共同承担运行负载。 |
| Draft 模型 | mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf |
复用主模型部分权重,用于投机解码。 |
先确认系统和两张卡:
uname -a
free -h
df -h /
rocminfo | grep -E 'Name:.*gfx1100'
rocm-smi
两张卡应显示为 gfx1100。如果设备编号中还混有核显,不要假设 0,1 必然是两张 7900 XTX;先执行 llama-server --list-devices 再设 HIP_VISIBLE_DEVICES。
64GB 还是 96GB?按目标选择
| 主机内存 | 适合的目标 | 使用边界 |
|---|---|---|
| 64GB | 32K;FAST-50K 单并发 | 关闭其他大模型服务,保持 --parallel 1,用真实 24K–48K 请求验收且持续观察 Swap。 |
| 96GB | FAST-50K 的推荐配置;64K 验证环境 | 为 host-resident experts、模型文件页缓存和长请求波动留出更大余量。 |
| 128GB+ | 64K 长会话、多并发或更多后台服务 | 适合将长上下文服务作为长期基础设施使用。 |
模型文件约 90GB,不代表它会把 90GB 全部常驻进 RAM。这里依赖 mmap、host-resident experts 与 lazy loading;但空闲时能启动,不等于长 Prompt 下就一定稳定。64GB 主机首次部署后至少完成一次 24K 和一次接近目标上限的冷请求,并确认:
free -h
swapon --show
验收期间不应出现持续增长的 Swap、OOM 或请求结束后无法回落的可用内存。若目标是 64K,不要把 64GB 当作已验证配置;先完成该机器自身的长请求验收,再决定是否长期使用。
🚀 三、独立安装 ROCm 7.14,不碰系统 ROCm
TheRock 的 gfx110X 包是 AMD 官方提供的安装方式,下载地址与文件名以 ROCm 官方文档为准:
mkdir -p ~/rocm714-download
cd ~/rocm714-download

wget https://repo.amd.com/rocm/tarball-multi-arch/therock-dist-linux-gfx110X-all-7.14.0.tar.gz

sudo mkdir -p /opt/qwen38/rocm-7.14
sudo chown "$USER":"$USER" /opt/qwen38/rocm-7.14
tar -xf therock-dist-linux-gfx110X-all-7.14.0.tar.gz -C /opt/qwen38/rocm-7.14
运行时环境统一写进启动脚本和 systemd,不依赖登录 shell:
export ROCM_PATH=/opt/qwen38/rocm-7.14
export PATH="$ROCM_PATH/bin:$ROCM_PATH/lib/llvm/bin:$PATH"
export LD_LIBRARY_PATH="$ROCM_PATH/lib:$ROCM_PATH/lib/llvm/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
不要只在普通 shell 中直接执行 ldd llama-server 来判断是否串库。它可能没有带入服务的 LD_LIBRARY_PATH。更可靠的验收是:
# 启动前:在与服务相同的环境下检查
env LD_LIBRARY_PATH=/opt/qwen38/rocm-7.14/lib:/opt/qwen38/rocm-7.14/lib/llvm/lib   ldd /opt/qwen38/src/llama.cpp-RDNA3-7900xtx-opt/build-rocm-gfx1100-portable/bin/llama-server   | grep -Ei 'hip|hsa|rocblas|hipblas'

# 启动后:以实际进程映射为准
grep -E '/opt/qwen38/rocm-7\.14/.*(libhip|libhsa|libroc|libamd)' /proc/<LLAMA_PID>/maps
🔧 四、构建 RDNA3 版本 llama.cpp
sudo apt update
sudo apt install -y git cmake ninja-build build-essential pkg-config curl wget python3 python3-pip libssl-dev

sudo mkdir -p /opt/qwen38/{models,src,logs,benchmarks,conf,bin}
sudo chown -R "$USER":"$USER" /opt/qwen38

cd /opt/qwen38/src
git clone https://github.com/nasone32/llama.cpp-RDNA3-7900xtx-opt.git
cd llama.cpp-RDNA3-7900xtx-opt
git checkout 15995a12d1d530645a4f34c72afdaa30fa680149

cmake -S . -B build-rocm-gfx1100-portable -G Ninja   -DCMAKE_BUILD_TYPE=Release   -DCMAKE_C_COMPILER="$ROCM_PATH/lib/llvm/bin/clang"   -DCMAKE_CXX_COMPILER="$ROCM_PATH/lib/llvm/bin/clang++"   -DCMAKE_HIP_COMPILER="$ROCM_PATH/lib/llvm/bin/clang"   -DCMAKE_HIP_FLAGS='-mllvm --amdgpu-unroll-threshold-local=600'   -DGGML_HIP=ON   -DGGML_HIP_GRAPHS=ON   -DAMDGPU_TARGETS=gfx1100   -DLLAMA_BUILD_TESTS=ON

cmake --build build-rocm-gfx1100-portable -j "$(nproc)"
📦 五、下载主模型与 MTP Draft
python3 -m venv ~/hf-cli
source ~/hf-cli/bin/activate
pip install -U huggingface_hub

mkdir -p /opt/qwen38/models/Qwen3.8-Flash-Next-GGUF/{UD-Q3_K_XL,MTP}

hf download unsloth/Qwen3.8-Flash-Next-GGUF   UD-Q3_K_XL/Qwen3.8-Flash-Next-UD-Q3_K_XL-00001-of-00003.gguf   UD-Q3_K_XL/Qwen3.8-Flash-Next-UD-Q3_K_XL-00002-of-00003.gguf   UD-Q3_K_XL/Qwen3.8-Flash-Next-UD-Q3_K_XL-00003-of-00003.gguf   --local-dir /opt/qwen38/models/Qwen3.8-Flash-Next-GGUF

hf download unsloth/Qwen3.8-Flash-Next-GGUF   MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf   --local-dir /opt/qwen38/models/Qwen3.8-Flash-Next-GGUF

deactivate
模型只指定第一分卷即可,llama.cpp 会发现后续分卷。
⚙️ 六、FAST-50K:性能基线参数
先把核心命令跑通,再交给 systemd。下面保留了实际验证过的推理参数;示例刻意绑定 127.0.0.1,避免把未加固后端直接暴露到局域网。
#!/usr/bin/env bash
set -euo pipefail

ROCM_PATH=/opt/qwen38/rocm-7.14
ROOT=/opt/qwen38/src/llama.cpp-RDNA3-7900xtx-opt
SERVER="$ROOT/build-rocm-gfx1100-portable/bin/llama-server"
MODEL=/opt/qwen38/models/Qwen3.8-Flash-Next-GGUF/UD-Q3_K_XL/Qwen3.8-Flash-Next-UD-Q3_K_XL-00001-of-00003.gguf
DRAFT=/opt/qwen38/models/Qwen3.8-Flash-Next-GGUF/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf

export PATH="$ROCM_PATH/bin:$ROCM_PATH/lib/llvm/bin:$PATH"
export LD_LIBRARY_PATH="$ROCM_PATH/lib:$ROCM_PATH/lib/llvm/lib"
export HIP_VISIBLE_DEVICES=0,1
export GGML_CUDA_ALLREDUCE=internal
export GGML_CUDA_AR_WIRE=q8_0
export GGML_CUDA_AR_Q8_THRESHOLD=1048576
export GGML_CUDA_AR_FUSED_RESIDUAL=1
export GGML_CUDA_GDN_CHUNKED_BF16=1
export GGML_CUDA_AR_P2P=0

exec "$SERVER"   --model "$MODEL"   --model-draft "$DRAFT"   --alias qwen3.8-flash-next-fast50k,qwen3.8-default,qwen3.8   --api-key-file /opt/qwen38/conf/api_keys.txt   --metrics   --host 127.0.0.1 --port 8082   --ctx-size 50144   --spec-type draft-mtp-adaptive   --spec-draft-n-min 1   --spec-draft-n-min-adaptive 1   --spec-draft-n-max 2   --device-draft ROCm0   --split-mode layer   --flash-attn on   --batch-size 4096 --ubatch-size 1024   --moe-expert-cache 0   --cache-type-k q8_0 --cache-type-v q8_0   --parallel 1   --fit on --fit-target 3800,1024   --load-mode none --lazy-mode on-direct   --temp 0.0 --top-p 0.95 --top-k 20 --min-p 0.0   --presence-penalty 0.0   --reasoning on --reasoning-effort medium
为什么默认是 50K?
同一测试中,FAST-50K 的 48K Prefill 比 64K 快约 9%,生成快约 12.5%。日常编码、问答和中长任务选择它,性价比更高。
🧪 七、STABLE-64K:已验证,但按需切换
64K 不是把 ctx-size 改大就结束。此机型在维持 ubatch=1024 时,需要将 layer placement 调整为:
--ctx-size 65536
--fit-target 5000,2048
其他核心参数与 FAST-50K 保持一致。这样能给一次较大的 ggml_gallocr scratch 分配留出空间,而不是粗暴把 ubatch 从 1024 降到 512。
但请不要直接编辑常驻 FAST 脚本再重启来“切换 Profile”。正确做法是保留独立的 start-q3-stable64k.sh,并在每次切换前完成:停止 FAST、启动 64K、健康检查、执行长上下文验收、完成后恢复 FAST。要做到无人值守再为它创建独立 service 和受控切换脚本。
🔐 八、API、网关与安全:先完成加固,再开放 LAN
llama-server 的 OpenAI 兼容接口可直接验证:
export QWEN38_API_KEY='从安全的环境变量或密码管理器读取'

curl http://127.0.0.1:8082/v1/models   -H "Authorization: Bearer $QWEN38_API_KEY"
后端 API Key 并不等于已安全开放局域网。以下三条必须同时满足:
- 后端只监听 localhost,或防火墙精确放行可信网段与 VPN;绝不直接面向公网开放。
- 网关必须验证客户端身份。不能让任意 LAN 请求自动获得后端 Bearer Key。
- 流式验收必须通过:
stream=true的响应最终必须收到data: [DONE]。HTTP/1.1 代理不能丢掉 chunked 编码或结束标记,否则 Cherry、OpenAI SDK 等客户端会显示正文后永久“处理中”。
发布前应实测:
curl -N http://<gateway>/v1/chat/completions -H 'Content-Type: application/json' -H 'Authorization: Bearer <client-key>' -d '{"model":"qwen3.8","messages":[{"role":"user","content":"只回复 OK"}],"stream":true,"max_tokens":32}'
输出末尾必须是:
data: [DONE]
🧰 九、systemd:守护 FAST-50K,也要守护网关
模型进程应由 systemd 管理,启动脚本末尾必须使用 exec。最小单元如下:
[Unit]
Description=Qwen3.8 Flash Next FAST-50K
After=network-online.target
Wants=network-online.target

[Service]
Type=exec
User=xin
Group=xin
SupplementaryGroups=render video
WorkingDirectory=/opt/qwen38
ExecStartPre=/opt/qwen38/bin/preflight-check.sh
ExecStart=/opt/qwen38/start-q3-fast50k.sh
ExecStartPost=/opt/qwen38/bin/wait-health.sh
Restart=on-failure
RestartSec=10
TimeoutStartSec=300
LimitNOFILE=65535
LimitMEMLOCK=infinity

[Install]
WantedBy=multi-user.target
网关是另一项服务,不能依赖 nohup python router.py &。它也应有独立 unit、依赖后端 health check、使用受限运行用户,并在进程退出时自动重启。否则“模型服务已自动恢复”只覆盖模型,不覆盖客户端真正访问的入口。
✅ 十、发布前验收清单
[ ] 实际运行进程加载的是独立 ROCm 7.14 库
[ ] FAST-50K 的 systemd 服务 enabled + active
[ ] /health、/v1/models 与一次非流式调用通过
[ ] 流式调用收到 data: [DONE]
[ ] 网关要求客户端 API Key;后端密钥不对 LAN 自动注入
[ ] 防火墙规则已按实际网段验收,而不是只写在文档里
[ ] 64K Profile 有近窗口上限的独立验收,且结果归档
[ ] 若声称“双 Profile 路由”,已实际部署第二服务和模型名分流
结论
这套双 7900 XTX 的价值不在于把所有参数推到极限,而在于把一台可重复验证的本地推理机跑稳:默认 50K 获得更好的交互性能;真正需要更长上下文时,再受控切到已验证的 64K 配置。
性能数据已经有原始三轮 A/B 支撑。下一步优先级不是继续追 1–2 tok/s,而是把网关鉴权、systemd 托管、64K 自动切换和近上限验收补齐。完成这些之后,它才是一套可以放心交给多个开发工具使用的本地推理基础设施。
参考资料
- AMD ROCm 7.14 TheRock 安装文档:https://rocm.docs.amd.com/en/docs-7.14.0/install/rocm.html
- llama.cpp HTTP / OpenAI 兼容接口文档:https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md
About The Author