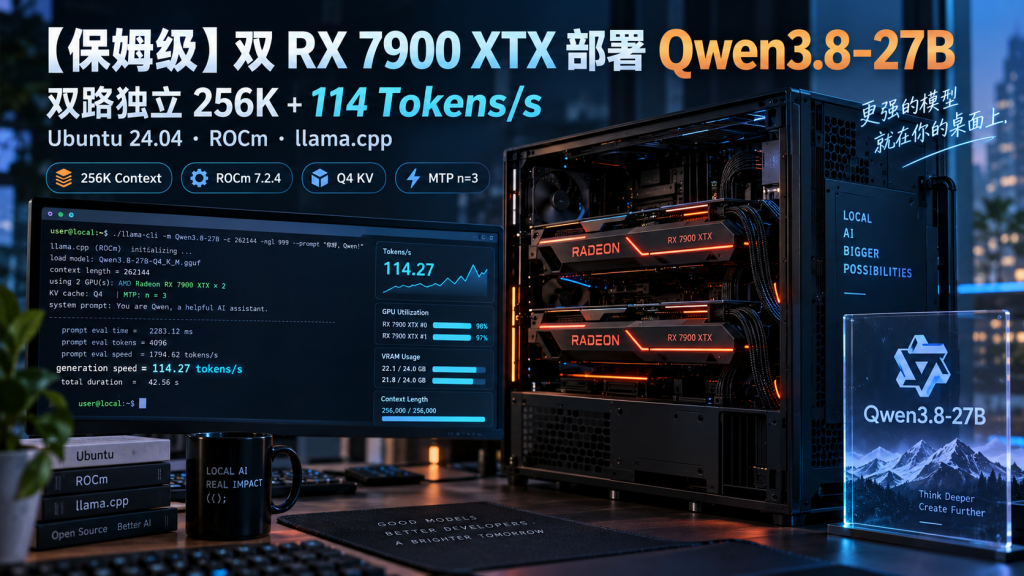
【保姆级】双 RX 7900 XTX 部署 Qwen3.8-27B:双路独立 256K + 114 Tokens/s(Ubuntu 24.04 + ROCm + llama.cpp)
导读与事实基底声明 (SSOT):
本文所有核心性能数据、显存占用与长文本测试,均来自 2026-09-14 本机实测环境(AMD Ryzen 7 3700X + 96GB DDR4 + AMD Radeon RX 7900 XTX 24GB ×2 + Ubuntu 24.04.4 LTS + ROCm 7.2.4 + llama.cppb10951-093a2f86c)。相关性能数据代表特定硬件拓扑与软件版本组合下的真实实测结果,不应绝对推广为所有双卡环境的理论必然值。
日常使用 Cursor、Claude Code、Continue 等多个自主 Agent 协同编程或处理长工程项目时,云端 API 的并发限流、高昂费用以及深长上下文下的延迟,始终是困扰开发者的痛点。
面对两张 24GB 显卡,多数人习惯直接启用双卡 Tensor Parallel(张量并行)合成单一服务。然而实测表明:在多槽位并发(-np 2)下,不仅总 Context 会被切分(每个 Agent 实际只能分到约 128K),而且当一个 Agent 进行十万 Token 的重度 Prefill 时,另一个正 Decode 的 Agent 速度会受到严重影响,暴跌至约 1.1 Tokens/s。
本文采用服务级解耦工程思路:两张显卡分别独立承载一个完整 Qwen3.8-27B 实例,配合 UD-IQ4_XS 量化、Q4 KV Cache 压缩以及 MTP(Multi-Token Prediction)推测加速,达成双路各自独立 256K 满血上下文,在本文测试机上跑出短文本双路聚合 114.45 Tokens/s,且交叉负载干扰极低!
核心技术栈选型一览:
| 核心组件 | 选型 | 为什么这样选?(破局关键) |
|---|---|---|
| 推理底座 | llama.cpp 主线 (b10951-093a2f86c) |
针对 ROCm 7.2.4 与 gfx1100 架构深度编译,原生集成 Flash Attention,并可按需开启 RCCL 跨卡通信。 |
| 大脑模型 | Qwen3.8-27B (UD-IQ4_XS.gguf) |
阿里开源 27B 密集(Dense)模型,原生支持 256K(262,144)上下文。测试版本权重约 13.27 GiB,深长上下文 Decode 表现优于 Q4_K_M,并为 KV Cache 留出关键显存余量。 |
| 投机加速 | Multi-Token Prediction (MTP/mtp-Qwen3.8-27B-Q4_0.gguf) |
本文实测锁定预测步长 n=3 为最佳效率拐点。(注:新版 llama.cpp 与 Unsloth 权重已支持内嵌 MTP,可不再外挂 -md 文件)。 |
| 显存压缩 | Q4 KV Cache (ctk/ctv q4_0) + Flash Attention |
注意力缓存采用 Q4 深度压缩,单卡整卡总显存控制在约 22.4 GiB,使 262,144 完整上下文在 24GB 显存内稳定驻留(保留约 1.6 GiB 裕度)。 |
| 拓扑架构 | 双路独立并发实例 (ROCm0:8080 / ROCm1:8081) |
彻底解耦两张显卡,推理实例相互独立,无需逐 Token 跨卡同步,彻底规避张量并行模式下的槽位腰斩与互锁大幅降速。 |
| 通信协议 | OpenAI 兼容 API (/v1) |
分别监听 0.0.0.0:8080 与 8081,可同时无缝供两个独立 Agent 工具(如 Cursor 与 Continue)全速并发调用。 |
flowchart TD
  subgraph Clients["开发者客户端集群"]
    AgentA["编程 Agent A (Cursor / Cline)"]
    AgentB["重构 Agent B (Continue / 脚本)"]
  end

  subgraph Host["Ubuntu 24.04 (llama.cpp ROCm Runtime)"]
    subgraph Srv0["独立实例 A (:8080)"]
      API0["OpenAI API (:8080)"] --> Eng0["llama-server (FA On + MTP n=3)"]
      Eng0 --> M0["Qwen3.8-27B (UD-IQ4_XS)"]
      Eng0 --> KV0["Q4 KV Cache (独享 256K 上下文)"]
    end

    subgraph Srv1["独立实例 B (:8081)"]
      API1["OpenAI API (:8081)"] --> Eng1["llama-server (FA On + MTP n=3)"]
      Eng1 --> M1["Qwen3.8-27B (UD-IQ4_XS)"]
      Eng1 --> KV1["Q4 KV Cache (独享 256K 上下文)"]
    end
  end

  subgraph Hardware["硬件底层 (推理实例相互独立,无跨卡同步)"]
    VRAM0["GPU 0: RX 7900 XTX 24GB<br/>(实测占用 ~22.4 GiB)"]
    VRAM1["GPU 1: RX 7900 XTX 24GB<br/>(实测占用 ~22.4 GiB)"]
  end

  AgentA -->|独立调用| API0
  AgentB -->|独立调用| API1
  Eng0 -.->|独占显存| VRAM0
  Eng1 -.->|独占显存| VRAM1

  classDef highlight fill:#1e293b,stroke:#38bdf8,stroke-width:2px,color:#fff;
  class AgentA,AgentB,API0,API1,Eng0,Eng1,M0,M1,KV0,KV1,VRAM0,VRAM1 highlight;
⚡ 一、能达到的实测效果(真机硬核数据战报)
1. 核心实测指标与对比矩阵
(注:以下性能数据均来自本文测试平台在 2026-09-14 的真机测试实录)
| 评测维度 | 单卡旧方案 (Q4_K_M) | 双卡 Tensor 并行 (Q4_K_M) | 双卡 Tensor 并行 (IQ4_XS) | 本文双独立实例方案 (默认推荐) |
|---|---|---|---|---|
| 单实例最大 Context | 262,144 (256K) | 262,144 (单槽位) | 262,144 (单槽位) | GPU0: 256K / GPU1: 256K (双路各满血) |
| 多 Agent 并发可用 Context | 无法支持双任务 | 128K + 128K (槽位对半切) | 128K + 128K (槽位对半切) | 各自完整 256K 独立上下文 |
| 短 Prompt Decode | 52 ~ 53 t/s | ~62.4 t/s | ~62.7 t/s | GPU0: 58.19 t/s + GPU1: 56.26 t/s (双路聚合 114.45 t/s) |
| 114K 真实代码 Prefill | ~450 t/s | ~916 t/s | ~924.3 t/s | GPU0: 603.93 t/s + GPU1: 602.72 t/s (整机聚合 ~1206 t/s) |
| 114K 真实代码 Decode | 27.7 t/s | 44.0 t/s | 48.0 t/s | GPU0: 41.89 t/s + GPU1: 38.70 t/s (双路聚合 80.59 t/s) |
| 交叉并发干扰测试 | 无法并发 | 互锁:Decode 骤降至 1.1 t/s | 互锁:Decode 骤降至 1.1 t/s | 抗干扰极佳:另一路仅微降 ~5% (维持 38.48 t/s) |
| 显存占用实测 | ~23.1 GiB | 双卡各 ~22.6 GiB (F16 KV) | 双卡各 ~21.2 GiB (F16 KV) | 双卡各稳定驻留 ~22.4 GiB (保留 ~1.6 GiB 裕度) |
2. 真实显存占用实测与说明
- 单卡实测总显存占用:
rocm-smi实测稳定在 ~22.4 GiB(在 24.0 GiB 物理显存中保留约 1.6 GiB 缓冲区,测试全过程零 OOM、零系统内存交换)。 - 静态权重开销:UD-IQ4_XS 模型权重文件在测试版本中约为 13.27 GiB(十进制标称约 14.3 GB);
- 长上下文 KV 与动态缓冲:在 256K 超长窗口下,Q4 KV Cache 与运行时计算图消耗约 8~9 GiB 显存。
- 注:文件大小与显存占用来自测试当日版本,后续模型量化权重和软件更新可能会有细微变动。
3. 量化与投机参数深度对比
① 模型量化实测:UD-IQ4_XS vs Q4_K_M
| 量化规格 | 测试权重体积 | 114K 代码 Prefill | 114K 代码 Decode | 显存空间节约 |
|---|---|---|---|---|
| Q4_K_M | 约 15.90 GiB | 916.0 t/s | 44.0 t/s | 基准 |
| UD-IQ4_XS | 约 13.27 GiB | 924.3 t/s | 48.0 t/s (+9.1%) | 节约约 2.6 GiB (16.5%) |
在 114K 真实长上下文下,UD-IQ4_XS 相比 Q4_K_M 减轻了显存带宽压力,长上下文 Decode 表现反而具有优势。
② MTP 投机步长实测 (--spec-draft-n-max)
针对 114K 真实代码上下文进行严格对照测试:
* n=2:45.5 Tokens/s
* n=3:48.0 Tokens/s(吞吐最佳拐点,预测命中率与回滚校验开销达到最佳平衡)
* n=4:40.8 Tokens/s(步长过长导致命中率边际递减,回滚开销增加,速度反而下滑)
③ 分任务体感与能力保留细化:
- 日常代码重构与多文件补全(Python / TS / Go / Shell):体感差异极小。UD-IQ4_XS 保留了 Qwen3.8-27B 原生极强的代码理解与语法生成能力,函数编写、单元测试补全与架构重构准确率与 Q4_K_M 相比几乎没有可感知的差距。
- Agent 复杂工具调用与 JSON 格式容错:在严格 Function Calling 与深度嵌套 JSON 输出场景下,模型依然能严谨闭合括号并准确遵循 Schema 约束。
- 114K 真实代码“大海捞针”与长程追溯:在 114,130 Tokens 的真实长源码输入中埋入跨文件调用链与隐蔽逻辑测试,两路实例均准确命中调用链细节,0 截断、0 丢失,验证了 256K 超长窗口配合 Q4 KV Cache 的真实可用性。
💡 核心结论:在双 7900 XTX 硬件环境下,“双路独立 256K 实例” 能提供两个完全独立的 256K 上下文空间,不仅跑出了双路聚合 114.45 t/s 的短文本吞吐,更关键的是将多 Agent 间的交叉并发干扰降到了最低(实测降幅仅约 5%),是多 Agent 协同开发的坚实方案。
🛠️ 二、极简准备工作(无需繁琐配置,10秒自查)
1. 硬件要求自查
- GPU:AMD Radeon RX 7900 XTX 24GB × 2(Navi 31,gfx1100)。
- CPU & 内存:8 核以上 CPU(本文为 Ryzen 7 3700X),系统物理内存建议 48GB 及以上(根据 nvtop 真机监控实测,单实例在 Host 端常驻约 18.9~19.3 GiB 内存,用于 ROCm 驱动 Pinned Memory、mmap 文件缓存与 256K 巨型上下文管理。双实例并发实测总消耗 39,110 MiB(严格处于 40GB 以内,约 38.2 GiB)。因此 32GB 内存必然爆仓触发 OOM,读者配置 48GB 物理内存 即可完美平稳运行并保留充足系统余量,无需强上 64GB 或 96GB)。
- 磁盘空间:预留 60GB 以上 NVMe 固态硬盘空间。
- 拓扑说明:双独立实例各自独立绑定 GPU(
--split-mode none),不依赖跨卡 P2P 与 RCCL 通信;若后续希望兼顾双卡 Tensor Parallel 模式,建议确认双卡位于 CPU 直连的 PCIe 4.0 x8/x8 通道。
2. 安装基础依赖与显卡驱动
sudo apt update && sudo apt upgrade -y
sudo apt install -y git curl wget cmake ninja-build build-essential pciutils psmisc jq python3 python3-pip python3-venv
安装 AMD ROCm 7.2.4(依据 AMD 官方 Ubuntu 24.04 指南整理):
cd ~
wget https://repo.radeon.com/amdgpu-install/7.2.4/ubuntu/noble/amdgpu-install_7.2.4.70204-1_all.deb
sudo apt install ./amdgpu-install_7.2.4.70204-1_all.deb
sudo apt update
sudo apt install -y rocm rccl rccl-dev
sudo usermod -a -G render,video $USER
sudo reboot
重启后确认显卡状态:
rocm-smi
rocminfo | grep -E "Name:|gfx"
两张显卡均应正确识别为 gfx1100。
3. 【可选】自查 PCIe P2P 拓扑(仅 Tensor 模式需要)
若计划保留双卡 Tensor Parallel 方案,可自查跨卡 P2P:
sudo apt install -y rocm-bandwidth-test
rocm-smi --showtopoaccess
rocm-bandwidth-test plugin --run tb p2p
- 本机实测返回:
GPU0 → GPU1: True,GPU1 → GPU0: True;双向聚合带宽约 17.5 GB/s。 - 注:若仅运行本文推荐的双独立实例,此项无需强求。
🚀 三、准确的安装步骤
路径 A:【强烈推荐】一键全自动部署脚本
针对 Ubuntu 24.04 的 PEP 668 规范,该脚本使用独立的 python3-venv 虚拟环境隔离安装 CLI 工具,编译支持 ROCm 的 llama.cpp,并自动生成双实例启动管理脚本:
cat << EOF > ~/setup_qwen38_dual_256k.sh
#!/usr/bin/env bash
set -eo pipefail

echo "=== 1. 编译支持 ROCm 的 llama.cpp 底座 ==="
cd ~
if [ ! -d "llama.cpp" ]; then
  git clone https://github.com/ggml-org/llama.cpp
fi
cd llama.cpp
HIPCXX="$(hipconfig -l)/clang" HIP_PATH="$(hipconfig -R)" cmake -S . -B build-rocm -G Ninja   -DGGML_HIP=ON   -DGGML_HIP_RCCL=ON   -DGPU_TARGETS=gfx1100   -DCMAKE_BUILD_TYPE=Release
cmake --build build-rocm -j"$(nproc)"

echo "=== 2. 在 venv 中安装 Hugging Face 工具并下载模型 ==="
python3 -m venv ~/hf-cli
source ~/hf-cli/bin/activate
pip install -U huggingface_hub

export HF_ENDPOINT=https://hf-mirror.com
mkdir -p "$HOME/AI/models/Qwen3.8-27B-GGUF"
cd "$HOME/AI/models/Qwen3.8-27B-GGUF"

# 下载主模型
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-IQ4_XS.gguf --local-dir .
# 下载 MTP 辅助模型(注:最新版 GGUF 已内嵌 MTP,若文件已内嵌则此项可跳过)
hf download unsloth/Qwen3.8-27B-GGUF MTP/mtp-Qwen3.8-27B-Q4_0.gguf --local-dir . || true
deactivate

echo "=== 3. 编写双独立 256K 启动脚本 ==="
cat << LAUNCH_EOF > ~/start_qwen_dual_256k.sh
#!/usr/bin/env bash
set -eo pipefail
pkill -9 -f llama-server || true
sleep 2

MODEL="$HOME/AI/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-IQ4_XS.gguf"
MTP_DIR="$HOME/AI/models/Qwen3.8-27B-GGUF"
LLAMA="$HOME/llama.cpp/build-rocm/bin/llama-server"

# 判断是否存在独立的 MTP sidecar 文件
MTP_ARGS=()
if [ -f "$MTP_DIR/MTP/mtp-Qwen3.8-27B-Q4_0.gguf" ]; then
  MTP_ARGS=(-md "$MTP_DIR/MTP/mtp-Qwen3.8-27B-Q4_0.gguf")
elif [ -f "$MTP_DIR/mtp-Qwen3.8-27B-Q4_0.gguf" ]; then
  MTP_ARGS=(-md "$MTP_DIR/mtp-Qwen3.8-27B-Q4_0.gguf")
fi

COMMON_ARGS=(
  -m "$MODEL"
  "${MTP_ARGS[@]}"
  --split-mode none
  -ngl all
  -c 262144
  -np 1
  -ctk q4_0
  -ctv q4_0
  -fa on
  --spec-type draft-mtp
  --spec-draft-n-max 3
  --spec-draft-ngl all
  --cache-ram 16384
  -t 8
  --host 0.0.0.0
)

echo "启动 GPU0 实例 (Port: 8080, Context: 256K)..."
"$LLAMA" "${COMMON_ARGS[@]}" --device ROCm0 --spec-draft-device ROCm0 --port 8080 > /tmp/qwen_gpu0.log 2>&1 &

echo "启动 GPU1 实例 (Port: 8081, Context: 256K)..."
"$LLAMA" "${COMMON_ARGS[@]}" --device ROCm1 --spec-draft-device ROCm1 --port 8081 > /tmp/qwen_gpu1.log 2>&1 &

echo "=== 服务已启动!==="
echo "GPU0 实例: http://127.0.0.1:8080"
echo "GPU1 实例: http://127.0.0.1:8081"
LAUNCH_EOF

chmod +x ~/start_qwen_dual_256k.sh
~/start_qwen_dual_256k.sh
EOF

chmod +x ~/setup_qwen38_dual_256k.sh && ~/setup_qwen38_dual_256k.sh
路径 B:极客手动 4 步法(透明掌控细节)
第 1 步:编译 ROCm 版 llama.cpp
cd ~
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

HIPCXX="$(hipconfig -l)/clang" HIP_PATH="$(hipconfig -R)" cmake -S . -B build-rocm -G Ninja   -DGGML_HIP=ON   -DGGML_HIP_RCCL=ON   -DGPU_TARGETS=gfx1100   -DCMAKE_BUILD_TYPE=Release

cmake --build build-rocm -j"$(nproc)"
执行 ./build-rocm/bin/llama-cli --list-devices,确认输出包含 ROCm0 与 ROCm1。
第 2 步:配置 venv 并下载模型权重
# 规范使用独立 venv 规避 PEP 668 报错
python3 -m venv ~/hf-cli
source ~/hf-cli/bin/activate
pip install -U huggingface_hub

mkdir -p ~/AI/models/Qwen3.8-27B-GGUF
cd ~/AI/models/Qwen3.8-27B-GGUF

export HF_ENDPOINT=https://hf-mirror.com
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-IQ4_XS.gguf --local-dir .
hf download unsloth/Qwen3.8-27B-GGUF MTP/mtp-Qwen3.8-27B-Q4_0.gguf --local-dir .
deactivate
(注:若所使用的最新版 Unsloth GGUF 已内嵌 MTP tensors,可不再单独下载 MTP 权重)。
第 3 步:编写生产级双独立启动脚本
创建 ~/start_qwen_dual_256k.sh:
cat << EOF > ~/start_qwen_dual_256k.sh
#!/usr/bin/env bash
set -eo pipefail

pkill -9 -f llama-server || true
sleep 2

MODEL="$HOME/AI/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-IQ4_XS.gguf"
MTP="$HOME/AI/models/Qwen3.8-27B-GGUF/MTP/mtp-Qwen3.8-27B-Q4_0.gguf"
LLAMA="$HOME/llama.cpp/build-rocm/bin/llama-server"

# 若模型已内嵌 MTP,可将 COMMON_ARGS 中的 -md "$MTP" 移除
COMMON_ARGS=(
  -m "$MODEL"
  -md "$MTP"
  --split-mode none
  -ngl all
  -c 262144
  -np 1
  -ctk q4_0
  -ctv q4_0
  -fa on
  --spec-type draft-mtp
  --spec-draft-n-max 3
  --spec-draft-ngl all
  --cache-ram 16384
  -t 8
  --host 0.0.0.0
)

# 启动 GPU0 (端口 8080)
"$LLAMA" "${COMMON_ARGS[@]}" --device ROCm0 --spec-draft-device ROCm0 --port 8080 > /tmp/qwen_gpu0.log 2>&1 &

# 启动 GPU1 (端口 8081)
"$LLAMA" "${COMMON_ARGS[@]}" --device ROCm1 --spec-draft-device ROCm1 --port 8081 > /tmp/qwen_gpu1.log 2>&1 &
EOF

chmod +x ~/start_qwen_dual_256k.sh
关键启动参数深度解析:
*--device ROCm0/--spec-draft-device ROCm0:硬绑定单卡物理设备,推理在指定 GPU 上独立完成。
*--split-mode none:显式指定不进行多卡切分,单卡处理完整前向传播。
*-c 262144 -np 1:为该实例分配独享且完整的 262K 上下文槽位。
*-ctk q4_0 -ctv q4_0:将注意力 KV 压缩至 4-bit,使 256K 超长窗口总显存压在 22.4 GiB。
*--spec-type draft-mtp --spec-draft-n-max 3:开启 MTP 投机加速,锁定实测最佳预测步长 3。
第 4 步:服务化管理说明
💡 运维准则:推荐采用脚本按需启动。由于双实例跑满 256K 会总计占用约 45GB 物理显存,按需调起能在需要时快速释放显存,方便随时切换用于 Stable Diffusion、LoRA 微调或其他任务。
🧪 四、最终的测试与验收(6 大硬核测试)
测试 1:检查服务健康与显存状态
curl http://127.0.0.1:8080/health
curl http://127.0.0.1:8081/health

# 检查显存占用
rocm-smi --showmeminfo vram --showuse
实测表现:两个端口均正确返回 {"status":"ok"},GPU0 与 GPU1 显存各自稳定驻留约 22.4 GiB。
测试 2:验证双端口 OpenAI 兼容 /v1 连通性
curl http://127.0.0.1:8080/v1/models
curl http://127.0.0.1:8081/v1/models
两个端口均能正确输出包含当前加载模型的 JSON 结构体。
测试 3:双路短 Prompt 并发基准测速
两端同时发起 512 Tokens 的生成请求:
* GPU0: 58.19 Tokens/s
* GPU1: 56.26 Tokens/s
* 双路聚合出字吞吐: 114.45 Tokens/s(两张卡无跨卡通信开销,算力得以完全释放)。
测试 4:双路 114K 真实代码长上下文实测
使用包含 114,130 Tokens 的真实开源代码库与技术文档进行两端并发测试:
* Prefill 吞吐:GPU0 达到 603.93 t/s,GPU1 达到 602.72 t/s(整机聚合吞吐超 1200 t/s)。
* Decode 深度出字:GPU0 稳定在 41.89 t/s,GPU1 稳定在 38.70 t/s(双路聚合达到 80.59 t/s)。
* 上下文容量:两实例均顺利灌入 114K 内容,无 OOM、无截断,且各自仍保留约 140K 上下文余量。
测试 5:高难度交叉并发负载实测(抗干扰验证)
模拟真实多 Agent 开发场景:
1. GPU1 处于持续 Decode 状态:在 114K 代码上下文下连续生成 2048 Tokens(单独测试初始速度约 40.8~43.6 t/s);
2. GPU0 突发冷启动冲击:在 GPU1 密集生成期间,向 GPU0 突然灌入 114K 真实代码发起冷启动 Prefill。
实测结果:
* GPU0 在 Prefill 阶段跑出 604.10 t/s 的正常速度;
* 正在生成代码的 GPU1 整体速度维持在 38.48 t/s(仅微降约 5%)。
* 实测证实:相较于 Tensor Parallel 模式下因跨 GPU 同步导致的严重降速(Decode 跌至约 1.1 t/s),双独立实例架构在交叉重负载下能保持很高的稳定性与响应速度。
测试 6:局域网接入主流开发工具(Cursor / Continue / Cline)与双 Agent 协同
配置局域网防火墙放行双实例端口:
sudo ufw allow 8080/tcp
sudo ufw allow 8081/tcp
① 原生 OpenAI 兼容 API 联调测试
测试 GPU0 (:8080):
curl http://127.0.0.1:8080/v1/chat/completions   -H "Content-Type: application/json"   -d '{
    "model": "qwen",
    "messages": [
      {
        "role": "user",
        "content": "请用一句话介绍你作为本地编程大脑的核心优势。"
      }
    ],
    "max_tokens": 256
  }'
测试 GPU1 (:8081):只需要将上述请求中的 8080 修改为 8081 即可,均能瞬间返回标准 JSON 数据。
② 双 Agent 协同分工实战配置
在同局域网客户端中配置两个 Agent,实现完全物理隔离的协同生产力:
* Agent A(主力实时编程,如接入 Cursor):
* Base URL: http://<服务器IP>:8080/v1
* API Key: local
* Model Name: qwen(或任意自定义别名)
* 工作流定位: 专用于编辑器内高频代码补全、Inline 编辑与单文件功能生成,独占 GPU0 的 256K 显存与完整计算单元。
* Agent B(架构重构与长程审查,如接入 Continue / Cline / 脚本):
* Base URL: http://<服务器IP>:8081/v1
* API Key: local
* Model Name: qwen
* 工作流定位: 负责多文件全局代码审查、长日志分析与大型项目文档 RAG。即使 Agent B 突然灌入十万行工程上下文,GPU0 上的 Cursor 打字也几乎感受不到卡顿!
❓ 五、高频疑问与极客排错手册 (FAQ)
Q1: 为什么默认选“双独立实例”而不是“双卡 Tensor Parallel”?
答:主要考量两个实际使用因素:
1. 上下文容量:在 Tensor 模式下,设置 -c 262144 -np 2 会把总 Context 对半分配给两个槽位,每个 Agent 实际只能获得约 128K;
2. 算力互锁降速:Tensor Parallel 会在每一层跨 GPU 同步。实测当一个槽位处理 114K Prefill 时,另一个槽位的 Decode 速度会从约 45 t/s 骤降至约 1.1 t/s,严重影响实时响应体验。
Q2: 为什么权重选 UD-IQ4_XS 而不是标准的 Q4_K_M?
答:测试版本中 Q4_K_M 权重约为 15.9 GiB,而 UD-IQ4_XS 约为 13.27 GiB(缩小约 16.5%)。在 114K 长上下文下,IQ4_XS 节省了显存带宽与空间,真机实测 Decode 速度从 44.0 t/s 提高到了 48.0 t/s(提升约 9.1%)。
Q3: 为什么必须使用 Q4 KV Cache?会影响代码输出吗?
答:在单卡 24GB 显存下容纳 256K 上下文时,Q4 KV 是物理必然选择。
Qwen3.8-27B 采用 64 层结构(含约 16 个 full-attention 层,每层 4 个 KV heads,维度 256)。若采用 F16 KV,仅 256K 上下文的 KV Cache 本身就需约 16 GiB;若再叠加约 13.3 GiB 的模型权重与运行时 Buffer,显存需求将突破 30 GiB,24GB 单卡必然爆仓。
Q4 KV 会带来轻微的精度折损,但换来了巨大的显存节约。本文重点在于工程化验证 24GB 跑通完整 256K Context,日常编程与代码重构表现非常稳健。
Q4: 必须下载外部的 MTP sidecar 文件吗?
答:不一定,取决于您获取的模型文件版本:
* 本文 2026-09-14 实测环境:使用的是早期 Unsloth 仓库的独立 MTP/mtp-Qwen3.8-27B-Q4_0.gguf 文件(通过 -md 参数挂载);
* 当前更新情况:较新版 llama.cpp 的 Qwen 架构与 Unsloth GGUF 已支持内嵌 MTP tensors。如果下载的主模型已包含 MTP,启动参数只需保留 --spec-type draft-mtp --spec-draft-n-max 3 --spec-draft-ngl all,无需再传入 -md。
Q5: MTP 预测步长为什么锁死在 n=3?
答:MTP 属于投机解码机制。步长过小推测收益有限;而步长过大时,长距离 Token 的预测命中率会边际递减,导致验证回滚开销加大。真机实测显示:n=2 为 45.5 t/s,n=3 为 48.0 t/s,n=4 回落至 40.8 t/s。因此 n=3 是目前的最佳平衡点。
Q6: 长程 Agent 多轮交互时,每次都会重算 114K 代码上下文吗?
答:不会。llama-server 具备最长公共前缀缓存(LCP Prefix Cache)能力。在第二轮对话测试中,命中 99.9% 历史代码前缀,仅需计算新生成的 93 个 Token,首字响应时间从首轮冷启动的 124 秒大幅缩减至 1.8 秒。
Q7: 为什么启动参数没有保留 --cache-reuse 256?
答:启动日志显式返回 cache_reuse is not supported by this context。当前 llama.cpp 上下文实现对该架构未开放该参数,强行配置会被忽略,故在此直接剔除。
Q8: 模型权重已经全进显卡,为什么宿主机内存需要 48GB(实测在 40GB 以内)?
答:从 nvtop 真机监控实测显示,单个 256K 的 llama-server 实例在 Host 端会常驻约 18.9~19.3 GiB 内存(主要开销来自 ROCm 驱动维持与 GPU 间高速 DMA 传输的锁页内存 Pinned Memory、Linux 内核 mmap 权重常驻集,以及管理 256K 巨型上下文的调度索引与计算图结构)。
两路独立实例并发运行时,Host 内存实测总占用为 39,110 MiB(严格控制在 40GB 以内,约 38.2 GiB)。因此常见的 32GB 内存会被瞬间吃满并触发内核 OOM-Killer 强杀,而配备 48GB 物理内存 即可平稳运行并预留出约 8~10GB 系统安全余量,无需强行上到 64GB 或 96GB。
🔧 六、进阶选读:两套场景专属启动模版
模版 A:双路独立 256K Agent 生产型(本文默认推荐)
- 定位:多 Agent 协同编程(如同时接入 Cursor、Continue 或后台自主 Agent)。
- 特点:双实例独立运行、互不干扰、各自享有完整 256K 上下文。
- 启动方式:直接运行
~/start_qwen_dual_256k.sh。
模版 B:双卡 Tensor Parallel 256K 单重型 Agent 极速型
- 定位:单个超重型单体任务(将两张显卡算力集中服务单个超长上下文任务)。
- 特点:单任务 114K Decode 达 48 t/s,并可开启 F16 KV(需主板支持良好的 PCIe P2P 与 RCCL)。
cd ~/llama.cpp

./build-rocm/bin/llama-server   -m ~/AI/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-IQ4_XS.gguf   --device ROCm0,ROCm1   --split-mode tensor   -ngl all   -c 262144   -np 1   -ctk f16   -ctv f16   -fa on   --spec-type draft-mtp   --spec-draft-n-max 3   --spec-draft-ngl all   -t 8   --host 0.0.0.0   --port 8080
(注:如果模型未内嵌 MTP,可补上 -md 路径及 --spec-draft-device ROCm0,ROCm1)。
生产运维常用命令速查
| 操作需求 | 终端执行命令 |
|---|---|
| 实时跟踪 GPU0 日志 | tail -f /tmp/qwen_gpu0.log |
| 实时跟踪 GPU1 日志 | tail -f /tmp/qwen_gpu1.log |
| 实时监控双卡显存与功耗 | watch -n 1 rocm-smi |
| 停止双实例并释放显存 | pkill -9 -f llama-server |
| 快速释放占用端口 | fuser -k -9 8080/tcp 8081/tcp |
🏁 总结:从“消费 Token”迈向“算力自治”
在双 RX 7900 XTX 硬件平台上部署 Qwen3.8-27B,核心工程价值在于如何根据实际的多 Agent 业务场景合理规划显存与算力分配。
通过将双卡配置为两个完全解耦的独立 256K 实例,我们规避了张量并行模式下的槽位切分限制与并发互锁掉速,在真机上实现了双路短文本聚合 114.45 Tokens/s 的吞吐以及交叉负载下约 5% 的低干扰度。配合 Prefix Cache,两个独立 Agent 能够随叫随到地投入到十万行代码库的深度开发中,为开发者构建起一套低延迟、高隐私的本地私有算力底座。
🛠️ 玩客笔记开发者与算力工具箱
在本地部署大模型、拉取 Hugging Face 权重或调用开源工具时,推荐搭配以下高性价比工具(个人长期自用实测):
- 🌐 全局海外高速节点:高质量海外代理直达(千兆纯净稳定带宽,模型下载与 GitHub 同步不限速);
- 🏠 海外原生住宅 IP:IPRoyal 住宅代理(真实纯净家宽住宅 IP,对各类 AI 平台与自动化风控友好);
- 🔑 开发者海外环境通道:全能海外账号专营店(免繁琐外币卡与复杂配置,一键获取专属海外开发者环境);
- ☁️ 阿里云百炼 · 大模型与算力特惠(最高直省 55%):阿里云百炼专属优惠通道(专属邀请码:
sgy1lcae,通义千问等大模型 Token 节省计划最高省 55%,涵盖 GPU/ECS/OSS 等 120+ 款云产品)。
* 注:部分链接包含专属合作/返利,感谢您对频道独立开发与内容更新的支持!
About The Author