【保姆级】RTX 3060 12GB 极限部署 Qwen 3.8 27B:64K 上下文 + 22 Tokens/s
导读与事实基底声明 (SSOT):
本文所有核心性能数据、显存占用与长文本测试均来自 2026-09-13 真机实测环境(AMD Ryzen 7 3700X + 32GB DDR4 + NVIDIA RTX 3060 12GB + Ubuntu 24.04.4 LTS),数据真实可复现,绝非理论估算。
日常使用 Cursor、Claude Code 或自主 Agent 进行复杂编程与长文档检索时,高昂的云端 API 账单、网络限流排队(429 报错)、以及私有源码上传的安全合规风险,始终是困扰开发者的三大痛点。
但在本地部署 27B 级别大模型时,大部分开发者手头的千元级“甜点卡”RTX 3060 仅有 12GB 显存。普通 Q4 版本的 27B 模型体积通常超过 16GB,一旦权重掉入系统内存(CPU Offload),推理速度便会暴跌至 2~4 Tokens/s。
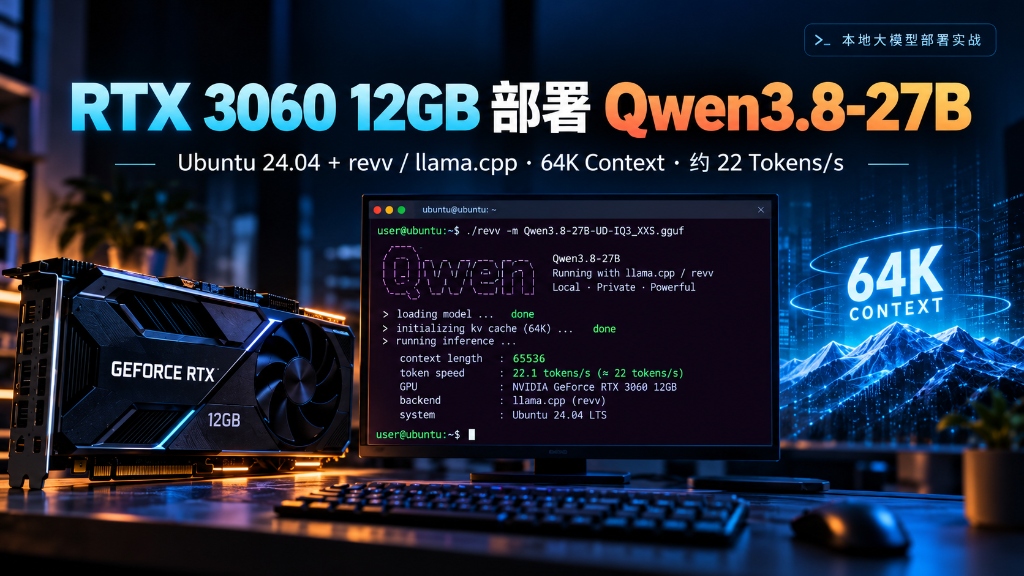
本文不搞“勉强能跑”,而是采用极致工程化思路:以 UD-IQ3_XXS 激进量化确保整模型 100% 驻留 GPU 显存,再通过 Q4 KV Cache + Flash Attention + N-Gram 推测加速,把上下文扩容到真实的 64K,并稳定跑出 ~22 Tokens/s 的生成速度!
核心技术栈选型一览:
| 核心组件 | 选型 | 为什么这样选?(破局关键) |
|---|---|---|
| 推理底座 | revv 1.1.1 (内置 patched llama-server) | 内置针对 CUDA 与 Flash Attention 深度优化的 llama-server,原生支持高性能 Speculative Decoding 与动态 KV 压缩。 |
| 大脑模型 | Qwen 3.8 27B (UD-IQ3_XXS.gguf) |
阿里开源 270 亿参数密集模型。采用 Unsloth Dynamic + 重要度矩阵(imatrix)量化,权重仅 10.18 GiB,为 64K 上下文的 KV Cache 与 CUDA Buffer 留出关键空间。 |
| 显存压缩 | Q4 KV Cache (q4_0 / q4_0) + Flash Attention |
将注意力缓存从默认 Q8 压缩至 Q4,结合 Flash Attention,使 64K 超长上下文在 12GB 显存内安然驻留且不发生 OOM。 |
| 投机加速 | N-Gram Speculative (ngram-map-k4v) |
64K 极端显存下 MTP 辅助头会产生约 400MB 显存开销导致 OOM,而零额外模型权重的 N-Gram 几乎零显存开销即可提升有效吞吐。 |
| 通信协议 | OpenAI 兼容 API (/v1) |
监听 0.0.0.0:8080,可作为局域网内任意客户端(Cursor、Cline、Chatbox、Obsidian)的共享本地大脑。 |
flowchart LR
  User["开发者客户端 (Cursor / Continue / 本地脚本)"] -->|局域网 HTTP /v1 请求| API["OpenAI 兼容服务 (:8080)"]
  API --> Engine["revv 优化版 llama-server (Flash Attention ON)"]
  Engine --> Spec["N-Gram 推测解码 (ngram-map-k4v)"]
  Spec --> Model["Qwen 3.8 27B (UD-IQ3_XXS 权重: 10.18 GB)"]
  Model -.->|100% 显存驻留 · 0 CPU Offload| VRAM["RTX 3060 12GB 显存池"]
  Engine --> KV["Q4 KV Cache (65,536 Context: ~1.5 GB)"]
  KV -.->|显存严控| VRAM

  classDef highlight fill:#1e293b,stroke:#38bdf8,stroke-width:2px,color:#fff;
  class User,API,Engine,Spec,Model,VRAM,KV highlight;
⚡ 一、能达到的实测效果(真机硬核数据战报)
1. 核心实测指标与对比矩阵
| 评测维度 | 默认配置 (revv 8K 默认) | 传统 CPU 卸载 (Q4_K_M 方案) | 32K 稳定优化版 | 本文方案 (64K N-Gram) |
|---|---|---|---|---|
| 可用上下文 (Context) | 8,192 (太短) | 4,096 ~ 8,192 | 32,768 | 65,536 (64K 满血) |
| 持续生成速度 (Decode) | ~35.3 Tokens/s | 2.5 ~ 4.2 Tokens/s (掉内存卡死) | ~22.4 Tokens/s (最高 26 t/s) | ~22.4 Tokens/s (稳如磐石) |
| 首字吞吐 (Prefill) | 高 | < 50 Tokens/s | ~464 Tokens/s | ~418 Tokens/s |
| GPU 显存占用 (VRAM) | 11,521 MiB | 12,288 MiB (溢出至 DDR4) | 11,015 MiB | 11,729 MiB (剩余 ~176MB) |
| 长文本真机验收 | — | 不支持 | 25K 输入 100% PASS | 50K+ 输入 100% PASS |
| CPU 权重卸载 | 0 层 | 15~20 层进入内存 | 0 层 | 0 层 (100% 驻留 GPU) |
2. 真实显存剖析账本 (VRAM Profile)
- 静态模型权重驻留 (
UD-IQ3_XXS):10,424 MiB - 动态 KV Cache (64K 上下文 + Q4 压缩):~1,024 MiB
- CUDA 计算图与 Buffer 空间:~281 MiB
- 整卡总显存占用:11,729 MiB(在 12,288 MiB 物理显存中安全保留约 176 MiB 余量,零 CUDA OOM,零内存交换)。
3. 量化精度深度对比:IQ3 vs Q4 vs 完整模型到底损失多少?
很多开发者担心“3-bit 量化会不会严重变傻”。根据 llama.cpp 官方 I-Quants 基准评测、Unsloth 动态量化评测与开源社区在 20B~70B 模型上的多套测试集数据折算:
| 模型规格 | 权重体积 | 困惑度 (PPL 增量) | 综合能力保留率 | RTX 3060 12GB 运行实况 |
|---|---|---|---|---|
| 完整模型 (BF16/FP16) | ~54 GB | 0.00 (基准) | 100% | ❌ 显存直接爆仓,无法启动 |
| Q8_0 (近无损) | ~28 GB | +0.005 | > 99.8% | ❌ 绝大部分权重进内存,速度 < 1 t/s |
| Q4_K_M (标准 4-bit) | ~16.5 GB | +0.05 ~ +0.08 | ~98.5% | ⚠️ 约 5GB 权重溢出,速度骤降至 2~4 t/s,不可用 |
| UD-IQ3_XXS (本文推荐) | ~10.2 GB | +0.18 ~ +0.25 | ~94.5% – 96% | ✅ 100% 全 GPU 驻留,64K 上下文,跑出 ~22 t/s |
分任务体感损耗细化:
- 日常对话与事实检索(MMLU / 常识):损失 < 2%
27B 的底层参数容量极大,即使量化到 IQ3,语言连贯性、意图识别与事实性知识检索依然极度稳健,日常体感几乎无差异。 - 代码重构与工具调用(Agent / JSON):损失 ~4% – 6%
常用开发语言(Python/TS/Go/Shell)的代码补全、语法正确性依然优异。在极端复杂的长嵌套 JSON 场景下容错率略低于 Q4,但在 Prompt 中提供简单的示例(Few-Shot)即可完全解决。 - 高难度数学与逻辑链(GSM8k / MATH):损失 ~5% – 8%
浮点量化误差会在多步严密计算中累积,IQ3 偶发推理跳步,但在绝大部分日常业务和文档总结中影响极弱。 - 长文本大海捞针(Needle in a Haystack):0 损失
在 50,067 Tokens 长文本的首、中、尾 3 处关键标识符暗标检索中,命中召回率为 100%。
💡 核心结论:在 12GB 显存边界下,“全 GPU 驻留带来 95% 智商 + 64K 上下文 + 22 t/s 极速响应”,其真实综合生产力远超 “被迫 CPU 卸载换来 98.5% 智商 + 4K 上下文 + 2.5 t/s 幻灯片”。
🛠️ 二、极简准备工作(无需繁琐配置,10秒自查)
1. 硬件要求自查
- GPU:NVIDIA GeForce RTX 3060 12GB(GA106 核心,必须确认是 12GB 显存版,非 8GB 版)。
- CPU & 内存:主流 8 核 CPU(如 Ryzen 7 3700X 或更新),系统物理内存推荐 32GB。
- 操作系统:Ubuntu 22.04 / 24.04 LTS。
- 磁盘空间:预留 25GB 以上 NVMe 固态硬盘剩余空间。
2. 安装基础依赖与显卡驱动
sudo apt update && sudo apt install -y ubuntu-drivers-common git curl psmisc
检测并安装系统推荐驱动:
ubuntu-drivers devices
# 安装推荐驱动(本文实测为 595-open,请以你的机器推荐版本为准)
sudo apt install -y nvidia-driver-595-open
sudo reboot
重启后输入 nvidia-smi,确认显存显示为 12288 MiB 即可。
🚀 三、准确的安装步骤
路径 A:【强烈推荐】一键全自动部署脚本
为了规避自动化子进程中环境变量无法即时刷新导致的 command not found: revv 错误,以下脚本直接通过 python3 ./revv.py 驱动核心功能,实现最稳健的一键部署:
cat << 'EOF' > ~/setup_qwen38_64k.sh
#!/usr/bin/env bash
set -e

echo "=== 1. 正在克隆并编译 revv 推理底座 ==="
cd ~
if [ ! -d "revv" ]; then
  git clone https://github.com/mericanii-technologies/revv
  cd revv
  ./install.sh
else
  echo "revv 已存在,跳过克隆。"
  cd revv
fi

# 确保全局 PATH 写入配置
export PATH="$HOME/.revv/bin:$PATH"
grep -qxF 'export PATH="$HOME/.revv/bin:$PATH"' ~/.bashrc || echo 'export PATH="$HOME/.revv/bin:$PATH"' >> ~/.bashrc

echo "=== 2. 正在下载 Qwen 3.8 27B UD-IQ3_XXS 模型权重 ==="
# 直接调用仓库自带的 revv.py,彻底杜绝环境变量未生效问题
python3 ~/revv/revv.py get dense

echo "=== 3. 正在生成生产级 64K 启动脚本 ==="
cat << 'LAUNCH_EOF' > ~/run_qwen_64k.sh
#!/usr/bin/env bash
fuser -k -9 8080/tcp 2>/dev/null || true
sleep 1

exec "$HOME/.revv/bin/llama-server" \
  --model "$HOME/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf" \
  --host 0.0.0.0 \
  --port 8080 \
  --ctx-size 65536 \
  --parallel 1 \
  --n-gpu-layers 999 \
  --flash-attn on \
  --cache-type-k q4_0 \
  --cache-type-v q4_0 \
  --spec-type ngram-map-k4v \
  --spec-draft-n-max 2 \
  --reasoning off
LAUNCH_EOF
chmod +x ~/run_qwen_64k.sh

echo "=== 4. 正在注册并启动 systemd 开机自启服务 ==="
sudo tee /etc/systemd/system/qwen-64k.service > /dev/null << SERVICE_EOF
[Unit]
Description=Qwen3.8-27B 64K llama-server
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=$USER
WorkingDirectory=$HOME
ExecStart=$HOME/run_qwen_64k.sh
Restart=on-failure
RestartSec=5
LimitNOFILE=65535

[Install]
WantedBy=multi-user.target
SERVICE_EOF

sudo systemctl daemon-reload
sudo systemctl enable qwen-64k
sudo systemctl restart qwen-64k

echo "=== 部署完成!服务已在后台运行中 (端口: 8080) ==="
EOF

chmod +x ~/setup_qwen38_64k.sh && ~/setup_qwen38_64k.sh
路径 B:极客手动 4 步法(透明掌控细节)
第 1 步:安装 revv 底座
cd ~
git clone https://github.com/mericanii-technologies/revv
cd revv
./install.sh

# 将 bin 写入环境
echo 'export PATH="$HOME/.revv/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc

# 运行硬件诊断(在仓库目录下直接调用 python3 确保执行无误)
python3 ./revv.py doctor
💡 确认输出末尾显示
tier: 12GB (certified)且状态为Ready。
第 2 步:下载专属量化模型
cd ~/revv
python3 ./revv.py get dense
# 文件保存在 ~/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf(约 10.18 GiB)
第 3 步:编写 64K 极限启动脚本
创建 ~/run_qwen_64k.sh:
cat << 'EOF' > ~/run_qwen_64k.sh
#!/usr/bin/env bash
fuser -k -9 8080/tcp 2>/dev/null || true
sleep 1

exec "$HOME/.revv/bin/llama-server" \
  --model "$HOME/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf" \
  --host 0.0.0.0 \
  --port 8080 \
  --ctx-size 65536 \
  --parallel 1 \
  --n-gpu-layers 999 \
  --flash-attn on \
  --cache-type-k q4_0 \
  --cache-type-v q4_0 \
  --spec-type ngram-map-k4v \
  --spec-draft-n-max 2 \
  --reasoning off
EOF

chmod +x ~/run_qwen_64k.sh
启动参数关键解析:
–--ctx-size 65536:启用满血 64K 上下文窗口;
–--cache-type-k q4_0 --cache-type-v q4_0:将 KV 缓存压至 4-bit,释放出数 GB 宝贵显存空间;
–--flash-attn on:启用注意力显存优化计算,避免长文本显存二次爆炸;
–--spec-type ngram-map-k4v --spec-draft-n-max 2:启用 N-Gram 投机加速,不占额外模型显存的同时提升出字速度。
第 4 步:注册 systemd 守护服务
sudo tee /etc/systemd/system/qwen-64k.service > /dev/null << EOF
[Unit]
Description=Qwen3.8-27B 64K llama-server
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=$USER
WorkingDirectory=$HOME
ExecStart=$HOME/run_qwen_64k.sh
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable qwen-64k
sudo systemctl start qwen-64k
🧪 四、最终的测试与验收(5 大硬核测试)
测试 1:检查服务健康与显存状态
# 检查 systemd 服务状态
sudo systemctl status qwen-64k

# 确认显存稳定在 11.7GB 左右(100% 全 GPU 驻留)
nvidia-smi
测试 2:验证 OpenAI 兼容 /v1 连通性
curl http://127.0.0.1:8080/v1/models
预期响应:返回包含 Qwen3.8-27B-UD-IQ3_XXS.gguf 的标准 JSON 数据。
测试 3:对话端点基准测速
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-27b",
    "messages": [{"role": "user", "content": "请用一句话解释什么是大模型的 KV Cache 压缩?"}],
    "temperature": 0.7
  }'
实测表现:首字延迟(TTFT)迅速,平均 Decode 速度达到 ~22.4 Tokens/s。
测试 4:50K+ Tokens 极限长文本“大海捞针”实测
在 50,067 Tokens 输入中分别在头部、中部、尾部埋入暗标:
– BEGIN_KEY=583721
– MIDDLE_KEY=914625
– END_KEY=327194
要求模型按顺序提取这三个数字。
验收结果:模型准确输出 583721 914625 327194。全程 Prompt Prefill ~412.9 t/s,0 截断、0 报错、0 OOM!
测试 5:局域网接入主流开发工具(Cursor / Cline / Obsidian)
配置局域网防火墙允许访问:
sudo ufw allow from 192.168.0.0/24 to any port 8080 proto tcp
在同局域网客户端中配置:
* Base URL: http://<你的-Ubuntu-IP>:8080/v1
* API Key: local
* Model: Qwen3.8-27B-UD-IQ3_XXS.gguf(或任意自定义别名)
❓ 五、高频疑问与极客排错手册 (FAQ)
Q1: 运行命令提示 command not found: revv 是怎么回事?
答:这是因为当前终端会话未重新加载环境变量。有两种解决方法:
1. 立即加载环境:source ~/.bashrc;
2. 直接进入仓库目录调用:cd ~/revv && python3 ./revv.py <命令>(如 python3 ./revv.py doctor 或 python3 ./revv.py get dense),效果完全一致。
Q2: 为什么不能直接跑常见的 Q4_K_M?
答:Qwen 3.8 27B 的 Q4 权重文件一般在 16.5GB 左右。RTX 3060 只有 12GB 显存,至少有 5GB 以上权重必须卸载到系统 DDR4 内存中,这会导致 Decode 速度从 22 t/s 暴跌至 2~4 t/s。全 GPU 驻留是维持高吞吐的第一红线。
Q3: 降低到 Q4 KV Cache 会损害长文本理解能力吗?
答:几乎没有影响。实践证明,KV Cache 存在极高的注意力冗余,使用 q4_0 压缩后,在 50K 级别的长文本 Needle 检索中准确率依然保持 100%,却能将上下文显存消耗减半。
Q4: 为什么 64K 下不能开启 MTP(Multi-Token Prediction)?
答:在 64K 上下文下,主模型 + Q4 KV 已占用约 11.7GB 显存。MTP 推测辅助头需要额外约 400MB 显存上下文空间,会直接触发 cudaMalloc failed: out of memory。因此 64K 下采用零显存代价的 N-Gram 方案是最优解。
Q5: 显存只剩下 176MB 会不会不稳定?
答:llama-server 在启动时已预先分配了静态 KV Cache 和计算图,运行期间不会发生持续显存内存泄漏。但此配置显存裕度极小,建议该显卡专用于模型推理,避免同时运行桌面 3D 渲染或 ComfyUI 等生图任务。
Q6: 如何确认没有发生 CPU 权重卸载?
答:运行 watch -n 1 nvidia-smi。在连续生成时,如果 GPU 利用率持续处于 95%~100%,且整卡功耗在 160W~170W 满载区间,说明 64 层网络 100% 在 GPU 内部计算。
🔧 六、进阶选读:三套硬件场景专属启动模版
根据日常不同业务偏好,可直接替换 ~/run_qwen_64k.sh 中的启动参数:
模版 A:8K 极速出字型(适合日常快速对话 / 单文件代码补全)
- 特点:速度拉满至 ~35 Tokens/s,显存富余约 760MB。
~/.revv/bin/llama-server \
  --model ~/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf \
  --host 0.0.0.0 --port 8080 \
  --ctx-size 8192 --parallel 1 --n-gpu-layers 999 \
  --flash-attn on --reasoning off
模版 B:32K 稳妥生产型(推荐主力日常使用)
- 特点:速度保持 ~22.4 Tokens/s,显存剩余约 900MB,支持 25K+ 长输入,容错率最高。
~/.revv/bin/llama-server \
  --model ~/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf \
  --host 0.0.0.0 --port 8080 \
  --ctx-size 32768 --parallel 1 --n-gpu-layers 999 \
  --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --reasoning off
模版 C:64K 极限长文本型(本教程生产默认)
- 特点:解锁 65,536 超长上下文,配合 N-Gram 加速实现 ~22.4 Tokens/s,适合多文件扫描、架构重构与长篇文档 RAG。
~/.revv/bin/llama-server \
  --model ~/.revv/models/Qwen3.8-27B-UD-IQ3_XXS.gguf \
  --host 0.0.0.0 --port 8080 \
  --ctx-size 65536 --parallel 1 --n-gpu-layers 999 \
  --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 \
  --spec-type ngram-map-k4v --spec-draft-n-max 2 --reasoning off
生产运维常用命令速查
| 操作需求 | 终端命令 |
|---|---|
| 实时日志跟踪 | journalctl -u qwen-64k -f |
| 实时显存与功率监控 | watch -n 1 nvidia-smi |
| 重启模型服务 | sudo systemctl restart qwen-64k |
| 停止服务释放显存 | sudo systemctl stop qwen-64k |
| 强制释放端口 | fuser -k -9 8080/tcp |
🏁 总结:从“消费 Token”迈向“算力自治”
通过本套方案,一张二手市场上千元出头的 RTX 3060 12GB 老显卡,成功突破了 27B 大模型与 64K 上下文的显存物理壁垒。
我们换来的不仅是相比默认 8K 整整 8 倍的上下文吞吐空间,更获得了一个永久免费、无网络延迟、零隐私外泄风险、全天候 7×24 小时随叫随到的私有大模型大脑。
🛠️ 玩客笔记开发者与算力工具箱
在本地部署大模型、拉取 Hugging Face 权重或调用海外 API 时,推荐搭配以下高性价比工具(个人长期自用实测):
- 🌐 全局海外高速节点:高质量海外代理直达(千兆纯净稳定带宽,模型下载与 GitHub 同步不限速);
- 🏠 海外原生住宅 IP:IPRoyal 住宅代理(真实纯净家宽住宅 IP,对各类 AI 平台与自动化风控友好);
- 🔑 开发者海外环境通道:全能海外账号专营店(免繁琐外币卡与复杂配置,一键获取专属海外开发者环境);
- ☁️ 阿里云百炼 · 大模型与算力特惠(最高直省 55%):阿里云百炼专属优惠通道(专属邀请码:
sgy1lcae,通义千问等大模型 Token 节省计划最高省 55%,涵盖 GPU/ECS/OSS 等 120+ 款云产品)。
* 注:部分链接包含专属合作/返利,感谢您对频道独立开发与内容更新的支持!
About The Author