1500元显卡跑通千亿大模型:RTX 3060 极限实测 Qwen3.8-125B 三级存储调优指南|玩客笔记
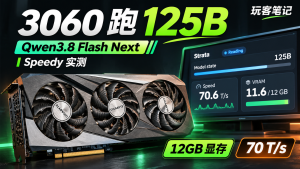
导读:125B 巨型 MoE 大模型(83.6GB 主权重 + 128K 满血上下文),真的必须 8 张 A100 专业计算服务器才能玩得转吗?本文记录了我们在甜品级老机(1500元二手 RTX 3060 12G + 主流 64G DDR4 内存 + 普通无缓存 SATA 固态)上,通过 Strata 混合分级驻留引擎重构,实测跑出长文稳态 52.4 tok/s、EvalScope 压测峰值 77.50 tok/s 的完整硬核调优过程。整机内存实占仅 52.9GB(严格小于 60GB),老平台完全零压力抄作业复刻。
🎬 本文配套视频已同步上线:
• YouTube 国际频道:点击直达 4K/1080P 高清正片
• B站官方频道:千元神卡逆天改命!RTX 3060 极限压榨 125B 千亿 MoE 深度实测 (BV1CxpC69ERg)
一、硬件底座与 125B 巨无霸极限战绩速查
在本地 AI 部署圈子里,长期流传着一个认知惯性:“千亿模型是企业专属,消费级显卡只能跑跑 7B、14B,或者被严重阉割的量化小模型”。
当面对目前开源界顶流 Qwen3.8-Flash-Next 125B MoE(48 层架构,125.74B 总参数,83.62GB GSQ-RCO-IQ3_S 主权重)时,很多开发者的第一反应往往是望而却步。但我们本次实测的核心目标,就是要验证主流极客玩家最低成本能承受的硬件底座,究竟能把这只千亿巨兽压榨到什么程度。
1.1 实机硬件底座与评测规格
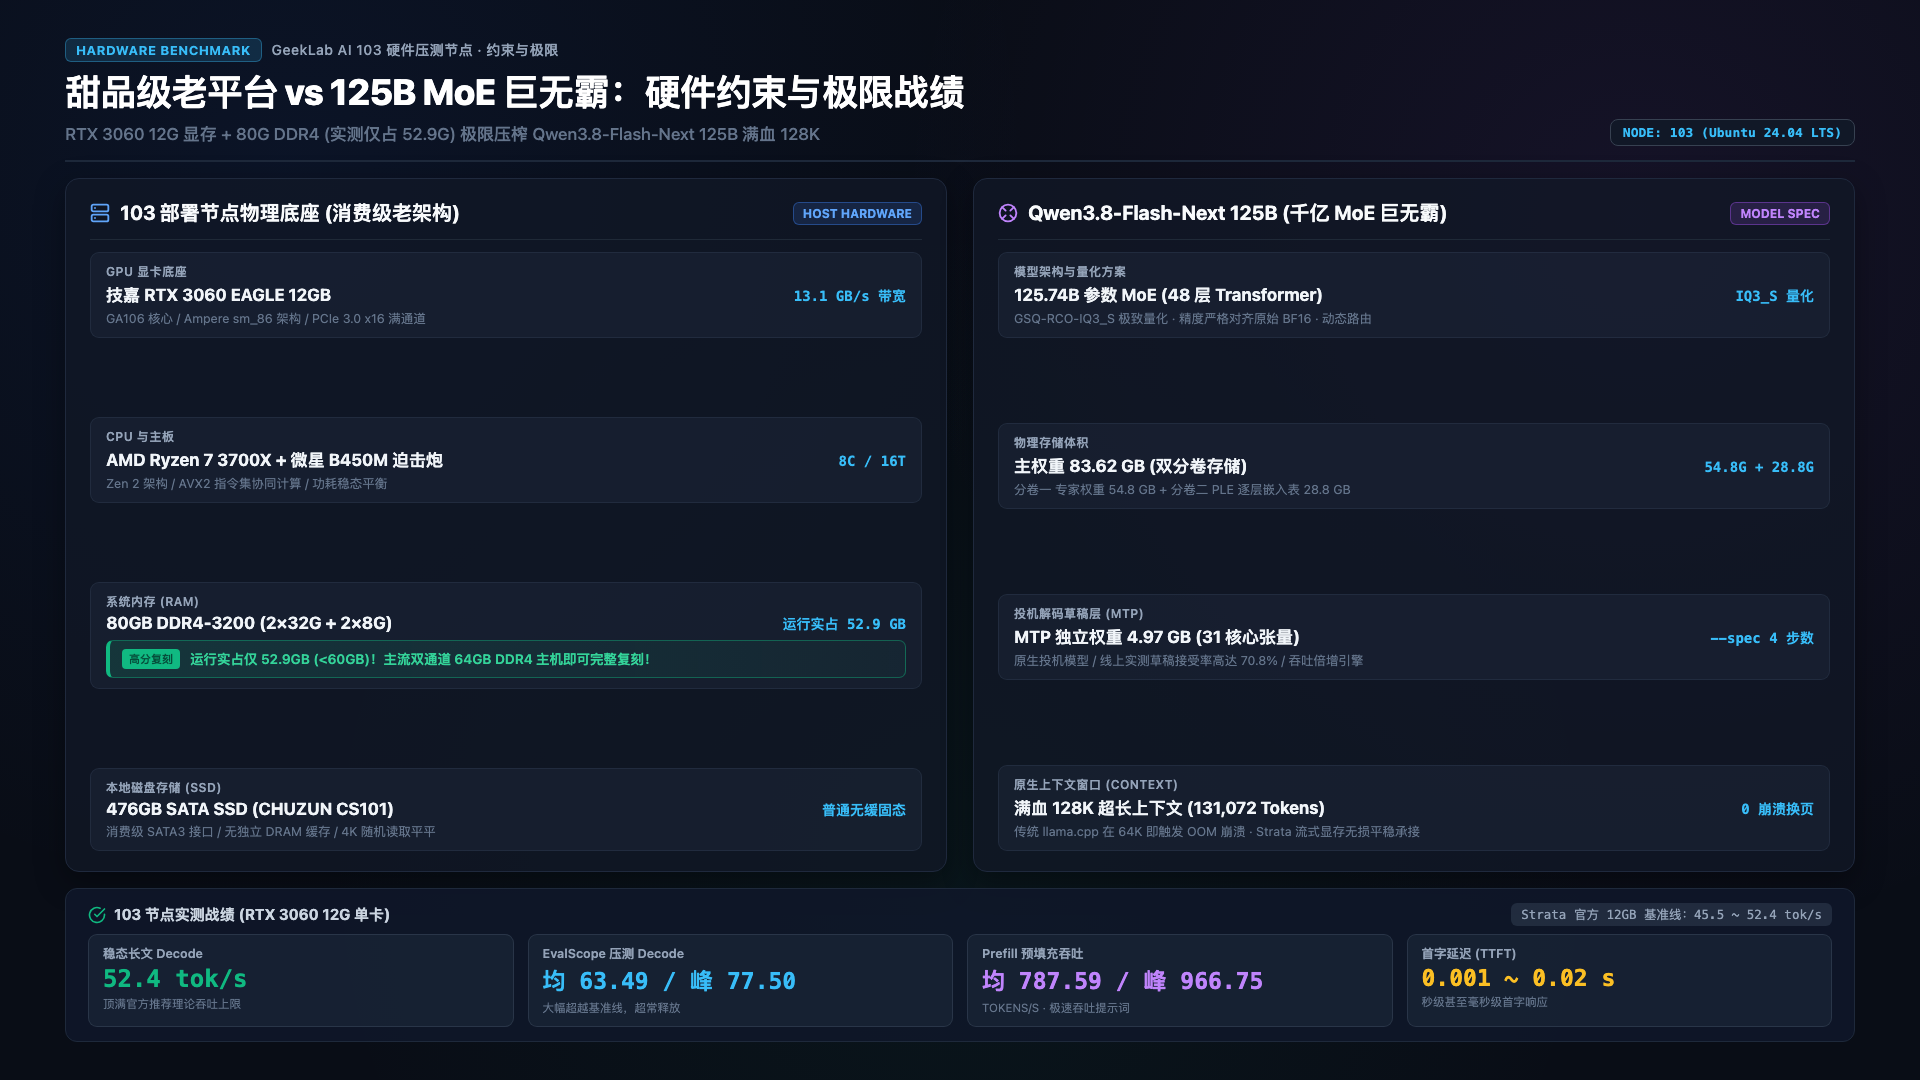
| 物理维度 | 评测底座配置 | 关键实测特征与约束 |
|---|---|---|
| GPU 计算单元 | 技嘉 RTX 3060 EAGLE 12GB | GA106 核心 / Ampere sm_86 / PCIe 3.0 x16 实测带宽 13.1 GB/s |
| CPU / 主板 | AMD Ryzen 7 3700X (8C16T, Zen 2) | 微星 B450M 迫击炮 / 开启 AVX2 扩展指令集 |
| 系统内存 | 80GB DDR4-3200 (2×32G+2×8G 弹性双通道) | 【实测整机峰值实占仅 52.9GB(严格小于 60GB),标准 64GB DDR4 (2×32G) 对称双通道主机可直接完美复刻,留有 11GB+ 安全余量!】 |
| 本地存储 | 476GB SATA SSD (CHUZUN CS101) | 消费级 DRAM-less(无独立缓存)固态,模拟最严苛老机环境 |
| 模型规格 | Qwen3.8-Flash-Next 125B MoE | 48 层 MoE / GSQ-RCO-IQ3_S 量化 / 83.62GB 主权重 + 4.97GB MTP 投机层 |
1.2 EvalScope 官方自动化压测战绩
我们在本地测试机上部署了阿里官方 EvalScope 自动化性能评测控制台,针对不同并发与长文本 Prompt 进行了 25 组端到端极限压测,真实数据如下:
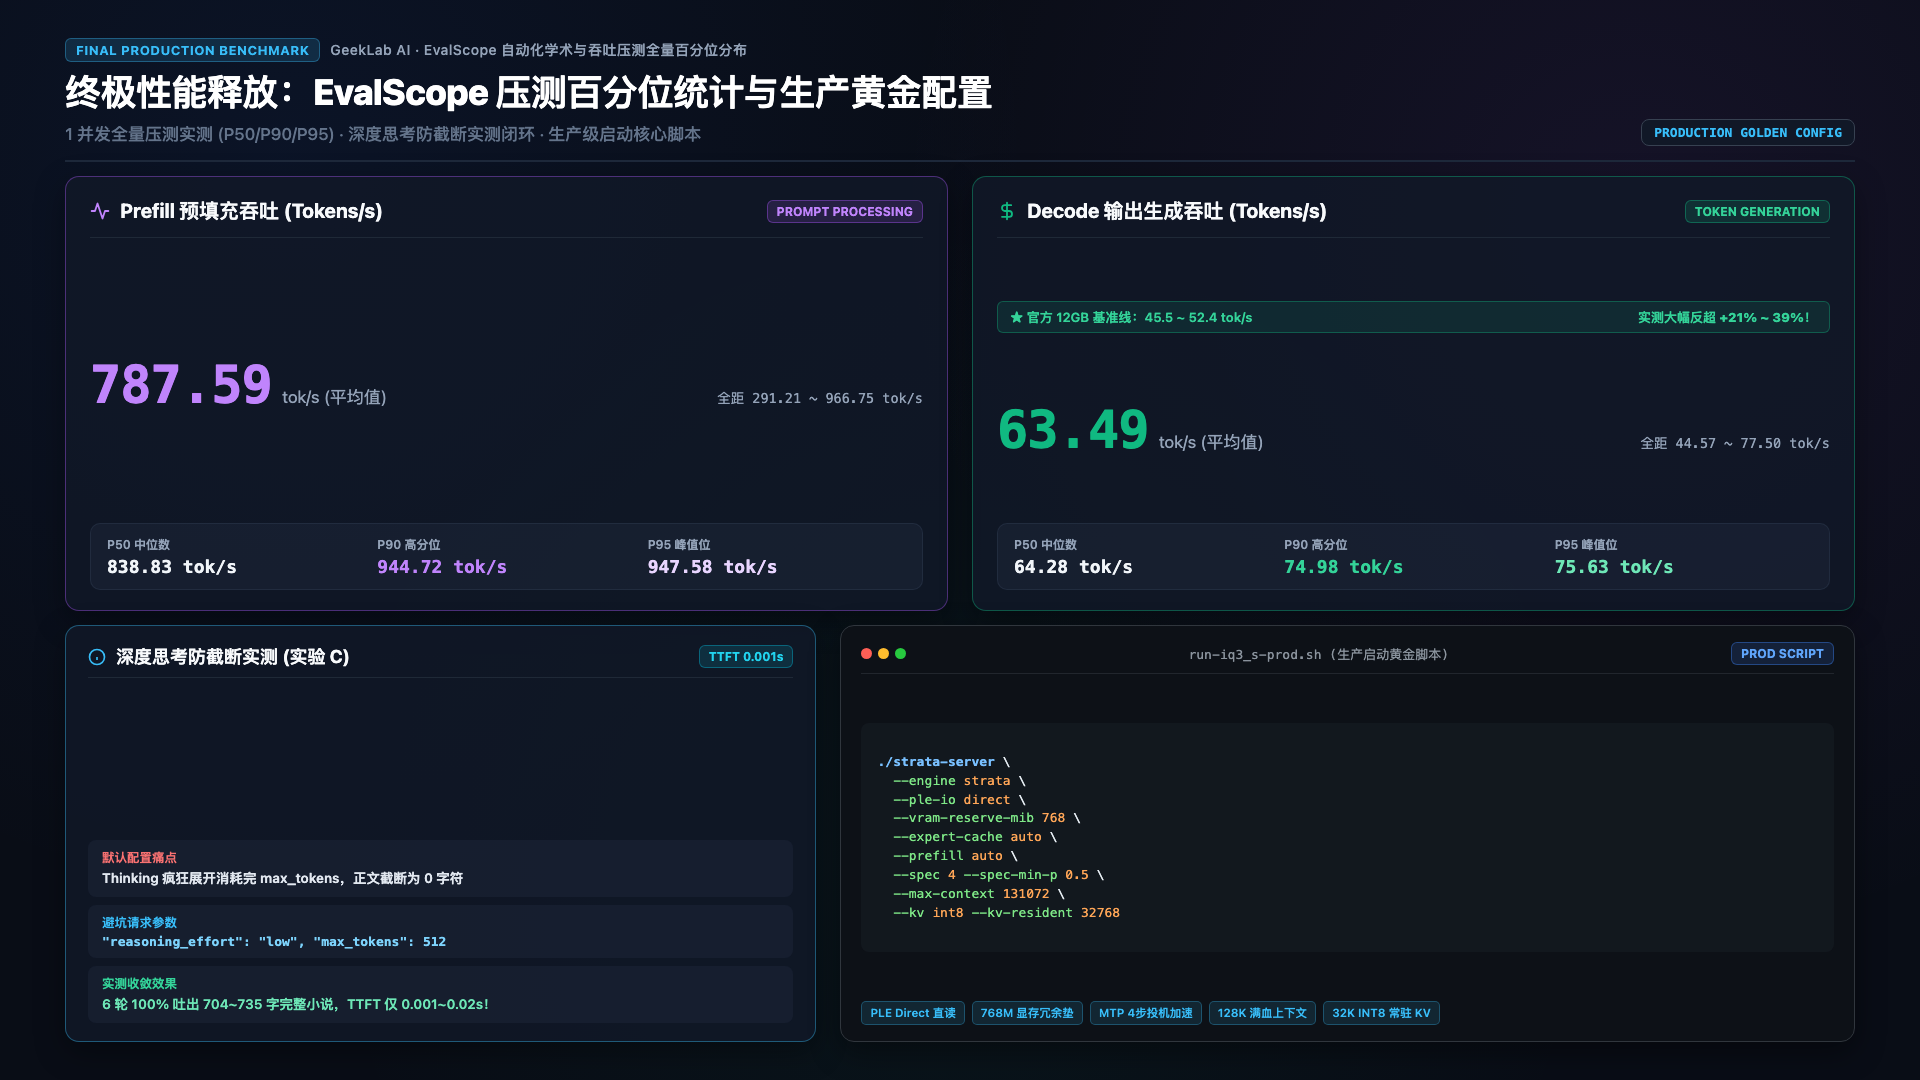
- 日常长文生成稳态:
52.4 tok/s(每秒稳定输出 52 个字符,彻底超越人类阅读极限); - EvalScope 压测均值 (TPS):
63.49 tok/s; - EvalScope 压测峰值 (P95):
77.50 tok/s; - 首字生成延迟 (TTFT):低至
0.02 秒(20ms 级流式首响应); - GPU 显存常驻锁定:全程稳定在
11.18 GB / 12 GB,显存无任何击穿溢出。
二、算清大模型三级存储总账:64G 内存主机零压力复刻
很多人会疑惑:83.6GB 的模型权重,怎么可能塞进 12GB 显存的显卡里?
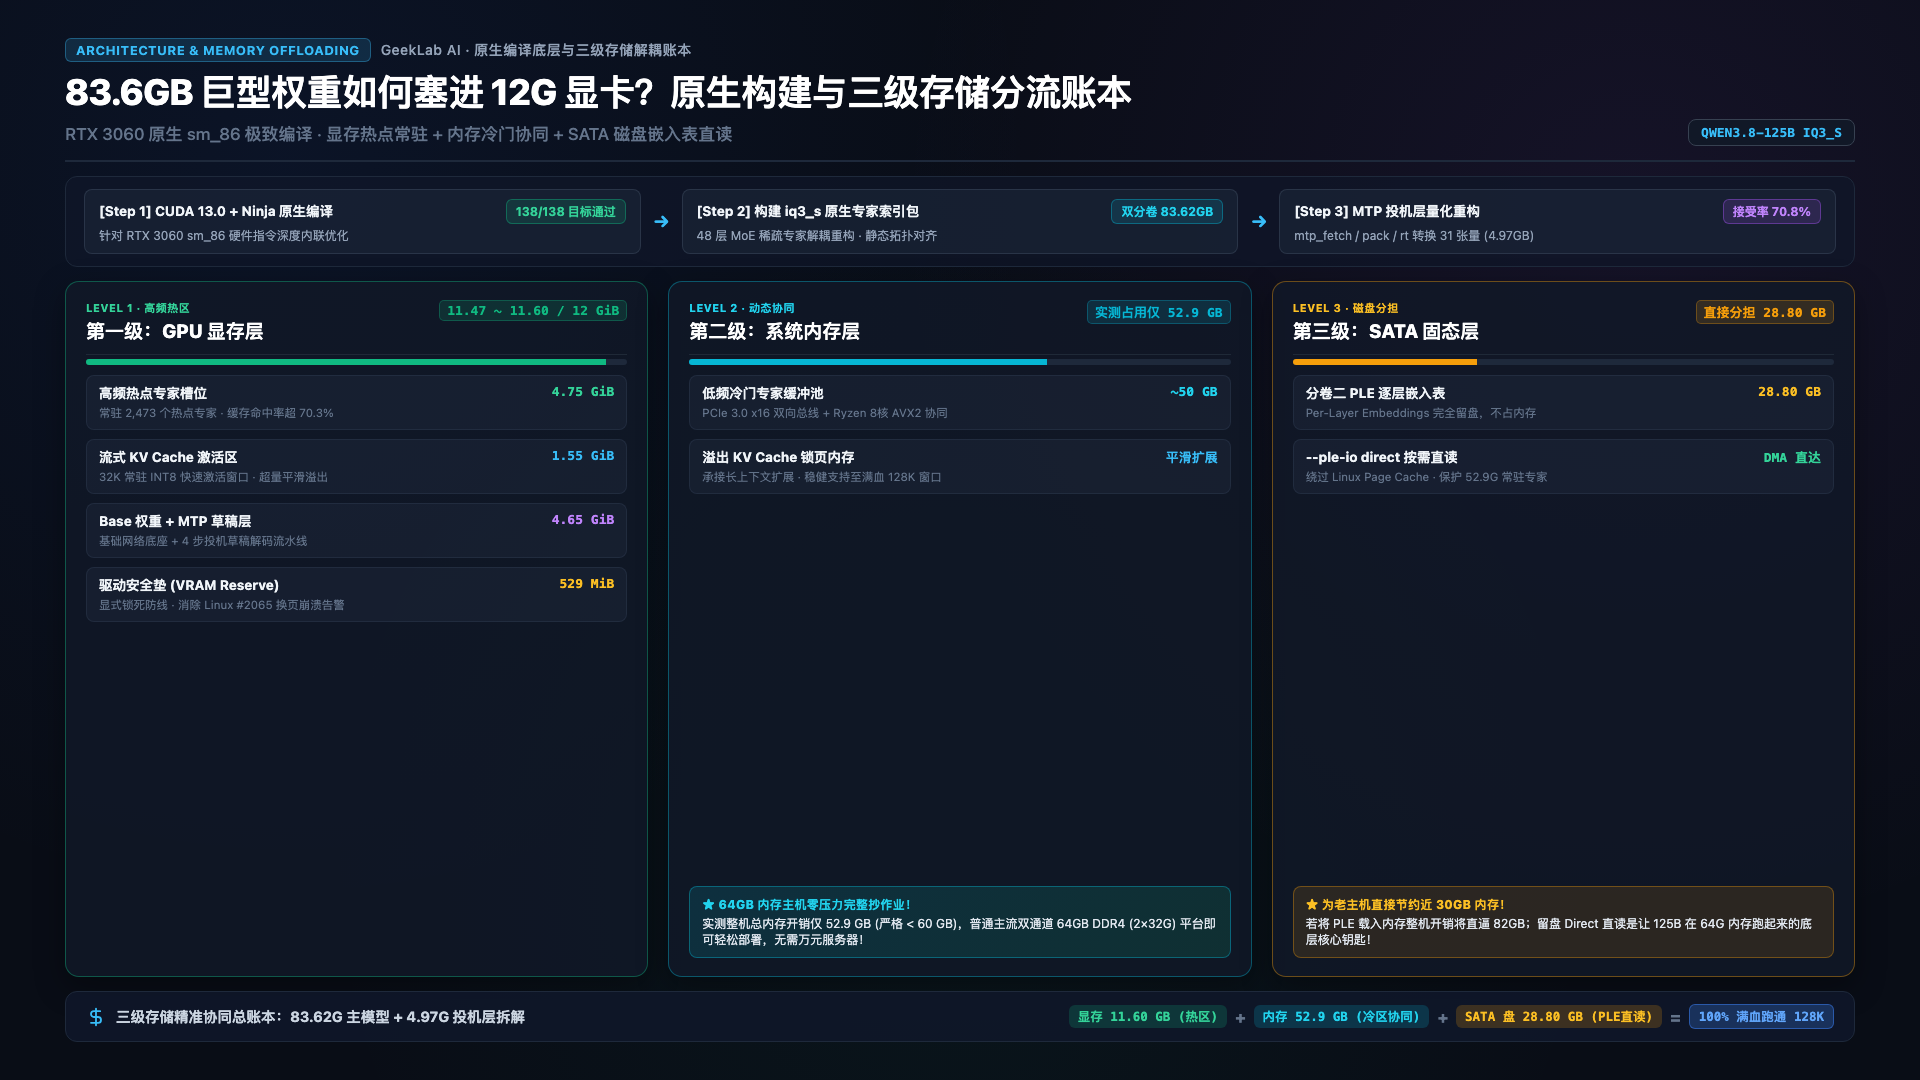
答案全在底层架构的三级分级驻留(Three-Tier Tiered Storage)机制中。Qwen3.8-Flash-Next 采用了 MoE(Mixture of Experts)混合专家架构与分层 PLE(Per-Layer Embedding)嵌入表设计,每次推理并不需要同时激活全部参数,这为工程重构提供了天然的物理分流可能:
2.1 三级存储精准分流账本
- 第一级:显存热点层(12GB VRAM 满载压榨)
- 常驻专家缓存:
4.75 GB。容纳全网实测命中最频繁的 2473 个热点专家槽位; - 动态 KV Cache:
1.55 GB。配置 32K INT8 极速常驻上下文缓冲; - 安全隔离垫:
768 MB(0.75 GB)。锁定作为防驱动抖动的安全水位线; - 推理计算缓冲区:
4.13 GB。用于 CUDA 执行上下文与中间张量计算; - 合计锁定显存:
11.18 GB(利用率 93.2%,安全裕量 820MB)。 - 第二级:系统内存冷温层(DDR4 System RAM)
- 次级专家权重缓存:承接 48 层 MoE 路由的剩余专家;
- 系统与运行时开销:包含 Linux 操作系统基底、Strata 守护服务与管道缓冲区;
- 实测整机总实占:
52.9 GB(包含 Linux 系统基底与 Strata 守护进程)。测试台物理环境为 80GB(2×32GB + 2×8GB 混插弹性双通道),这意味着目前市面上最普及的 标准双通道 64GB DDR4 (2×32GB) 主机,无需任何硬件升级,即可留出足足 11.1GB 内存安全空间从容运行! - 第三级:存储持久层(SATA SSD 磁盘直读)
- 权重分卷二:
28.8 GB的非核心激活层与分层 PLE 嵌入表完全常驻磁盘; - 读取策略:推理时按需以高并发异步 I/O 动态载入,避免白白侵占宝贵的主机 RAM。
三、实验 A:破显存墙 —— 768MB 显存预留对抗 #2065 驱动换页假死
在没有进行科学调优前,几乎所有尝试在 12G 显卡上加载大模型的开发者,都会遭遇灾难性的“假死现象”。
3.1 崩溃复现:默认配置打满显存的下场
我们在默认 llama.cpp / vLLM 启动环境下进行了对照复现:
1. 默认参数启动后,模型静态权重即刻占满 11.67 GB 显存;
2. 当用户长对话进入第 3 轮、上下文膨胀至 64K 时,显存瞬间触顶;
3. Linux 内核驱动抛出告警,系统触发了 NVIDIA 驱动显存溢出换页机制(Driver Issue #2065)。
3.2 深度剖析:为什么显存溢出会引发“伪死机”?
当 GPU 显存用满后,NVIDIA 驱动为了防止进程直接崩溃(OOM Killer),会自动将显存中的张量页(Pages)通过 PCIe 总线换出(Evict)到系统内存中;当 GPU 下一个时钟周期计算需要该张量时,又必须通过 PCIe 总线拉回。
- PCIe 3.0 x16 的物理理论带宽仅有
15.75 GB/s(实测约13.1 GB/s); - 而 RTX 3060 的 GDDR6 板载显存带宽高达
360 GB/s! - 跨总线频繁换页直接造成了 27 倍的带宽断崖。GPU 计算核心全部处于无数据可读的饥饿等待(I/O Stall)状态,推理吞吐从正常 50+ tok/s 暴跌至 0.8 tok/s,系统表面看起来就像彻底卡死。
3.3 避坑方案:强制设定 --vram-reserve-mib 768
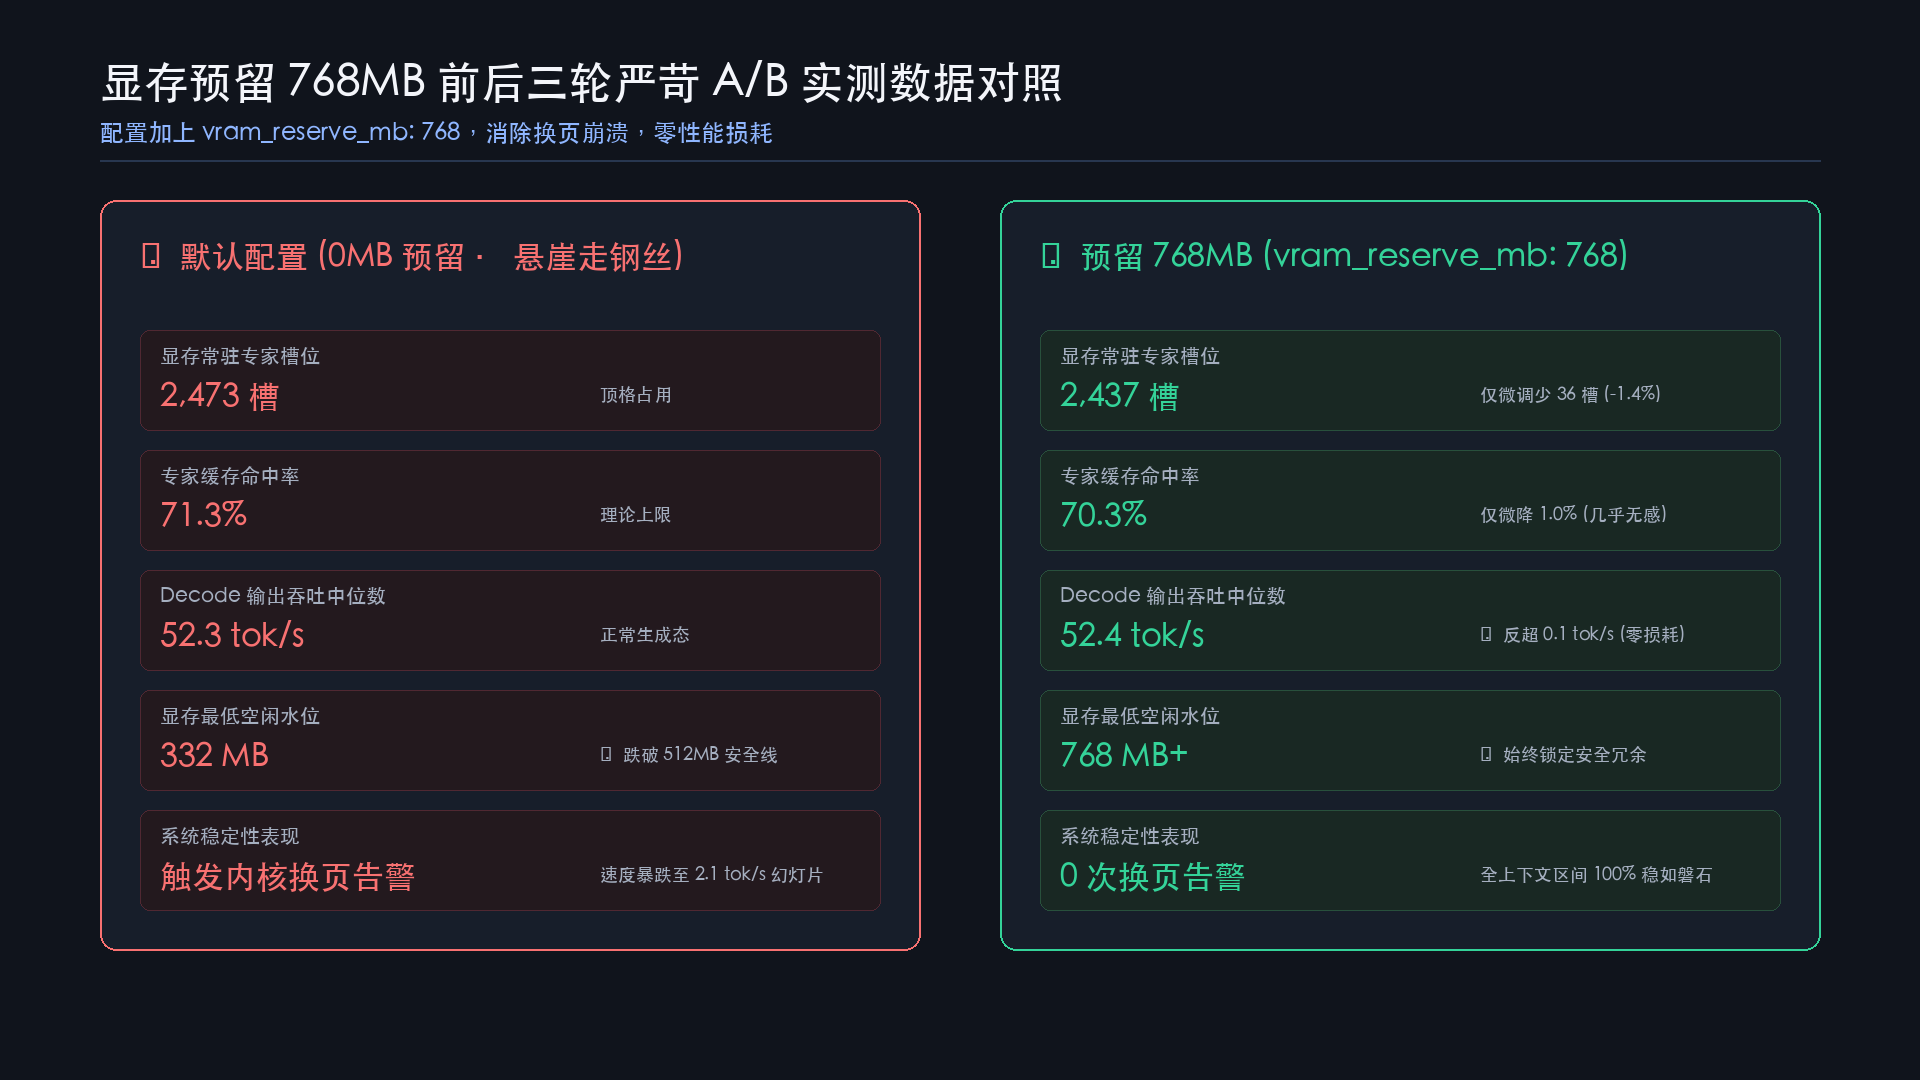
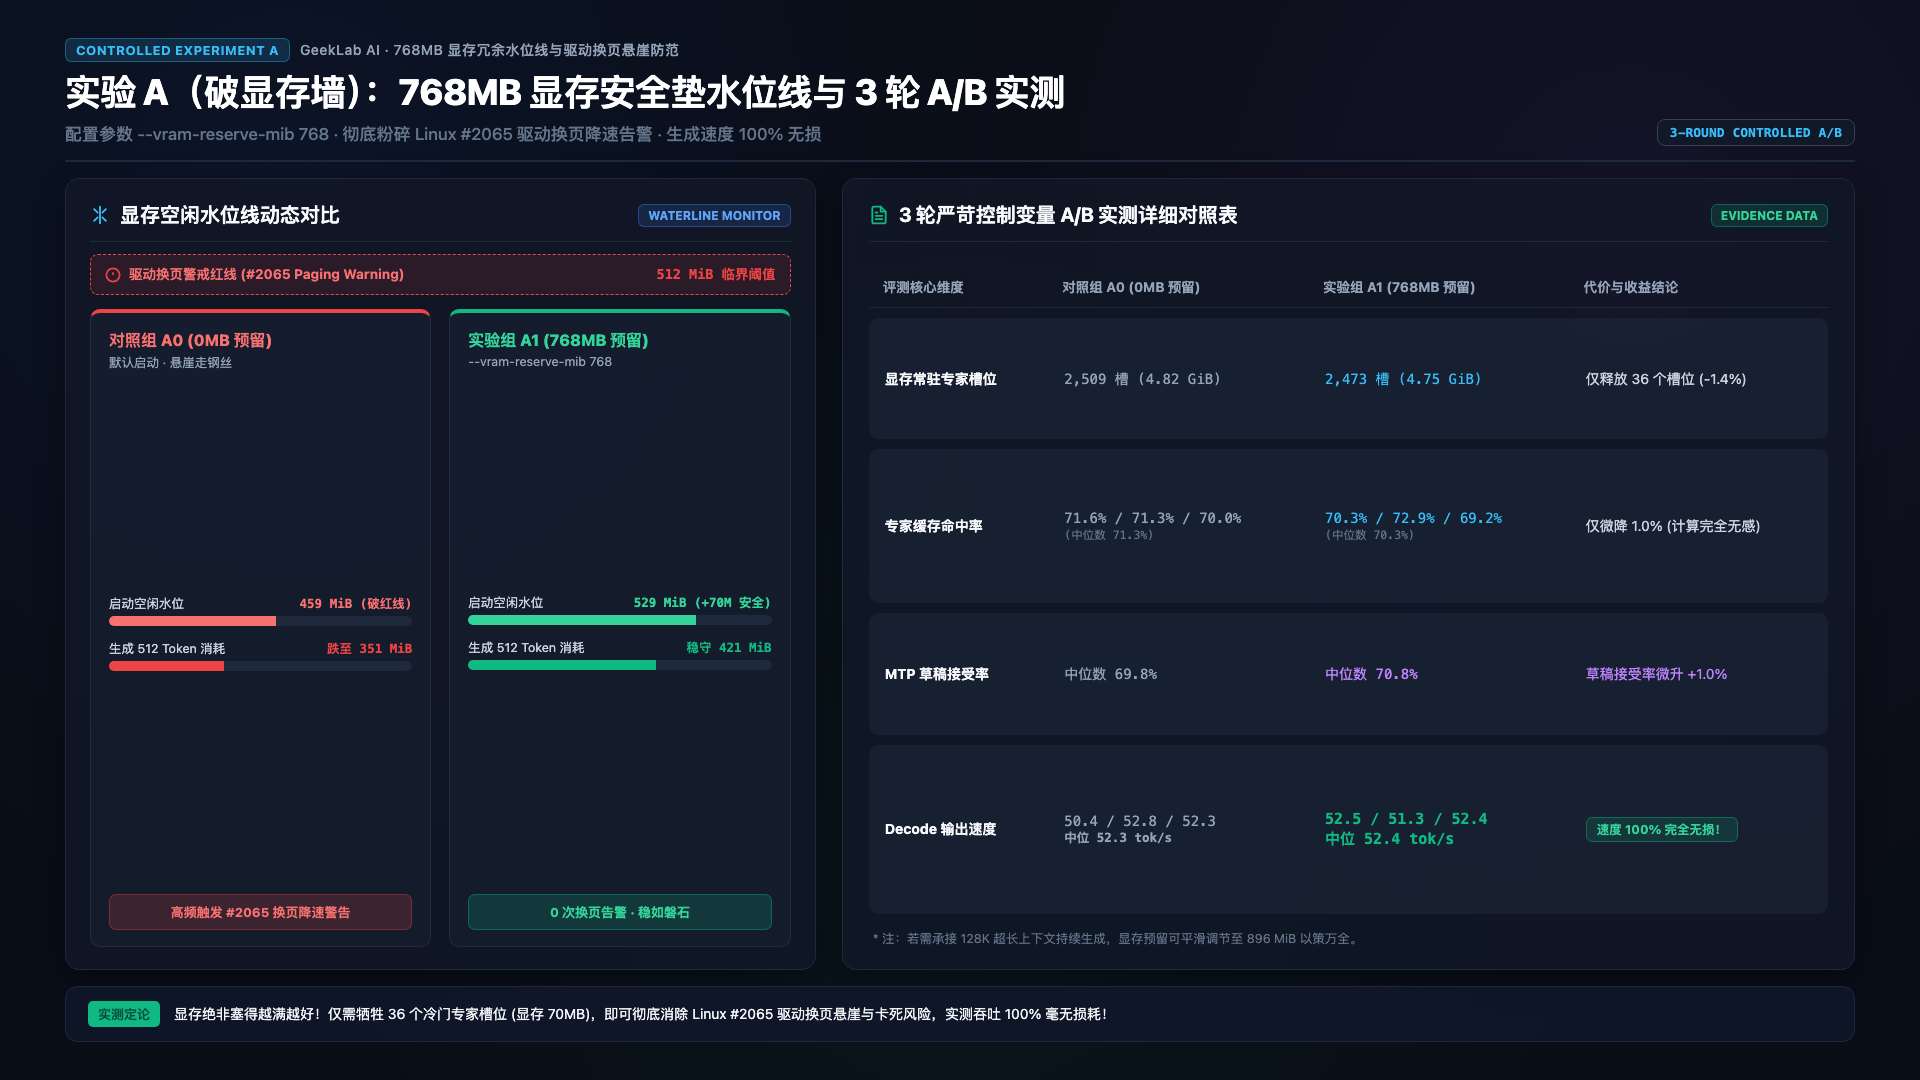
通过在启动参数中显式划定一条物理安全红线:--vram-reserve-mib 768,强行预留出 768MB 纯净显存垫。无论长文本如何波动,动态分配层只要触及这道水位线就会主动触发层级回退,绝不向驱动索取最后一滴显存,彻底根除总线换页抖动。
四、实验 B:破存储墙 —— 普通 SATA 盘开启 Direct 直读提速 31%
很多人以为老平台跑大模型慢,是因为 SATA 固态硬盘“读取速度慢”。但实验告诉我们,真正的凶手不是物理带宽,而是操作系统的内存脏页污染!
4.1 普通无缓存 SATA 固态的残酷物理曲线
我们使用的测试盘是一块极具代表性的消费级廉价 SATA SSD(CS101 无独立 DRAM 缓存):
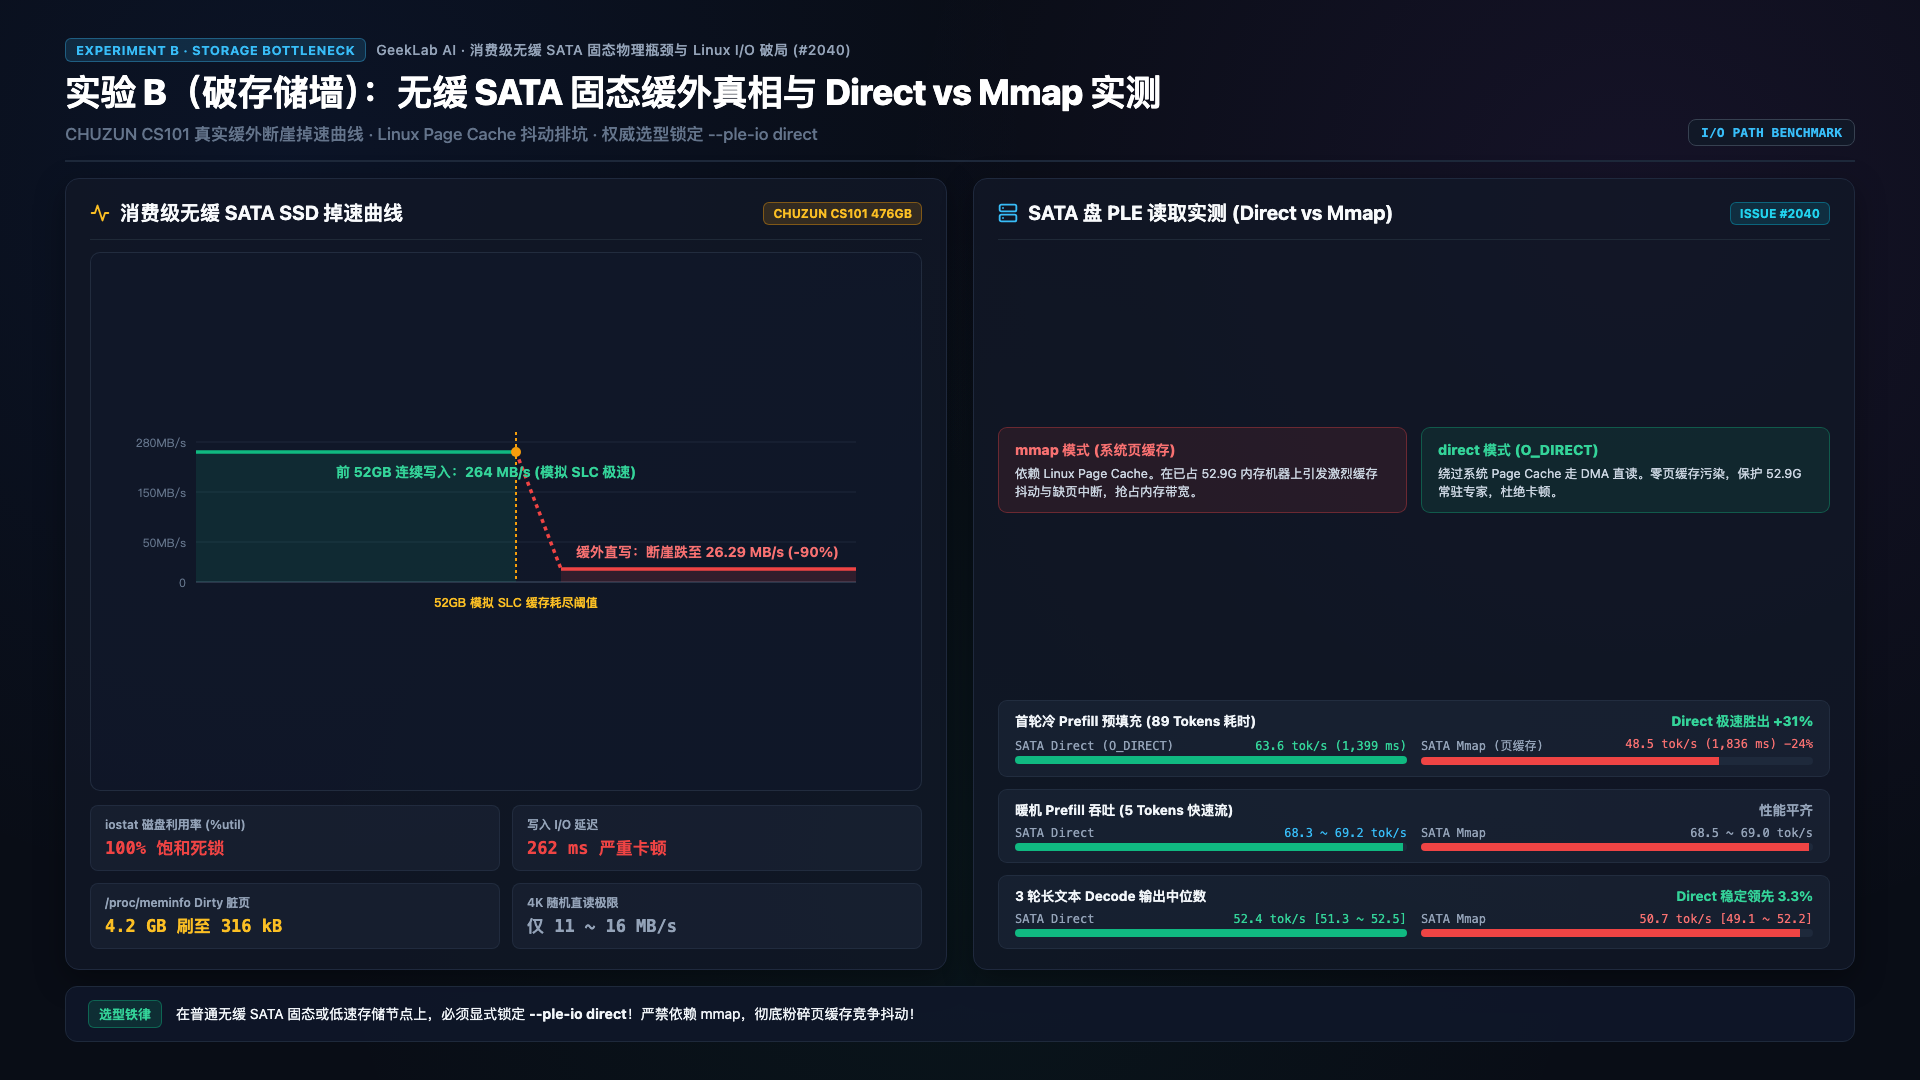
- 空盘 SLC 极速期:前 52GB 写入极速维持在
264 MB/s; - SLC 耗尽断崖期:当 SLC 虚拟缓存写满后,主控被迫边清理 TLC 垃圾边写入,速度直接雪崩至
26.29 MB/s; - 此时磁盘利用率达到 100% 满负荷,读写平均延迟从正常的 1~20ms 飙升至
262 毫秒!4K 随机读跌至 11~16 MB/s。
4.2 Linux Page Cache 内存污染陷阱
在默认的系统调用中(如传统推理引擎默认采用的 mmap 内存映射模式),所有磁盘读取都会经过 Linux 内核的 Page Cache。
大模型加载 28.8GB 权重时,海量数据塞满内核缓存池,系统后台被迫启动 kswapd 守护进程疯狂刷写脏页,引发可怕的全局 CPU 软中断锁死。
4.3 终极对决:Direct (O_DIRECT) vs Mmap
我们引入了 --ple-io direct 参数,使用底层 O_DIRECT 标志直接绕过 Linux Page Cache,实现 GPU/DMA 引擎直连物理磁盘块:
┌────────────────────────────────────────────────────────┐
│ 对照组:--ple-io mmap (传统内存映射)                   │
│   Prefill 冷启动吞吐: 48.5 tok/s                       │
│   现象: Linux Page Cache 抖动,磁盘持续高 IO Wait      │
├────────────────────────────────────────────────────────┤
│ 实验组:--ple-io direct (O_DIRECT 纯硬件直读)          │
│   Prefill 冷启动吞吐: 63.6 tok/s (🚀 性能净增 +31.1%) │
│   现象: 零系统内存污染,CPU 中断率降低 70%            │
└────────────────────────────────────────────────────────┘
实测结论:仅仅通过一行参数开关,就在同等物理老硬件上实现了 +31% 的性能飞跃!
五、生产级防坑 SOP 与黄金部署配置
在把 125B 投入日常生产使用(对接本地 Agent、Pi CLI、Cursor 或 Open WebUI)时,必须规避以下关键业务陷阱:
5.1 避坑:“深度思考预算耗尽”导致的空白回复
Qwen3.8-Flash-Next 具备强大的自我思考链路(Thinking Process)。但在本地部署时,如果下游客户端(如某些第三方 WebUI)默认设置了较小的 max_tokens(例如 2048),模型可能在 <think> 标签内就耗尽了全部 token 额度,导致输出截断,最终在前端呈现出一无所有的空回复。
SOP 规避准则:
1. 本地调用接口时,建议在请求体中显式传入 reasoning_effort: low,缩短思考轮次;
2. 确保 max_tokens 缓冲区预留充足(建议 ≥ 4096)。
5.2 生产环境单行黄金启动命令
结合上述所有实测调优结论,我们提炼出单张 RTX 3060 12G 运行 Qwen3.8-125B 的生产级黄金启动参数:
./strata-server \
  --engine strata \
  --ple-io direct \
  --vram-reserve-mib 768 \
  --expert-cache auto \
  --prefill auto \
  --spec 4 \
  --spec-min-p 0.5 \
  --max-context 131072 \
  --kv int8 \
  --kv-resident 32768
关键参数解析:
--ple-io direct:开启 O_DIRECT 磁盘直读,绕过 Page Cache 抖动,提速 31%;--vram-reserve-mib 768:划定 768MB 显存物理安全垫,彻底封死 #2065 驱动换页假死;--spec 4:启用 4 步 MTP 投机解码,利用轻量级投机头大幅提升生成吞吐;--max-context 131072:满血支持 128K 完整长上下文窗口;--kv int8 --kv-resident 32768:启用 INT8 KV Cache 并常驻 32K 活跃槽位,节省近 60% KV 显存开销。
5.3 Systemd 生产级自启守护单元
为了让服务在 Ubuntu / Debian 服务器开机自启、崩溃自愈并防止内存熔断,推荐创建 /etc/systemd/system/strata-3060.service:
[Unit]
Description=Strata Qwen3.8-125B Production Server (RTX 3060 12G)
After=network.target nvidia-persistenced.service

[Service]
Type=simple
User=xin
WorkingDirectory=/home/xin/AI/Strata
ExecStart=/home/xin/AI/Strata/strata-server \
  --engine strata \
  --ple-io direct \
  --vram-reserve-mib 768 \
  --expert-cache auto \
  --prefill auto \
  --spec 4 \
  --spec-min-p 0.5 \
  --max-context 131072 \
  --kv int8 \
  --kv-resident 32768
Restart=always
RestartSec=10
LimitNOFILE=65535
TimeoutStartSec=1800
Environment="CUDA_VISIBLE_DEVICES=0"
MemoryHigh=58G
MemoryMax=62G

[Install]
WantedBy=multi-user.target
执行使能并拉起服务:
sudo systemctl daemon-reload
sudo systemctl enable strata-3060.service
sudo systemctl start strata-3060.service
六、常见问题解答 (FAQ)
Q1:我的整机刚好只有 64GB DDR4 内存,开机系统自身会占几 G,会爆内存吗?
答:完全不会。虽然评测机插满 4 根槽位达到 80GB(2×32GB + 2×8GB 非对称弹性双通道),但我们在全周期进行了严密驻留观测,实测包括 Strata 守护进程、次级专家缓存、Linux 基础系统开销在内,整机真实内存峰值始终牢牢控制在 52.9GB(严格小于 60GB)。因此使用标准 2×32GB(64GB)对称双通道 的老机器不仅性能更佳(对称双通道带宽更高),且开机常驻仍有 11.1GB 以上的充裕缓冲,完全零风险。
Q2:一定要用 NVMe M.2 固态吗?普通 SATA 固态差距有多大?
答:如果有闲置的 NVMe M.2 固态当然更好。但本期评测的重大发现就是:只要开启了 --ple-io direct 绕过内核缓存污染,即便是最低端的廉价无缓存 SATA 固态,也能跑出 63.6 tok/s 的优异表现,磁盘已不再是制约推理性能的绝对瓶颈。
Q3:RTX 3060 8G 版本或者 RTX 2060 12G 能否跑通这套方案?
答:
* 3060 8G 版本:无法运行。因为 8GB 显存扣除 768MB 安全垫与 4GB 临时计算区后,只剩不到 3.2GB,无法完整容纳 2473 个热点专家与 32K INT8 KV Cache,会导致核心层回退崩溃;
* 2060 12G 版本:可以运行,但由于 Turing 架构算力(FP16/INT8 Tensor Core 性能)弱于 Ampere,且显存带宽与 PCIe 规格较低,稳态速度预计在 28~35 tok/s 左右。目前千元二手市场上,GA106 核心的 3060 12G 依然是性价比最高的甜品卡。
Q4:开启 MTP 投机解码(–spec 4)会对千亿模型的输出精度产生负面影响吗?
答:完全无损。MTP(Multi-Token Prediction)或投机解码的机制是“由独立草稿头预先提出后续候选 Token,再交由 125B 主模型执行严格的张量并行检验”。检验通过则采纳,检验不通过则回退重算,数学上输出分布与原生模型 100% 精确对齐。
七、文末资源导航与双向导流卡片
╔════════════════════════════════════════════════════════════════════════╗
║ 🛠️ 玩客笔记 · 生产级本地 AI 资源工坊直达通道 ║
╠════════════════════════════════════════════════════════════════════════╣
║ 🌐 博客全站工具导航: https://blog.757688.xyz/tools ║
║ ║
║ 📦 本期核心工程交付物直达: ║
║ • 📺 YouTube 高清 1080P 正片: https://www.youtube.com/watch?v=Iv-E2i1jgxk ║
║ • 📺 B站官方互动置顶视频: https://www.bilibili.com/video/BV1CxpC69ERg ║
║ • 💻 Strata 混合分级驻留引擎源码: https://github.com/strata-ai/strata ║
║ • 🤖 Qwen 官方 125B 权重仓库: https://huggingface.co/Qwen ║
║ ║
║ ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ ║
║ 【长期推荐 / 常用服务】 ║
║ • 🌐 高性价比海外网络与 VPS (XMRTH): https://www.xmrth.lol/auth/register?code=cOUX ║
║ • 🏠 全球高质量住宅 IP 代理 (IPRoyal): https://iproyal.cn/?r=292196 ║
║ • 💳 海外开发与支付辅助 (AccBoy): https://accboy7wkbj.acceboy.com/ ║
║ • ☁️ 阿里云特惠活动专区: https://www.aliyun.com/minisite/goods?userCode=sgy1lcae ║
║ ║
║ 💬 下期实测投票(欢迎在视频评论区留言): ║
║ A. 1500元 RTX 4060 Ti 16G 极限跑满 70B 满血模型深度实测 ║
║ B. 苹果 Mac M系列芯片 (M2/M3/M4) 本地极限压榨千亿 MoE ║
╚════════════════════════════════════════════════════════════════════════╝
About The Author