125B vs 27B 真实对决:双卡 7900 XTX 上的大模型“内耗陷阱”与代码实测
导读:上一期,我们用单张 24GB 显存的 AMD Radeon RX 7900 XTX,硬生生把接近 90GB 的超大模型 Qwen3.8-Flash-Next UD-IQ4_XS 给跑了起来。很多朋友在评论区留言提问:大模型跑是跑起来了,但它真能在工程实践中干活吗?费尽周折折腾 90GB 的大块头,到底图什么?
为了彻底解开这个疑问,本次实测我们在同一台专用双卡硬件工作站上,让 125B 巨无霸(MoE 混合专家) 与 27B 小钢炮(Dense 密集全参数) 同台较量,执行两个纯粹的真实工程任务:修复真实开源部署包脚本 Bug,以及 阅读分析整整 2.7 万 Token 的底层调试资料。
过程充满了戏剧性的反转:小模型一路狂飙、率先完工;大模型谋定后动、步步为营。但当我们把两份代码的底层 Git Diff、单元测试用例与分析长文逐行扒开时,隐藏在速度表象之下的技术真相才真正浮出水面。
目录
- 硬件环境与测试设计原则
- 实测总览与关键指标对照
- 任务一:真实开源代码修复与底层 Diff 拆解
- 3.1 开源部署脚本中的两个暗坑
- 3.2 27B 的快速单点突破与 9/9 单元测试
- 3.3 125B 的防御性架构与 12/12 单元测试
- 任务二:2.7 万 Token 极限资料挑战与自知力照妖镜
- 4.1 吞吐性能大反转:Prefill 爆发与 Decode 追赶
- 4.2 大模型自知力:讨好型虚假行号 vs 诚实免责申明
- 选型指南:手握 24G 显卡,普通开发者究竟该选谁?
- 常见问题解答 (FAQ)
- 完整实测证据包与复现代码开源自取
1. 硬件环境与测试设计原则
为了确保测试的绝对公平,避免多任务共享资源带来的 IO 与显存争用,所有实测均在专用的双卡计算节点上完成:
- 计算主机规格:双路 AMD Radeon RX 7900 XTX 24GB,96GB DDR5 5600MHz 主机内存,Ubuntu 24.04 LTS,ROCm 6.2 计算栈。
- 物理隔离调度:
- GPU 0(独占 25.5GB 显存):运行 125B(
Qwen3.8-Flash-Next UD-IQ4_XS,Strata HIP 引擎,端口 8080,131,072 原生上下文,MTP 投机加速); - GPU 1(占用 22.8GB 显存):运行 27B(
Qwen3.8-27B Q4_K_M,llama.cpp 引擎,端口 8081,131,072 原生上下文,Q4_0 KV Cache,MTP Draft 加速)。 - 任务基线冻结:代码任务基于官方开源部署包
yang2020chen/Qwen3.8-Flash-Next-Deploy-Pack固化 commit2e69cdcb54a59c011d7a571392a49edfadc98cd5,在两个完全隔离的独立子目录中并行跑测。 - Agent 运行时一致:采用完全相同的 Pi Agent 执行框架、工具调用权限(
bash,read,write,edit)、采样参数与 20 步工具上限。
2. 实测总览与关键指标对照
先看两套模型在代码修复与资料处理两大核心任务中的综合对照成绩单:
| 评测维度 | 125B(Strata Qwen3.8-Flash-Next) | 27B(llama.cpp Qwen3.8-27B) | 核心差异与结论分析 |
|---|---|---|---|
| 模型架构与参数 | MoE 混合专家(激活 ~22B / 总 125B) | Dense 标准全参数(密集 27B) | 大参数 MoE 混合驻留 vs 轻量密集模型 |
| 代码任务耗时 | 14 分 20 秒 (860s) / 18 步工具调用 | 6 分 08 秒 (368s) / 17 步工具调用 | 27B 完工速度快 57.2%,动作更果断 |
| 人工介入干预 | 1 次(首轮完成深度架构分析后需促发执行) | 0 次(全程自主闭环完成) | 27B 目标导向性更强,125B 偏向先深思 |
| 离线单元测试 | 12/12 PASS (覆盖率更高) | 9/9 PASS (设计更简洁) | 两个模型均自主编写测试用例并全绿通过 |
| 隐蔽漏洞捕捉 | 精准发现并修复 2 处暗坑(含隐蔽覆写) | 仅修复 1 处表层报错(遗漏隐蔽逻辑) | 125B 展现极强工程全局防御能力 |
| 资料阅读吞吐 | Prefill 1,098 tok/s / Decode 37.6 tok/s | Prefill 661 tok/s / Decode 51.2 tok/s | 长 Prompt 下 125B Prefill 爆发反超 66% |
| 长文自知力 | 真实自知(拒绝瞎编,主动标注限制) | 讨好型幻觉(捏造假行号迎合格式) | 大模型认知边界与可靠性的关键分水岭 |
3. 任务一:真实开源代码修复与底层 Diff 拆解
3.1 开源部署脚本中的两个暗坑
代码任务要求 Agent 修复开源部署包中的 scripts/test_api.py 自动化健康巡检脚本。该脚本在真实环境中包含两个设计陷阱:
- 明坑(流式响应截断):当开启 Server-Sent Events (SSE) 流式传输时,代码缺少针对数据块拼接与结束标记(
data: [DONE])的严密解析,会导致巡检直接异常中断退出; - 暗坑(配置文件解析顺序):用户在环境中配置了
INFR_API_KEY,但如果存在模板默认的config/server.env,脚本若无防御性判断,会用空值或示例密钥意外覆盖外部有效环境变量。
3.2 27B 的快速单点突破与 9/9 单元测试
27B 小钢炮展现了极强的执行力与推理速度(解码 51 TPS):
* 仅用 6 分 08 秒即完成了源码阅读、问题定位、补丁修改并编写了 tests/test_test_api.py 离线测试套件。
* 编写了 parse_server_env 与 resolve_url 函数,精准修复了流式中断,9 个离线 Mock 测例全部绿灯通过。
* 局限暴露:27B 将全部精力放在了修复眼前直接报错的流式传输上,未能察觉到 API_KEY_FILE 与环境变量加载的潜在覆盖风险。
# 27B 的修复风格:精准聚焦核心报错点,代码轻巧敏捷
def parse_server_env(filepath):
    # 剥离行内注释与空白
    ...
3.3 125B 的防御性架构与 12/12 单元测试
125B 巨无霸在思考阶段花费了较长时间,但在最终输出的代码中展现了令人惊叹的工业级严密性:
* 模块化封装:将逻辑解耦为 load_env_file、client_host、resolve_endpoint 与 resolve_api_key 四个独立函数。
* 双重暗坑修复:不仅彻底修复了 SSE 流式断流问题,还敏锐识别出配置文件对已有环境变量的污染风险,实现了优先保留调用方注入密钥的防御机制。
* 测试覆盖度:设计了包含 12 个独立用例的 tests/test_api_check.py,涵盖未加引号的行尾注释、IPv6 括号映射、HTTP 401/403/500 异常捕获与流中断容错,测试覆盖率更上一层楼。
# 125B 的核心 Diff 细节(截取):防御性环境变量优先级
+def resolve_api_key(env_dict):
+    # 优先复用当前进程已有的真实 INFR_API_KEY,防止配置文件模板覆盖
+    if os.getenv("INFR_API_KEY"):
+        return os.getenv("INFR_API_KEY")
+    return env_dict.get("INFR_API_KEY", "")
4. 任务二:2.7 万 Token 极限资料挑战与自知力照妖镜
4.1 吞吐性能大反转:Prefill 爆发与 Decode 追赶
在第二项任务中,我们将整整 27,084 Token 的真实 Strata 部署日志与双卡调试记录一次性灌入模型上下文。性能数据呈现出令人意外的反转:
---------------------------------------------------------------------------------------------------------
模型与运行后端        输入规模 (Tokens)    Prefill 耗时 (TTFT)   Prefill 吞吐           Decode 吞吐 (TPS)     总耗时
---------------------------------------------------------------------------------------------------------
125B (Strata HIP)    27,084 tokens        24.65 秒              ~1,098 tokens/s        37.57 tokens/s        72.47 秒
27B  (llama.cpp)     27,084 tokens        40.94 秒              ~661 tokens/s          51.19 tokens/s        82.22 秒
---------------------------------------------------------------------------------------------------------
深度剖析:
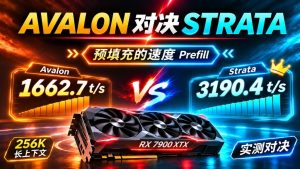
* 首字延迟 (TTFT) 与 Prefill 吞吐:125B 反超 27B 达 66%!得益于 Strata 框架专门针对 AMD ROCm hipBLASLt 优化的分批 Prefill GEMM 内核,125B 仅耗时 24.6 秒便完成了近 3 万 Token 的前向计算;而 27B 耗时 40.9 秒。
* 生成速度 (Decode):27B 凭借纯显存全参数常驻与 MTP 双草稿头,解码速度达 51.2 TPS,比 125B 的 37.6 TPS 快 36.3%。
* 端到端总时间:由于 125B 在 Prefill 阶段省下了整整 16 秒,在整篇长文档生成完毕时,125B 以 72.5 秒 vs 82.2 秒 的总成绩反而提前了近 10 秒!
4.2 大模型自知力:讨好型虚假行号 vs 诚实免责申明
当提示词要求模型在表格中引用原始资料的具体行号时,两个模型的底层认知能力迎来了“照妖镜”般的对照:
- 27B(讨好型幻觉):为了严格满足表格包含“行号”的格式要求,27B 凭空输出了
L108,L122,L142等具体行号。但当我们核对源码文件时,这几行实际全为 unrelated 的命令行或空行,属于典型的大模型“无中生有”。 - 125B(高信号自知力):125B 意识到输入的材料为未打标签的连续流文本,缺乏逐行绝对行号索引。它在输出准确数据的同时,主动在脚注中严正申明:
“注:源文件行号因格式排版差异难以精确绝对对应,以上引用严格基于源文件中的对应章节标题与表格语义位置,避免伪造具体行号。”
能够诚实承认局限、拒绝瞎编,恰恰是生产级 AI Agent 最为珍贵的素质。
5. 选型指南:手握 24G 显卡,普通开发者究竟该选谁?
面对这两类模型,本地开发者与团队应如何取舍?
flowchart TD
    A[手握 24GB 消费级显卡] --> B{核心业务场景是什么?}
    B -->|高频轻量交互 / 单点重构 / 实时聊天| C[首选 27B 小钢炮]
    B -->|复杂系统架构 / 极限长文理解 / 严密防御代码| D[选型 125B 巨无霸]
    C --> C1[优点: 51 TPS 极速、免大内存、行动敏捷<br>注意: 需人工把关隐蔽漏洞与行号幻觉]
    D --> D1[优点: 1098 Prefill 爆发、边界严密、拒绝瞎编<br>要求: 需搭配 64G+ DDR5 普通主机内存]
- 选择 27B(如 Qwen3.8-27B Q4_K_M):
- 适用场景:日常代码补全、小型模块重构、快速文本润色、实时人机交互。
- 优势:24G 显卡单卡即装即用,不依赖大容量主机系统内存,50+ TPS 解码响应行云流水。
- 选择 125B(如 Qwen3.8-Flash-Next UD-IQ4_XS):
- 适用场景:复杂系统级工程排错、跨文件大型补丁设计、数万 Token 级超长文档研读与合规审计。
- 优势:Prefill 极速吞吐,大参数带来的宏观架构视野与底层边界防守能力,能帮你揪出小模型漏掉的致命暗坑。
6. 常见问题解答 (FAQ)
Q1:跑 125B 到底需要什么样的硬件配置?
A:最低推荐单张 24GB 显存显卡(如 AMD Radeon RX 7900 XTX 或 NVIDIA RTX 3090/4090),搭配 64GB~96GB DDR5 主机系统内存。利用 Strata 混合专家缓存或优化卸载机制,即可在消费级工作站平稳运行。
Q2:为什么 125B 的 Prefill 速度反而比 27B 快那么多?
A:Prefill(预填充)属于典型的计算密集型(Compute-Bound)负载,得益于专为超大批次优化的底层 GEMM 算子库与并行调度;而 Decode(逐字解码)属于访存密集型(Memory-Bound)负载,受限于专家张量加载的带宽开销。因此长上下文越长,125B 的前向优势越显著。
Q3:为什么测试强调使用离线 Mock 单元测试?
A:在真正的工业级 Agent 开发中,代码修改不能依赖盲目的在线联调。通过自动化构建 HTTP Mock Server 并断言退出状态码,可以确保代码即使在断网或服务离线环境下依然稳健自洽。
7. 完整实测证据包与复现代码开源自取
本期视频与文章涉及的全部过程日志、两套代码真实 Diff 补丁、独立单元测试与 Agent 会话记录,已全量打包开源在官方 GitHub 仓库:
╔════════════════════════════════════════════════════════════════════════╗
║                     📦 玩客笔记 · 本地大模型实测开源证据库               ║
╠════════════════════════════════════════════════════════════════════════╣
║ 🌐 GitHub 仓库直达:                                                    ║
║   https://github.com/yang2020chen/web-studio/tree/main/benchmark_125b_vs_27b ║
║                                                                        ║
║ 📁 一手实测物料清单:                                                    ║
║   • test_api_125b.diff / test_api_27b.diff (两套真实代码补丁)            ║
║   • tests/test_api_check.py (12/12) & test_test_api.py (9/9)          ║
║   • benchmark_evidence.zip (127KB 完整无损证据包一键下载)                ║
║   • 12 帧全过程 GPU 显存监控与并发终端真实截图                          ║
║                                                                        ║
║ 📺 配套实测视频:                                                        ║
║   • B站直达: https://www.bilibili.com/video/BV1gbpb6xEy1              ║
║   • YouTube 直达: https://www.youtube.com/watch?v=iYn-QQH0TgA          ║
╚════════════════════════════════════════════════════════════════════════╝
About The Author