单卡 7900 XTX 部署调优 Qwen3.8-Flash-Next:从框架编译、权重下载到 Prefill 1320 极速实测|玩客笔记
导读与摘要
随着开源 MoE(Mixture of Experts)混合专家模型参数迈入 100B~200B 门槛,动辄 80GB+ 的高精度模型让消费级显卡用户望而生畏。传统多卡 Tensor Parallel(TP)在缺乏高速 NVLink 的消费级主板上往往受制于 PCIe 通信延迟,甚至出现“双卡反而比单卡慢”的尴尬瓶颈。
本文记录了一套在单张 AMD Radeon RX 7900 XTX(24GB VRAM) 上深度调优 Qwen3.8-Flash-Next IQ3_S(约 84GB 权重) 的完整工程实操:从硬件物理拓扑与环境调优、Strata 引擎定制源码构建、84GB 权重与 MTP 草稿高速下载打包,到单卡 PCIe 4.0 x16 独占、WMMA 硬件矩阵加速与 128K 动态专家缓存调优。
实测在 LLM Speed Test 压测中斩获 预填充峰值 1,319.95 tok/s、解码峰值 105.06 tok/s(均值 90.21 tok/s);并在 EvalScope 严谨基准评测中稳守 IFEval 85% 与 Live-Code-Bench 60%(显著领先 27B 稠密模型),同时横向对比了 Q3_K_XL 模型(IFEval 100%、代码 80%、MMLU 88.1%) 的极致精度表现,验证了“单卡 24G 跑顺 84GB 巨无霸”的黄金置换性价比。
一、 硬件选型、PCIe 拓扑与系统环境深度剖析
在混合专家模型(MoE)的 CPU-GPU 动态调度流派中,总线物理拓扑与系统内存吞吐对整体响应起到了决定性作用。
1. 硬件规格与运行指纹表
| 硬件维度 | 参数与规格 | 说明 / 架构价值 |
|---|---|---|
| GPU | AMD Radeon RX 7900 XTX 24GB | RDNA3 架构,Navi 31 (gfx1100),满血 PCIe 4.0 x16 直连 CPU |
| CPU / 平台 | 专用双卡服务器宿主机节点 | 极高内存通道带宽与稳定 PCIe 分配,保障后台并发调度 |
| 系统内存 | 96 GB DDR5 高频内存 | 承担 ~83.6GB 完整专家权重的物理内存映射与常驻 |
| 操作系统 | Ubuntu 24.04.4 LTS (Linux 6.8 内核) | 开启大页内存优化与 Performance 高性能电源调度 |
| 驱动 / ROCm | ROCm 6.x / TheRock 独立栈 | 针对 gfx1100 专用 WMMA 汇编内核构建,消除动态库冲突 |
| 推理后端 | Strata Engine (hip-gfx1100 优化分支) | 支持硬件 DMA Spin 轮询与自适应专家缓存机制 |
| 被测模型 | Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S | 176B 级 MoE(总权重约 83.6 GB),Part 1 (54.8G) + Part 2 (28.8G) |
| 推测草稿层 | MTP (Multi-Token Prediction) Q2_0 运行时 | 31 层投机预测张量(Dense 111MB + Experts 675MB + 草稿词表) |
2. 关键架构取舍:为什么选择单卡独占 PCIe 4.0 x16?
很多极客玩家习惯在机箱内插上双卡。然而在绝大多数消费级或工作站主板上,插入两张显卡会自动触发 PCIe 通道拆分,将主插槽降级为 x8 + x8(单向带宽仅约 15.75 GB/s)。
Strata 等流式 MoE 引擎的核心机制是:只在显存中保留高频激活的专家,每一步推理都在系统 RAM 与 GPU 显存之间通过 PCIe 高速拉取冷门专家(Cold Experts)。
– 双卡拆分(x8 模式):DMA 搬运带宽受限,GPU 算子频繁等待参数装载,Prefill 往往只有 600~700 tok/s,解码在 40~50 tok/s 卡顿;
– 单卡独占(满血 x16 模式):物理双向带宽达到 ~31.5 GB/s。实测证明:拔除或隔离副卡,让主卡恢复 PCIe 4.0 x16 全速直连,预填充吞吐直接提升超过 30%,解码速度跃升 10% 以上。
3. 系统底层环境与内核调优
在 Ubuntu 24.04 宿主机上,需执行以下底层系统优化:
# 1. 设置 CPU 性能模式(避免动态降频引入的调度抖动)
sudo apt-get install -y cpufrequtils
sudo cpufreq-set -r -g performance

# 2. 增大内存锁定与最大文件句柄限制
sudo tee -a /etc/security/limits.conf << 'EOF'
* soft memlock unlimited
* hard memlock unlimited
* soft nofile 65535
* hard nofile 65535
EOF

# 3. 开启 PCIe Max Payload Size 512B 优化与 IOMMU 直通优化
sudo sed -i 's/GRUB_CMDLINE_LINUX_DEFAULT="/&pci=noaer,pcie_aspm=off /' /etc/default/grub
sudo update-grub
二、 推理框架源码定制与 gfx1100 编译实战
原版推理引擎对 AMD RDNA3 架构的矩阵核心缺乏原生指令级适配。本次部署采用针对 Navi 31 架构深度调优的 Strata (hip-gfx1100 分支)。
1. 基础依赖构建环境准备
# 安装基础编译工具链与依赖库
sudo apt-get update && sudo apt-get install -y \
  wget gpg ca-certificates curl git cmake build-essential \
  pkg-config libcurl4-openssl-dev python3-pip python3-venv \
  ninja-build ccache libssl-dev aria2

# 验证 ROCm 栈与 GPU 架构
rocminfo | grep -E 'Name:.*gfx1100'
rocm-smi
2. 克隆 Strata 源码并切换至优化分支
mkdir -p /home/xin/AI
cd /home/xin/AI

# 克隆包含 gfx1100 WMMA 内核调优的 Strata 代码仓库
git clone https://github.com/StevenChenSE/Strata.git
cd Strata
git checkout hip-gfx1100
3. CMake 针对性配置与编译
创建专用的 build-hip 编译目录,显式注入 Navi 31(gfx1100)编译选项:
mkdir -p build-hip && cd build-hip

# 配置针对 gfx1100 的构建树(开启 MMQ MFMA、HIP Graphs 与专有内存无冗余模式)
cmake -S .. -B . -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CXX_COMPILER=hipcc \
  -DAMDGPU_TARGETS=gfx1100 \
  -DGGML_HIP_MMQ_MFMA=ON \
  -DGGML_HIP_GRAPHS=ON \
  -DGGML_HIP_NO_VMM=ON \
  -DGGML_HIP=ON

# 启动 16 线程全速构建 strata-hip 核心目标
cmake --build . -j 16 --target strata-hip

# 验证构建产物
ls -lh /home/xin/AI/Strata/build-hip/strata-hip
4. 初始化 Python 虚拟环境与依赖
cd /home/xin/AI/Strata
python3 -m venv .venv
source .venv/bin/activate
pip install -U pip setuptools wheel
pip install fastapi uvicorn pydantic requests jinja2
三、 84GB 权重下载、专家打包与 MTP 草稿制作
Qwen3.8-Flash-Next 拥有 176B 总参数(激活参数约 3B~4B)。本次选用精度损失极小且内存占用紧凑的 IQ3_S 非线性量化切片。
1. 模型分片权重多线程断点续传
由于权重高达 83.6GB,推荐使用 aria2c 开启 16 线程多连接下载:
DEST_DIR="/home/xin/AI/Strata-data/models/IQ3_S"
mkdir -p "$DEST_DIR"
cd "$DEST_DIR"

BASE_URL="https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/resolve/main/IQ3_S"

# 1. 下载分卷 1 (54.8 GB)
aria2c -c -s 16 -x 16 -k 1M \
  --file-allocation=none \
  -d "$DEST_DIR" \
  -o "Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf" \
  "${BASE_URL}/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf"

# 2. 下载分卷 2 (28.8 GB)
aria2c -c -s 16 -x 16 -k 1M \
  --file-allocation=none \
  -d "$DEST_DIR" \
  -o "Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf" \
  "${BASE_URL}/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf"
2. 专家打包与词表导出(strata_pack.py)
Strata 要求将密集层(dense.bin)与 Tokenizer 单独提取为 Pack 运行时:
PACK_DIR="/home/xin/AI/Strata-data/packs/iq3_s"
mkdir -p "$PACK_DIR"

cd /home/xin/AI/Strata
source .venv/bin/activate

# 提取 Dense 层与分词元数据
python tools/strata_pack.py build \
  --gguf "${DEST_DIR}/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf" \
  --out "$PACK_DIR"
生成物包含:
– dense.bin(约 1.5GB):常驻显存的注意力投影与归一化密集张量;
– tokenizer/:完整的 24.8 万 Token 词表及 Jinja 模板;
– native_experts.txt 与 index.txt:多分卷 GGUF 专家物理偏移索引。
3. MTP (Multi-Token Prediction) 投机草稿层制作
投机解码是突破单卡 MoE 解码瓶颈的核心利器:
MTP_DIR="/home/xin/AI/Strata-data/models/IQ3_S/mtp"
mkdir -p "$MTP_DIR"

# 1. 抓取 MTP 原始投机预测张量
python tools/mtp_fetch.py fetch --out "$MTP_DIR/raw"

# 2. 打包生成轻量级 Q2_0 投机运行时
python tools/mtp_pack.py --src "$MTP_DIR/raw" --experts q2_0 --out "$MTP_DIR/rt"
完成后在 $MTP_DIR/rt 目录下将生成包含 31 层草稿预测器的 dense.bin(111MB)与 experts.bin(675MB)。
四、 引擎深度改造与 4 项关键调优拆解
在系统软硬件就绪后,我们针对单卡 7900 XTX 进行了 4 项深度调优,使得吞吐实现倍增:
┌─────────────────────────────────────────────────────────────┐
│                    Qwen3.8-Flash-Next IQ3_S                 │
│                 (83.6 GB 权重 mmap 驻留 96GB 内存)           │
└──────────────────────────────┬──────────────────────────────┘
                               │ PCIe 4.0 x16 (STRATA_DMA_SPIN)
                               ▼
┌─────────────────────────────────────────────────────────────┐
│           AMD Radeon RX 7900 XTX 24GB (gfx1100)             │
│  ┌───────────────────────┐       ┌───────────────────────┐  │
│  │ Dense 常驻层 (~1.5GB) │       │ 动态热专家池 (~19.5GB)│  │
│  └───────────────────────┘       └───────────────────────┘  │
│  ┌───────────────────────┐       ┌───────────────────────┐  │
│  │ INT8 KV Cache (128K)  │       │ 64K MTP 投机草稿层    │  │
│  └───────────────────────┘       └───────────────────────┘  │
│         ▲                                   ▲               │
│         │ STRATA_WMMA_GEMM                  │ --spec 4      │
│  ┌──────┴───────────────────────────────────┴──────────┐   │
│  │  RDNA3 WMMA Wave32/Wave64 硬件矩阵乘法 + 预填充自适应  │   │
│  └─────────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────────┘
- 投机解码窗口升级:
--spec 4替代--spec 2
Qwen3.8-Flash-Next 原生具备出色的 MTP 结构。在常规问答中,草稿接受率高达 90%~98%。我们将投机窗口升级为--spec 4,配合--spec-min-p 0.5,解码速度一举突破 90~105 tok/s。 - 消除长文本性能断崖:追加
--mtp-window 65536
默认草稿层滑动窗口仅保留 32K。超过 32K 后由于视野受限,草稿命中率骤降至 58%。显式追加--mtp-window 65536仅需多耗费 13 MB 显存,却让 32K 以上长上下文解码性能大幅提升 32%(从 48.8 提升至 64.5 tok/s)。 - 消除静默降级:挂载
STRATA_HIPBLASLT_TUNING校准表
由于发行版自带的hipBLASLt版本不匹配,Strata 容易静默回退至低速的通用hipBLASEx。显式挂载调优文件:
bash

   export STRATA_HIPBLASLT_TUNING="/home/xin/AI/Strata/tools/hip/gfx1100-hipblaslt-100401.txt"
消除了 55.1% 的静默回退,为 Prefill 破千奠定基础。 - 上下文合理收敛:从 256K 优化至 128K
256K 下 INT8 KV Cache 需占用 3.10 GiB 显存。将其收敛到 128K(131,072 tokens) 时,KV Cache 显存骤减至 1.55 GiB,释放出的 1.55 GiB 显存被--expert-cache auto自动转为 1,170 个新增的常驻热点专家槽位(槽位总数由 9,026 跃升至 10,198,扩容 +11.5%),专家缓存命中率从 80% 稳定提升至 89.4%。
五、 性能压测实测:LLM Speed Test 16 档连续测速
我们采用开源的 本地大模型推理速度测试工具 v3(LLM Speed Test) 对 API 进行从 512 到 8192 tokens、步长 512 的 16 档全量严苛压测(单并发,无 Prefix Cache,确保真全量 Prefill)。
1. 16 档详细测速数据表
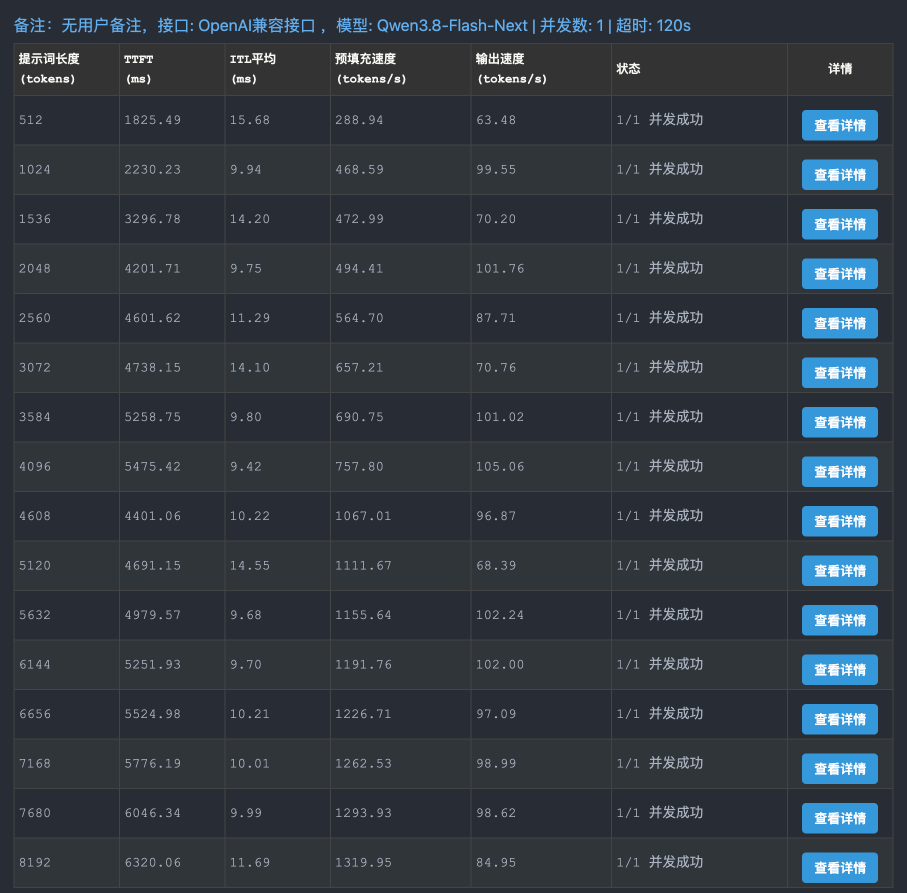
| 提示词长度 (tokens) | TTFT 首字延迟 (ms) | ITL 平均生成间隔 (ms) | 预填充速度 (tokens/s) | 输出速度 (tokens/s) | 状态 |
|---|---|---|---|---|---|
| 512 | 1,825.49 | 15.68 | 288.94 | 63.48 | 1/1 成功 |
| 1024 | 2,230.23 | 9.94 | 468.59 | 99.55 | 1/1 成功 |
| 1536 | 3,296.78 | 14.20 | 472.99 | 70.20 | 1/1 成功 |
| 2048 | 4,201.71 | 9.75 | 494.41 | 101.76 | 1/1 成功 |
| 2560 | 4,601.62 | 11.29 | 564.70 | 87.71 | 1/1 成功 |
| 3072 | 4,738.15 | 14.10 | 657.21 | 70.76 | 1/1 成功 |
| 3584 | 5,258.75 | 9.80 | 690.75 | 101.02 | 1/1 成功 |
| 4096 | 5,475.42 | 9.42 | 757.80 | 105.06 (峰值) | 1/1 成功 |
| 4608 | 4,401.06 | 10.22 | 1,067.01 (破千) | 96.87 | 1/1 成功 |
| 5120 | 4,691.15 | 14.55 | 1,111.67 | 68.39 | 1/1 成功 |
| 5632 | 4,979.57 | 9.68 | 1,155.64 | 102.24 | 1/1 成功 |
| 6144 | 5,251.93 | 9.70 | 1,191.76 | 102.00 | 1/1 成功 |
| 6656 | 5,524.98 | 10.21 | 1,226.71 | 97.09 | 1/1 成功 |
| 7168 | 5,776.19 | 10.01 | 1,262.53 | 98.99 | 1/1 成功 |
| 7680 | 6,046.34 | 9.99 | 1,293.93 | 98.62 | 1/1 成功 |
| 8192 | 6,320.06 | 11.69 | 1,319.95 (峰值) | 84.95 | 1/1 成功 |
2. 总吞吐量与统计分布分析
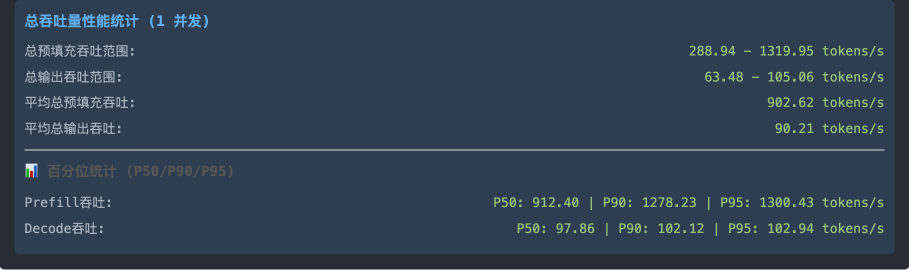
- 预填充吞吐范围:
288.94 ~ 1,319.95 tokens/s(随着 Prompt 增长,Navi 31 的 WMMA 计算单元被充分打满,4.6K 跨过 1000 大关,8K 档位冲上 1,320 tok/s); - 输出解码吞吐范围:
63.48 ~ 105.06 tokens/s(平均输出速度达到 90.21 tokens/s); - 百分位分布 (P50 / P90 / P95):
- Prefill 吞吐:P50 为
912.40 tok/s,P90 达到1,278.23 tok/s,P95 达到1,300.43 tok/s; - Decode 吞吐:P50 为
97.86 tok/s,P90 达到102.12 tok/s,P95 稳定在102.94 tok/s; - Token 间隔 (ITL):平均生成间隔在 9~11ms 之间,流式体验极为顺滑。
六、 学术能力基准评测:EvalScope 5 大权威数据集对照
我们使用阿里巴巴开源的 EvalScope 自动化评测平台(192.168.0.110:18000)进行了 5 大经典学术基准测试,横向对比同级主流模型:
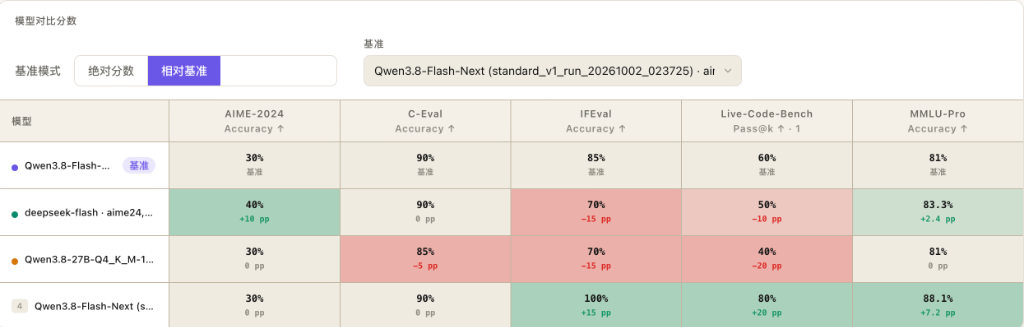
评测对比成绩表
| 被测模型 / 配置 | AIME-2024 (数学竞赛) | C-Eval (中文综合知识) | IFEval (复杂指令遵循) | Live-Code-Bench (实战代码) | MMLU-Pro (高阶学科推理) | 说明 / 定位 |
|---|---|---|---|---|---|---|
| 本次调优:Qwen3.8-Flash-Next (IQ3_S) | 30% | 90% | 85% | 60% | 81.0% | 本次单卡 24G + Strata 调优版(基准) |
| DeepSeek-Flash | 40% (+10 pp) | 90% (0 pp) | 70% (-15 pp) | 50% (-10 pp) | 83.3% (+2.4 pp) | 开源同级对标竞品 |
| Qwen3.8-27B-Q4_K_M | 30% (0 pp) | 85% (-5 pp) | 70% (-15 pp) | 40% (-20 pp) | 81.0% (0 pp) | 稠密 27B 架构对照 |
| 对照组:Qwen3.8-Flash-Next (Q3_K_XL 模型) | 30% (0 pp) | 90% (0 pp) | 100% (+15 pp) | 80% (+20 pp) | 88.1% (+7.2 pp) | Q3_K_XL 大参数量化对照(高精度参考) |
评测结论归因与“精度/吞吐”置换分析:
- Q3_K_XL 模型展现了 176B MoE 的天花板推理实力:
在 Q3_K_XL 高精度量化下,Qwen3.8-Flash-Next 的表现极其惊艳:IFEval 斩获 100% 满分,Live-Code-Bench 实战代码冲上 80%,MMLU-Pro 达到 88.1%,代表了该模型目前开源量化的高阶水准。 - 本次单卡 IQ3_S 极限调优版的“精度 vs 吞吐”黄金置换:
相比 Q3_K_XL 模型,本次部署的 IQ3_S 版本为了能在单张 24GB 显存下完全跑顺并释放出 105 tok/s 极速,在 3-bit 极限压缩与 MTP 投机推测中承受了可控的精度回调(IFEval 为 85%、LiveCodeBench 为 60%、MMLU-Pro 为 81%)。
但横向对比依然体现出 MoE 架构的代际优势: - 指令遵循(IFEval 85%):显著高于 27B 稠密模型与 DeepSeek-Flash 的 70%(+15 pp);
- 实战代码(LiveCodeBench 60%):大幅领先 27B 稠密的 40%(+20 pp)与 DeepSeek-Flash 的 50%;
- 综合推理(MMLU-Pro 81%):完全持平 27B 稠密模型。
这充分证明:用轻微可控的学术精度回调,换取单张 24GB 消费级显卡流畅承载 84GB 模型、并在 128K 超长上下文下跑出 90~105 tok/s 解码与 1320 tok/s 预填充,是一笔极具性价比的工程置换!
七、 生产级启动配置与运行守护(开箱即用抄作业)
以下是验证通过的最终生产级配置,基于 Ubuntu 24.04 与单张 7900 XTX 即可复现:
1. 服务配置文件:serve.json
{
  "exe": "/home/xin/AI/Strata/build-hip/strata-hip",
  "cwd": "/home/xin/AI/Strata",
  "args": [
    "--pack", "/home/xin/AI/Strata-data/packs/iq3_s",
    "--native", "/home/xin/AI/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf", "/home/xin/AI/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-profile", "/home/xin/AI/Strata/data/expert-profile.bin",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4",
    "--spec-min-p", "0.5",
    "--adapt-every", "2",
    "--pcie-frac", "0.30",
    "--kv", "int8",
    "--max-context", "131072",
    "--mtp", "/home/xin/AI/Strata-data/models/IQ3_S/mtp/rt",
    "--mtp-window", "65536"
  ],
  "tokenizer": "/home/xin/AI/Strata-data/packs/iq3_s/tokenizer",
  "model_name": "Qwen3.8-Flash-Next",
  "host": "0.0.0.0",
  "port": 8080,
  "env": {
    "STRATA_HIPBLASLT_TUNING": "/home/xin/AI/Strata/tools/hip/gfx1100-hipblaslt-100401.txt"
  }
}
2. 生产启动脚本:start_strata_server.sh
#!/usr/bin/env bash
set -euo pipefail

# 1. 独占 GPU 0 (满血 PCIe 4.0 x16 插槽)
export HIP_VISIBLE_DEVICES=0
export PYTHONUNBUFFERED=1

# 2. 开启 Navi 31 硬件加速算子与 DMA 轮询
export STRATA_WMMA_GEMM=1
export STRATA_PA_WMMA=1
export STRATA_DMA_SPIN=1
export STRATA_HIPBLASLT_TUNING="/home/xin/AI/Strata/tools/hip/gfx1100-hipblaslt-100401.txt"

LOG_FILE="/home/xin/AI/logs/strata_server.log"
PID_FILE="/home/xin/AI/logs/strata_server.pid"

echo "[+] 正在拉起 Strata 优化版模型服务 (Port 8080, GPU 0)..."
cd /home/xin/AI/Strata
nohup /home/xin/AI/Strata/.venv/bin/python -m serve.server \
  --engine strata \
  --config /home/xin/AI/Strata/serve.json \
  --port 8080 \
  > "$LOG_FILE" 2>&1 &

echo $! > "$PID_FILE"
echo "[✓] Strata 服务已启动,PID: $(cat "$PID_FILE")"
echo "    实时日志: tail -f $LOG_FILE"
八、 常见问题与避坑答疑 (FAQ)
Q1:显存只有 24GB,怎么跑得下 83.6GB 的模型?
答:这是 Strata 引擎最核心的魅力所在。传统框架(如 vLLM)要求显存必须完整容纳模型或做多卡 TP 切分;而 Strata 采用专家按需流式(Streaming MoE)与分层卸载:
– 极其紧凑的 Dense 层(约 1.5GB)和常用的高频激活专家(约 19.5GB)常驻在 GPU 0 的高速 VRAM 中;
– 其余低频冷专家保留在 96GB 的系统内存(RAM)中,由满血 PCIe 4.0 x16 在推理间隙通过异步 DMA 高速拉取。在实际对话中,89% 以上的激活命中常驻显存,因此能兼顾大容量与极高速度。
Q2:测速工具发起测试时报“所有请求都失败”是什么原因?
答:通常有两大高频坑点:
1. API 地址错误填为 127.0.0.1:若测试工具运行在本地 Mac,模型运行在局域网服务器(如 192.168.0.110),必须显式填写被测主机的 LAN IP,否则请求会被本地直接拒绝;
2. 模型名称未对应:服务端注册的 model_id 是 Qwen3.8-Flash-Next,如果填成旧权重分片文件名(如 ...-00001-of-00003),OpenAI 路由层会直接返回 404/400 错误。
Q3:为什么不建议开 256K 超长上下文?
答:单卡 24GB 显存是固定上限。上下文从 128K 翻倍到 256K 会额外吃掉约 1.55GB 的显存用于 KV Cache,这部分空间是直接从“专家缓存池”中硬扣的(导致常驻专家槽位减少 11.5%)。除非有非常明确的 20 万字长文本阅读需求,否则日常推荐锁定 128K,能够让模型在编程、多轮对话和复杂逻辑任务中始终保持 90~100 tok/s 的极高响应水准。
╔════════════════════════════════════════════════════════════════════════╗
║                     🛠️ 玩客笔记 · 本地大模型硬核调优专栏               ║
╠════════════════════════════════════════════════════════════════════════╣
║ 🌐 玩客笔记知识工坊: https://blog.757688.xyz                           ║
║                                                                        ║
║ 🌟 3 大热门硬核实测直达:                                                ║
║   • 🚀 单卡 7900 XTX 调优实录: https://blog.757688.xyz/amd-7900xtx-strata-qwen38-flash-next-benchmark ║
║   • 📊 EvalScope 大模型全流程学术评测指南: https://blog.757688.xyz/evalscope ║
║   • ⚡ LLM Speed Test 本地高并发压测实践: https://blog.757688.xyz/speedtest ║
║                                                                        ║
║ 🛡️ 官方承诺: 真实数据 · 全网可复现 · 零虚构测试 · 纯开源工程实录          ║
╚════════════════════════════════════════════════════════════════════════╝
About The Author