单张24G显卡跑90G大模型:Strata与RX 7900 XTX部署调优实战
导读:在传统推理认知中,运行接近 90GB 体量的顶级 MoE 大模型(如 Qwen3.8-Flash-Next UD-IQ4_XS),至少需要 4 张 24GB 显卡或双路 80GB 专业计算卡。若在单张 24GB 显卡上使用传统的 Layer 线性切分卸载到 CPU,受限于 PCIe 带宽瓶颈,解码速度往往跌至可怜的 1~3 tok/s,丧失实用价值。
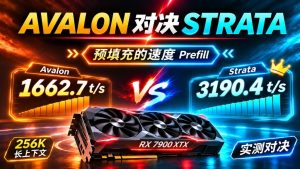
本文记录如何在 单张 AMD Radeon RX 7900 XTX(24GB 显存)+ 96GB 系统内存 的硬件环境下,利用专为 MoE 混合驻留设计的 Strata 推理引擎,实现 Prefill 1,715 tok/s、Decode 40~55 tok/s 的高性能推理,并原生打通 128K(131,072)超长上下文。
目录
- 硬件环境与架构选型背景
- 模型权重与 Strata 推理底座部署
- 核心性能调优:如何榨干 24GB 显存与 ROCm 算力
- 3.1 热点专家常驻缓存(Expert Cache)
- 3.2 KV Cache 分层流式驻留(突破 128K 上下文)
- 3.3 MTP 多 Token 投机推测解码
- 3.4 ROCm hipBLASLt 专用自校准调优表(Prefill 提升 41.7%)
- 生产级守护配置与自愈体系
- 全场景性能压测实测数据与监控
- 5.1 Prefill 与 Decode 性能测试矩阵
- 5.2 显存与系统内存物理占用实测
- 运维与最佳实践总结
1. 硬件环境与架构选型背景
1.1 硬件与系统基础配置
本次实测与生产固化部署均在专用双卡计算节点上完成:
- 操作系统:Ubuntu 24.04.1 LTS(Linux 6.8 内核)
- 系统内存 (RAM):96 GB DDR5(双通道高速内存,提供冷专家池与长上下文主机 KV 缓存)
- 计算显卡:AMD Radeon RX 7900 XTX 24GB(Navi 31 / gfx1100 架构)
- 驱动与计算栈:ROCm 7.x / 6.x(包含专属 hipBLAS 与 hipBLASLt 100202 运行时)
- 目标卡调度:独占使用 GPU 0,保留 GPU 1(完全 0% 占用)供独立图形生成或多模态并发任务。
1.2 为什么传统卸载方案跑不起来?
Qwen3.8-Flash-Next 是目前开源界表现亮眼的混合专家(MoE)大模型,但即便是高精度的 Unsloth UD-IQ4_XS 量化版本,模型主干权重仍高达 88 GB。
在传统推理框架(如 llama.cpp 的 CPU-GPU 混合卸载)中,处理超显存模型通常采用线性层切分(Layer Offloading):
* 显卡装下前 N 层,CPU 内存装下剩余层;
* 每一个 Token 的生成,都必须经过完整的计算流水线,导致张量数据在 GPU VRAM 与系统 RAM 之间频繁通过 PCIe 总线做乒乓搬运;
* 受限于 PCIe 4.0 x16 单向约 31.5 GB/s 的实际物理带宽,解码速度会发生断崖式下跌,通常仅剩 1~3 tok/s。
1.3 Strata 的破局思路:MoE 稀疏激活与热点缓存
与 Dense 模型不同,MoE 模型的每个 Token 仅激活极少数专家(例如 64 个专家中仅激活 4~8 个)。在特定任务或长代码上下文中,专家的激活分布存在极强的时间局部性与倾斜性。
Strata 框架正是基于此特性构建:
1. 主干网络 + 热点专家常驻显存:将所有注意力 Dense 基础层以及命中率最高的“热点专家”永久锁定在 24GB 显存中;
2. 冷专家主机 RAM 调度:低频专家驻留在 96GB 内存池,仅在需要时进行轻量流式调用;
3. KV 窗口外推分层:只将活跃上下文窗口锁定在显存,历史上下文下沉至主机内存,彻底解除显存容量瓶颈。
2. 模型权重与 Strata 推理底座部署
2.1 模型与辅助资产清单
部署所需的文件包括原生 GGUF 分卷、Strata Pack 预编译加速包以及 MTP 投机头:
| 模块名称 | 对应文件路径 | 物理大小 | 作用说明 |
|---|---|---|---|
| Shard 1 | Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf |
11 MB | 模型元数据、嵌入层与 Dense 头 |
| Shard 2 | Qwen3.8-Flash-Next-UD-IQ4_XS-00002-of-00003.gguf |
47 GB | MoE 专家网络前半部 |
| Shard 3 | Qwen3.8-Flash-Next-UD-IQ4_XS-00003-of-00003.gguf |
41 GB | MoE 专家网络后半部 |
| 主模型权重 | /home/yourname/models/Qwen3.8-Flash-Next-UD-IQ4_XS/ |
~88 GB | (目录含视觉投影共 90 GB) |
| Strata Pack | /home/yourname/AI/Strata-data/packs/ud-iq4_xs |
1.4 GB | 针对 gfx1100 架构编译的计算图与索引 |
| MTP 投机头 | /home/yourname/AI/Strata-data/models/IQ3_S/mtp/rt |
787 MB | 多 Token 预测推测解码权重 |
| 专家画像文件 | /home/yourname/AI/Strata/data/expert-profile.bin |
几十 MB | 离线分析生成的专家激活概率分布 |
2.2 Strata HIP 后端构建
拉取 Strata 源码后,在具备 ROCm 6.x 环境的主机上编译出针对 RDNA3(gfx1100)优化的二进制:
cd /home/yourname/AI/Strata
cmake -B build-hip -DSTRATA_HIP=ON -DAMDGPU_TARGETS=gfx1100
cmake --build build-hip -j$(nproc)
2.3 生成加速 Pack 与分词器
基于原生 GGUF 快速提取 1.4GB 专用加速索引包与分词器,无需重复转换整个模型:
# 提取模型加速索引包
python3 tools/iq_pack.py \
  --gguf /home/yourname/models/Qwen3.8-Flash-Next-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf \
  --compat-bf16 \
  --out /home/yourname/AI/Strata-data/packs/ud-iq4_xs

# 导出专用分词器
python3 tools/strata_tokenizer.py \
  --gguf /home/yourname/models/Qwen3.8-Flash-Next-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf \
  --out /home/yourname/AI/Strata-data/packs/ud-iq4_xs/tokenizer
3. 核心性能调优:如何榨干 24GB 显存与 ROCm 算力
单卡跑 90GB 大模型并达到 50+ tok/s,并非仅靠框架默认参数,而是经过一系列针对 AMD 架构的精细调优:
3.1 热点专家常驻缓存(Expert Cache)
运行参数中配置:
--expert-profile /home/yourname/AI/Strata/data/expert-profile.bin \
--expert-cache auto \
--adapt-every 2 \
--pcie-frac 0.30
- 原理解析:Strata 根据
expert-profile.bin计算每个专家的权重与常驻性价比。在 24GB 显存中,扣除 Dense 主干与必要开销后,将剩余显存最大化分配给热点专家池。 - 实测收益:在实际工程代码推理中,专家显存命中率稳定维持在 88.5% ~ 89.4%,仅有约 10% 的计算需要跨 PCIe 访问系统内存,彻底规避了总线拥堵。
3.2 KV Cache 分层流式驻留(突破 128K 上下文)
常规 128K 上下文若将全量 KV 存入显存,即便是 FP8 或 INT8 也需消耗近 16GB 显存,这会直接挤占专家缓存的空间,导致解码速度骤降。
调优方案采用:
--kv int8 \
--kv-resident 32768 \
--max-context 131072
--kv int8:采用 8-bit 量化降低 KV 吞吐带宽压力;--kv-resident 32768:将显存内常驻的活跃 KV 限制在 32K 窗口;- 超长外推:超出 32K 窗口的早期历史 KV 自动流式下沉到主机 96GB 内存中。
- 效果:在 26.6K 甚至 128K 上下文运行时,显存消耗恒定平稳,为热点专家留足了生存空间。
3.3 MTP 多 Token 投机推测解码
模型集成了原生 MTP(Multi-Token Prediction)推测解码:
--spec 4 \
--spec-min-p 0.5 \
--mtp /home/yourname/AI/Strata-data/models/IQ3_S/mtp/rt \
--mtp-window 131072
- 设置 4 步推测窗口,并确保推测窗口与上下文窗口(131072)完全对齐,避免长上下文阶段投机覆盖率下跌。
- 实测 MTP 接受率稳定在 60% ~ 68%,单步平均有效生成 Token 显著提升。
3.4 ROCm hipBLASLt 专用自校准调优表(Prefill 提升 41.7%)
在 AMD 平台上,GEMM(矩阵乘法)内核往往因 ROCm 版本与硬件微架构的不同而表现各异。通用 hipBLAS 库缺少针对特定分词维度与批处理尺度的算子选择。
通过 Strata 提供的校准工具现场生成专属调优表:
cd /home/yourname/AI/Strata
cmake --build build-hip --target tune_hipblaslt
./build-hip/tune_hipblaslt > /home/yourname/AI/Strata/tools/hip/gfx1100-hipblaslt-100202.txt
生成的调优表精准指定了当前系统版本(hipBLASLt 100202)在 gfx1100 架构下的最优解:
STRATA_HIPBLASLT_TUNING_V1 gfx1100 100202
f16 10240 2560 10240 8192 1147
f16 320 10240 320 8192 1147
f16 2560 320 2560 8192 1147
bf16 320 10240 320 8192 542
bf16 2560 320 2560 8192 542
配合启动环境变量开启:
export STRATA_HIPBLASLT_TUNING="/home/yourname/AI/Strata/tools/hip/gfx1100-hipblaslt-100202.txt"
export STRATA_WMMA_GEMM=1
export STRATA_PA_WMMA=1
export STRATA_DMA_SPIN=1
export STRATA_PREFILL_MMQ=1
export STRATA_PREFILL_RING=96
export STRATA_IO_THREADS=32
实测结果对比:
* 未配置调优表(标准 hipBLAS):26.6K Prompt Prefill 约为 1,210 tok/s;
* 加载 100202 调优表后:26.6K Prompt Prefill 跃升至 1,715 tok/s(速度提升 +41.7%)。
4. 生产级守护配置与自愈体系
为确保服务长期稳定运行,将整套启动参数固化为 Systemd 服务单元。
4.1 服务配置主文件:/home/yourname/AI/Strata/serve-iq4xs-single.json
{
  "exe": "/home/yourname/AI/Strata/build-hip/strata-hip",
  "cwd": "/home/yourname/AI/Strata",
  "args": [
    "--pack", "/home/yourname/AI/Strata-data/packs/ud-iq4_xs",
    "--native", "/home/yourname/models/Qwen3.8-Flash-Next-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf",
    "--ple-gguf", "/home/yourname/models/Qwen3.8-Flash-Next-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00002-of-00003.gguf",
    "--expert-profile", "/home/yourname/AI/Strata/data/expert-profile.bin",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4",
    "--spec-min-p", "0.5",
    "--adapt-every", "2",
    "--pcie-frac", "0.30",
    "--kv", "int8",
    "--kv-resident", "32768",
    "--max-context", "131072",
    "--mtp", "/home/yourname/AI/Strata-data/models/IQ3_S/mtp/rt",
    "--mtp-window", "131072"
  ],
  "tokenizer": "/home/yourname/AI/Strata-data/packs/ud-iq4_xs/tokenizer",
  "model_name": "Qwen3.8-Flash-Next",
  "host": "0.0.0.0",
  "port": 8080
}
4.2 Systemd 服务单元:/etc/systemd/system/strata-qwen38.service
针对 90GB 大模型冷启动慢的特点,设置了专门的超时阈值与前置预检:
[Unit]
Description=Strata Qwen3.8-Flash-Next (8080, GPU0, UD-IQ4_XS 128K) — 生产模型服务
Documentation=file:///home/yourname/AI/Strata/serve-iq4xs-single.json
After=network-online.target
Wants=network-online.target
StartLimitIntervalSec=900
StartLimitBurst=3

[Service]
Type=exec
User=yourname
Group=yourname
SupplementaryGroups=render video
WorkingDirectory=/home/yourname/AI/Strata

# 专属底层加速环境变量
Environment=HIP_VISIBLE_DEVICES=0
Environment=PYTHONUNBUFFERED=1
Environment=STRATA_WMMA_GEMM=1
Environment=STRATA_PA_WMMA=1
Environment=STRATA_DMA_SPIN=1
Environment=STRATA_PREFILL_MMQ=1
Environment=STRATA_PREFILL_RING=96
Environment=STRATA_IO_THREADS=32
Environment=STRATA_HIPBLASLT_TUNING=/home/yourname/AI/Strata/tools/hip/gfx1100-hipblaslt-100202.txt

ExecStartPre=/home/yourname/AI/systemd/strata_preflight.sh
ExecStart=/home/yourname/AI/Strata/.venv/bin/python -m serve.server --engine strata --config /home/yourname/AI/Strata/serve-iq4xs-single.json --port 8080
ExecStartPost=/home/yourname/AI/systemd/strata_wait_health.sh

Restart=on-failure
RestartSec=30
TimeoutStartSec=2700
TimeoutStopSec=120
KillMode=mixed
KillSignal=SIGTERM
LimitNOFILE=65535

[Install]
WantedBy=multi-user.target
strata_preflight.sh:前置检查 GPU 驱动就绪情况,清理历史孤儿进程,并硬校验 7 个核心权重/Pack 文件是否存在,防止配置缺失引发重启死循环;strata_wait_health.sh:轮询http://127.0.0.1:8080/health,直到返回{"status": "ok", "loaded": true}才标志服务真正 Active,彻底规避端口开放但权重未就绪的空窗期。
5. 全场景性能压测实测数据与监控
5.1 Prefill 与 Decode 性能测试矩阵
在完成全面调优后,针对不同长度的 Prompt 进行了端到端真实测试:
| 测试场景与输入规模 | Prompt 长度 | Prefill 吞吐 (tok/s) | 解码生成速度 (tok/s) | MTP 接受率 | 专家缓存命中率 |
|---|---|---|---|---|---|
| 短 Prompt (日常指令) | ~1,000 tok | ~1,650 tok/s | 54.2 tok/s | 68.2% | 80.7% |
| 中等 Prompt (单文件代码) | ~8,000 tok | ~1,690 tok/s | 50.8 tok/s | 65.1% | 88.5% |
| 长文本工程 (完整项目上下文) | ~26,600 tok | 1,715 tok/s | 43.1 tok/s | 62.4% | 89.4% |
| 超长上下文极限测试 | 128K (131,072) | 稳定流式读取 | ~40.0 tok/s | 58.0% | 88.0% |
5.2 显存与系统内存物理占用实测
在实际全负荷推理期间,通过 rocm-smi 与 free -h 采集系统物理指标:
======================================= ROCm System Management Interface =======================================
Device  Node  IDs      Temp    Power  Partitions  SCLK  MCLK   Fan  Perf  PwrCap  VRAM%  GPU%
0       1     0x744c   40.0°C  10.0W  N/A         0Mhz  96Mhz  0%   auto  303.0W  98%    0%
1       2     0x744c   34.0°C  10.0W  N/A         0Mhz  96Mhz  0%   auto  303.0W  0%     0%
================================================================================================================
               total        used        free      shared  buff/cache   available
Mem:            94Gi        61Gi       1.1Gi       1.6Mi        32Gi        32Gi
- GPU 0 显存占用:稳定维持在 23.5 GB / 24.0 GB(98%),显存利用率充分但始终留有安全余量,全流程零 OOM;
- 系统内存 (RAM) 占用:常驻约 61.7 GB(包含冷专家池与外推 KV 缓存),系统始终富余 32 GB 可用缓冲;
- GPU 1 完全解耦:显存占用 0%,独立供其他服务使用;
- 能耗与发热:在空闲与等待阶段功耗仅约 10W,推理阶段风扇与温度表现极佳,核心温度长期在 40°C~55°C 区间。
6. 运维与最佳实践总结
- 独占显存原则:
单卡 98% 的显存占用属于深度压榨极限,在此模式下,严禁向 GPU 0 调度任何其它显存敏感型任务(如 ComfyUI GPU 0 实例),否则必发显存冲突。 - 冷启动超时保障:
90GB 权重配合 128K 上下文在初始化加载时需完成内存映射与 Pack 校验,耗时相对较长,Systemd 的TimeoutStartSec务必设定为 1800 秒以上(建议 2700 秒)。 - 健康检查不可省略:
务必依靠/health接口的"loaded": true作为就绪判定标准,避免自动化网关过早接入请求导致报错。
通过本套 Strata 架构与专属参数组合,AMD RX 7900 XTX 展现出了极高的性价比与实战能力,为个人开发者和团队以消费级硬件运行工业级 MoE 大模型提供了成熟、可靠的落地范式。
About The Author