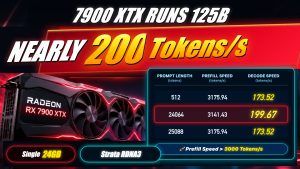
Real-world coding and token processing benchmark comparing 125B MoE...
llama.cpp
Deploy Bonsai 2 27B PQ2_0 on an RTX 3060...
Can a 7.2GB 27B model handle real code-agent work?...
Benchmark & deployment guide for Qwen 3.8 125B on...
A hands-on guide to transforming spare PCs into dedicated...
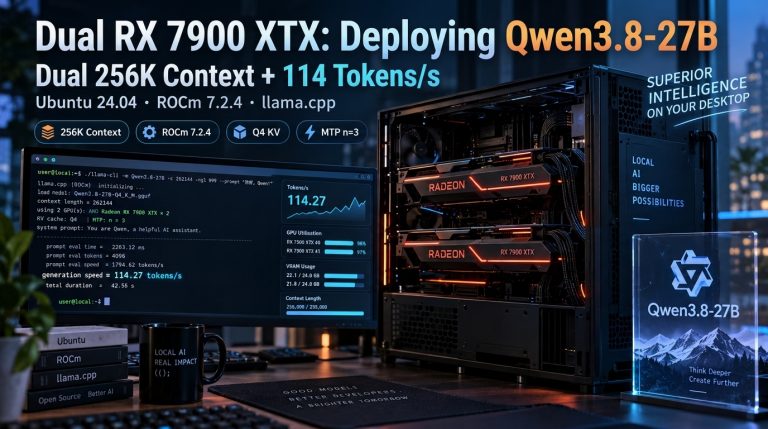
How to deploy Qwen3.8-27B across dual AMD Radeon RX...
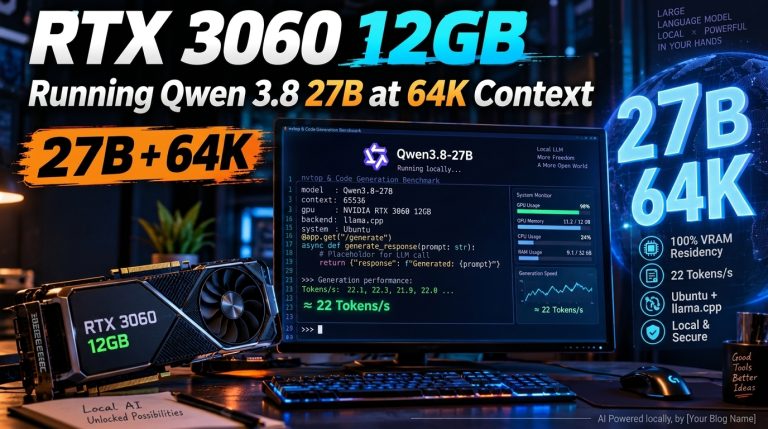
Running Qwen 3.8 27B on RTX 3060 12GB: 64K...
Run 125B MoE on a Single 24GB GPU &...
Deploy Qwen 3.8 27B on AMD Radeon RX 7900...